Python面向对象编程核心概念与实战入门
本文深入解析Python中的面向对象编程(OOP)核心概念,详细阐述类与对象的定义、区别及关系。通过代码示例演示如何定义包含方法的类、创建对象实例以及调用属性与方法,并探讨面向对象设计与编程在Python中的实际应用与优势,帮助开发者掌握OOP思维以解决软件复用问题。
2026-10-14
20

本文深入解析Python中的面向对象编程(OOP)核心概念,详细阐述类与对象的定义、区别及关系。通过代码示例演示如何定义包含方法的类、创建对象实例以及调用属性与方法,并探讨面向对象设计与编程在Python中的实际应用与优势,帮助开发者掌握OOP思维以解决软件复用问题。
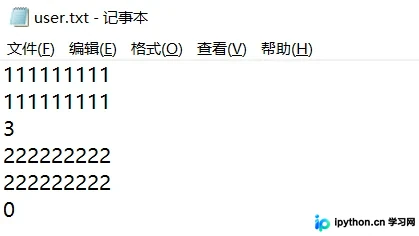
本文通过Python文件读写操作,实现一个完整的用户登录模拟系统。核心功能包括:验证账号是否存在、检查账户是否因多次错误被锁定(超过三次)、校验密码正确性,并在登录成功时重置错误计数。系统支持密码错误后的重试机制及手动退出,最终将更新后的错误次数写回本地文本文件,确保状态持久化。
本文详细介绍在PyCharm中进行Debug调试时如何实时查看数据操作。涵盖设置断点、启动Debug模式、使用Step Over/Into单步执行,以及通过Console开启Python Prompt实现交互式变量查看。此外,补充了无需Debug即可通过编辑配置勾选“用控制台运行”来查看变量的方法,帮助开发者更高效地排查代码问题。

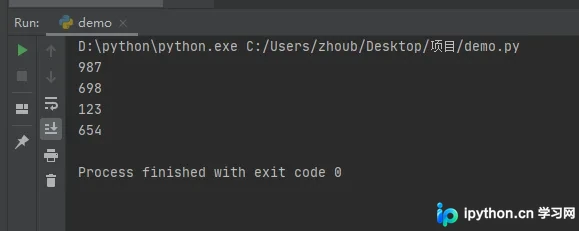
本文介绍Python中输出整数的两种常用方法。第一种通过str()将数字转为字符串并检查是否包含小数点来筛选整数;第二种利用浮点数精度格式化(如%.0f)实现四舍五入输出。文章包含具体代码示例及执行结果分析,帮助开发者根据需求选择合适方案。
本文详细介绍如何在Python环境中连接HDFS,实现文件的读取与写入。通过安装pyhdfs模块,演示了从HDFS读取二进制数据流并转换为CSV,以及利用Pandas将文本文件处理为Dataframe并导出为CSV的具体代码。涵盖Python 3.6与Hadoop 2.9环境下的实际操作步骤,包括本地文件上传至HDFS的方法,为大数据处理提供基础支持。
本文介绍如何使用Python Matplotlib库对图表坐标轴进行精细化控制。内容涵盖设置坐标轴标签的字体大小与颜色、调整纵轴显示范围、自定义横轴刻度标签(如数学符号)、将坐标轴移动至图表中心以及设置刻度标签倾斜角度。通过具体代码示例,帮助开发者掌握Matplotlib中plt和ax对象对坐标轴的常用操作技巧。
本文详解Python中def定义函数及调用方式,强调参数个数与顺序需一一对应。重点解析List作为全局变量在函数中可直接修改而无需global声明的原理:赋值操作b[0]=2无歧义,若为局部变量会报KeyError,故默认引用全局对象。
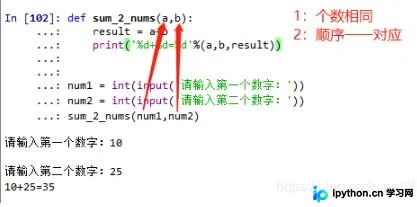
本文详解Python中如何在外部调用函数内部定义的嵌套函数,通过返回内部函数引用实现灵活调用。同时探讨在函数内处理列表或矩阵时,如何避免修改原数据的问题,提供字典转列表及引入numpy库两种解决方案,确保原数据结构不受影响。
本文介绍使用Python pandas库将数据写入Excel文件的两种常用方法。通过to_excel()可直接保存单个DataFrame;若需向现有工作簿添加多个Sheet,则需结合ExcelWriter()打开文件并逐个写入数据,最后调用save()保存。
本文介绍如何在Django中通过定义抽象基类实现模型字段复用,并深入解析如何重写Manager类的filter方法以自动过滤is_active字段。通过继承BaseManager并重写核心查询逻辑,开发者可统一数据访问层行为,减少冗余代码,提升代码的Pythonic程度与维护效率。
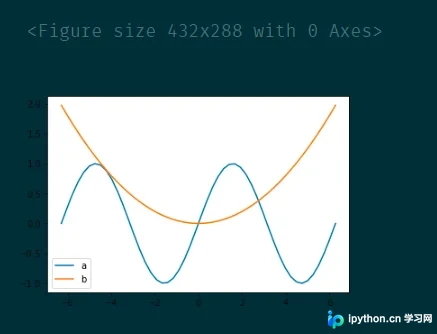
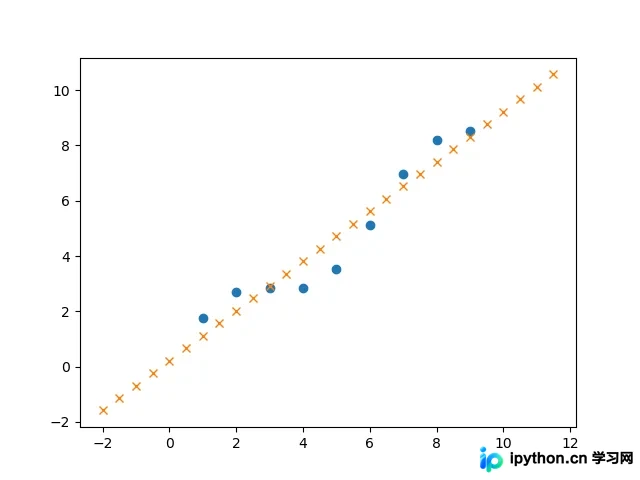
本文介绍如何使用Python的numpy模块进行数据序列的回归预测。通过np.polyfit函数实现1阶、2阶及3阶多项式拟合,并利用matplotlib绘制预测效果图。文章重点解析拟合阶数选择对模型效果的影响,指出高阶拟合可能导致过拟合问题,建议根据实际数据特征选择合适的模型阶数。
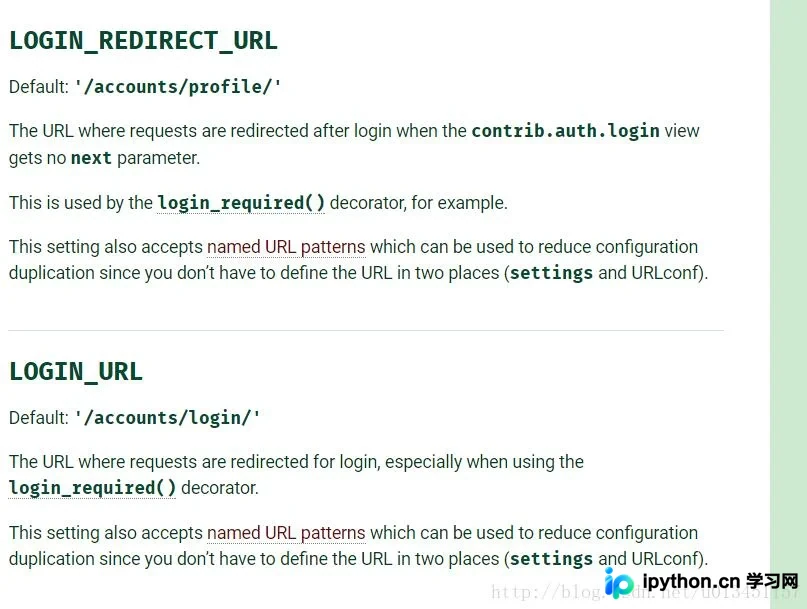
本文介绍如何在Django中通过创建Profile应用来扩展User模块,包括定义UserProfile模型、配置Admin后台以及设置AUTH_PROFILE_MODULE。同时提供解决登录跳转至accounts/profile/的问题,通过配置LOGIN_REDIRECT_URL指定自定义首页路径,确保用户登录后正确跳转。