pandas DataFrame检测重复值与去重方法详解
本文详细介绍pandas中DataFrame检测重复值的方法,包括duplicated函数的subset、keep参数用法及示例,以及如何通过布尔索引查询和统计重复记录个数。
2026-10-14
22

本文详细介绍pandas中DataFrame检测重复值的方法,包括duplicated函数的subset、keep参数用法及示例,以及如何通过布尔索引查询和统计重复记录个数。
本文详解 Python 读取大文件时常见的内存溢出问题,对比 read()、readlines() 与迭代器的性能差异,并提供正确的分块读取代码。同时介绍 memory_profiler 和 guppy 两个内存监控工具的安装与使用方法,帮助开发者高效排查内存占用。
本文介绍如何使用Python的crypt模块模拟Linux密码加密机制,通过读取/etc/shadow文件提取盐值和哈希值,结合密码字典进行暴力破解。文章详细解析了SHA-512等哈希算法格式,并提供了完整的Python脚本代码及运行示例,适用于Kali Linux环境下的安全测试。
本文详解Python中None与NULL的区别,指出Python仅有None且拥有NoneType类型。通过对比None、False、0及空集合在布尔语境下的表现,分析`if X is None`与`if not X`的判断差异,推荐在需要精确区分时使用`is not None`写法,避免误判。
本文深入解析Python中NoneType类型的判断方法,对比is None与== None的性能差异,详解None对象的特性、属性及与其他数据类型的区别,并提供三种判断变量是否为None的最佳实践。
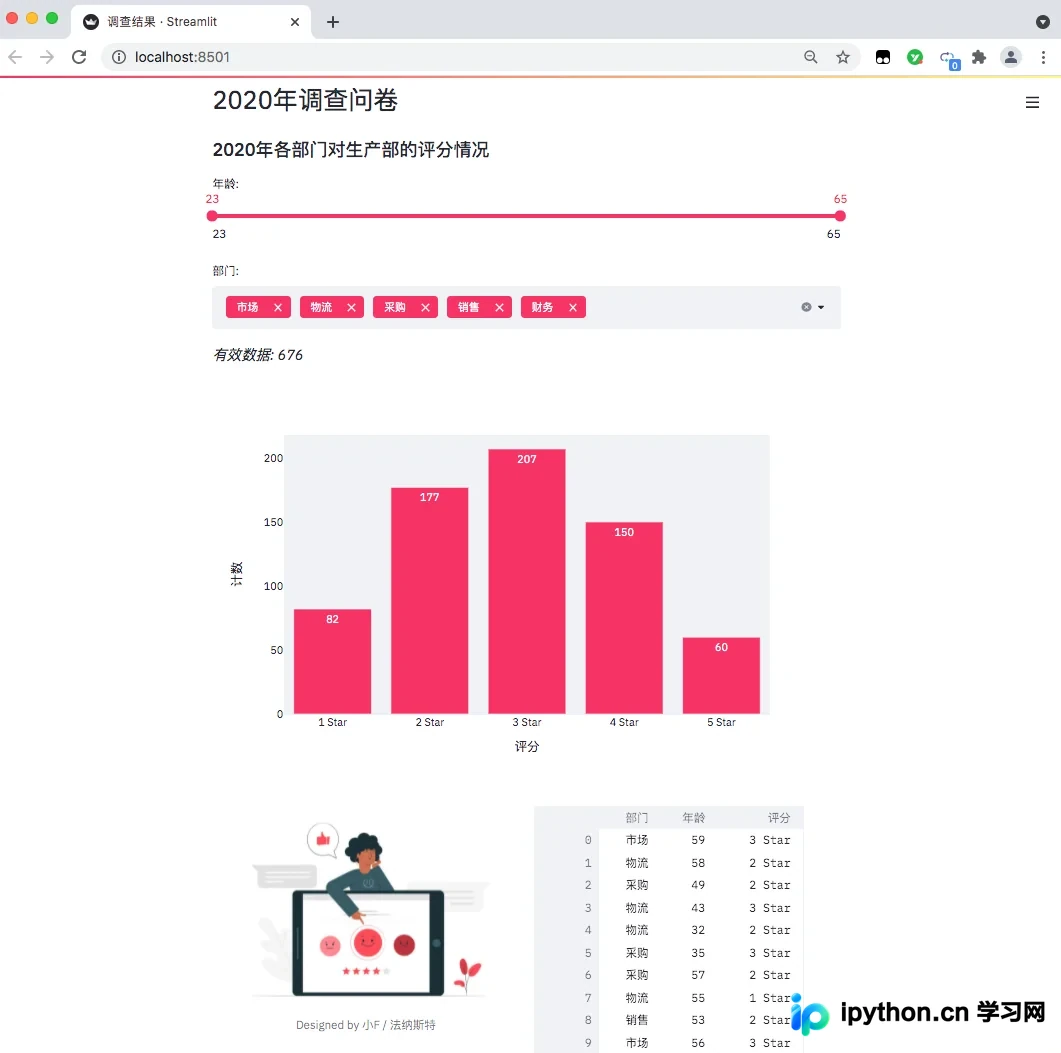
本文详细介绍如何使用Python的Streamlit库快速构建交互式Web可视化页面。通过结合pandas处理Excel数据、plotly绘制动态图表,实现了基于滑动条和复选框的数据过滤与实时展示。教程涵盖环境配置、代码实现及本地部署步骤,帮助开发者轻松创建无需前端知识的数据应用。
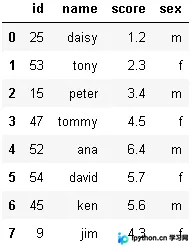
本文介绍在pandas中处理DataFrame时,因数据排序或筛选导致索引顺序混乱的几种重置方法。通过具体示例演示直接赋值、reset_index、reindex及set_index四种方式,帮助开发者高效恢复从0开始的连续整数索引,适用于数据清洗与预处理场景。
本文详细介绍在 pandas 中如何高效处理 DataFrame 数据。涵盖按列、索引及特定行列的选取方法,包括 loc、iloc 等核心属性;讲解基于单一或多条件的行记录筛选技巧;演示将分类变量如性别进行数值替换的两种常用方式;最后提供删除特定条件行的操作示例,帮助开发者快速掌握数据预处理关键步骤。
本文深入探讨Python3中读取文件指定行的三种主流方案。针对大文件场景,对比了基于readline的逐行遍历、linecache模块以及调用系统sed命令的执行效率。测试显示,读取5000万行时,sed方案耗时仅约2.5秒,显著优于纯Python实现的10秒以上耗时,为高性能数据处理提供了实用参考。
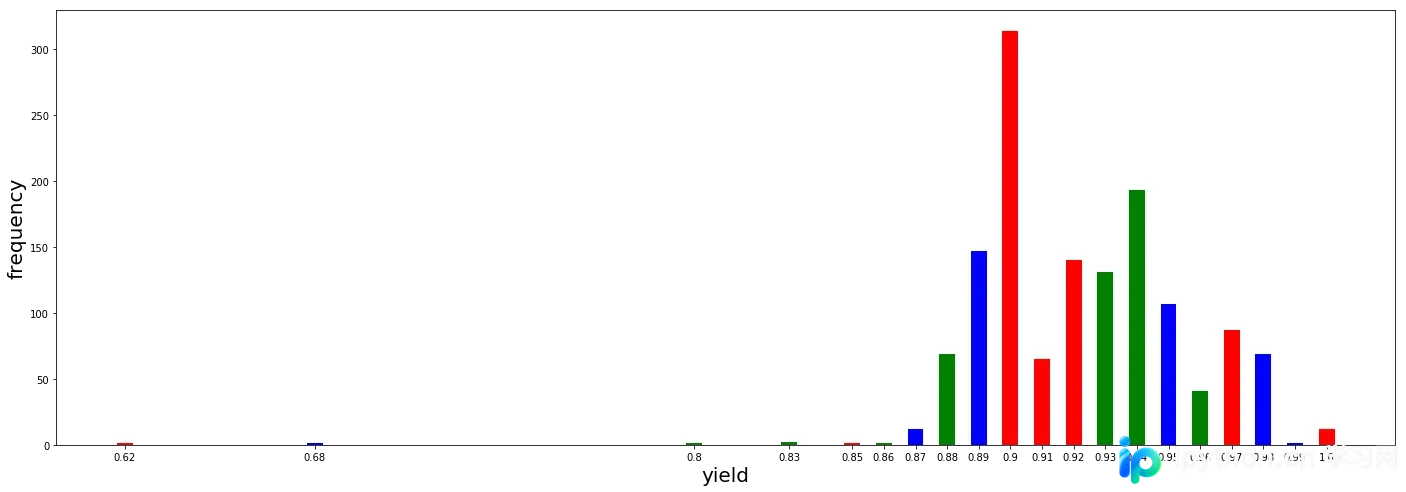
本文基于 Python 3.6 及 Anaconda 环境,详细解析 matplotlib 库中 plt.bar() 函数的各项参数。通过加载 pandas 数据并逐步设置颜色、宽度、标签及字体等属性,展示如何绘制专业的柱状图。内容涵盖基础库导入、数据预处理及图表美化技巧,适合需要掌握数据可视化基础的用户参考。
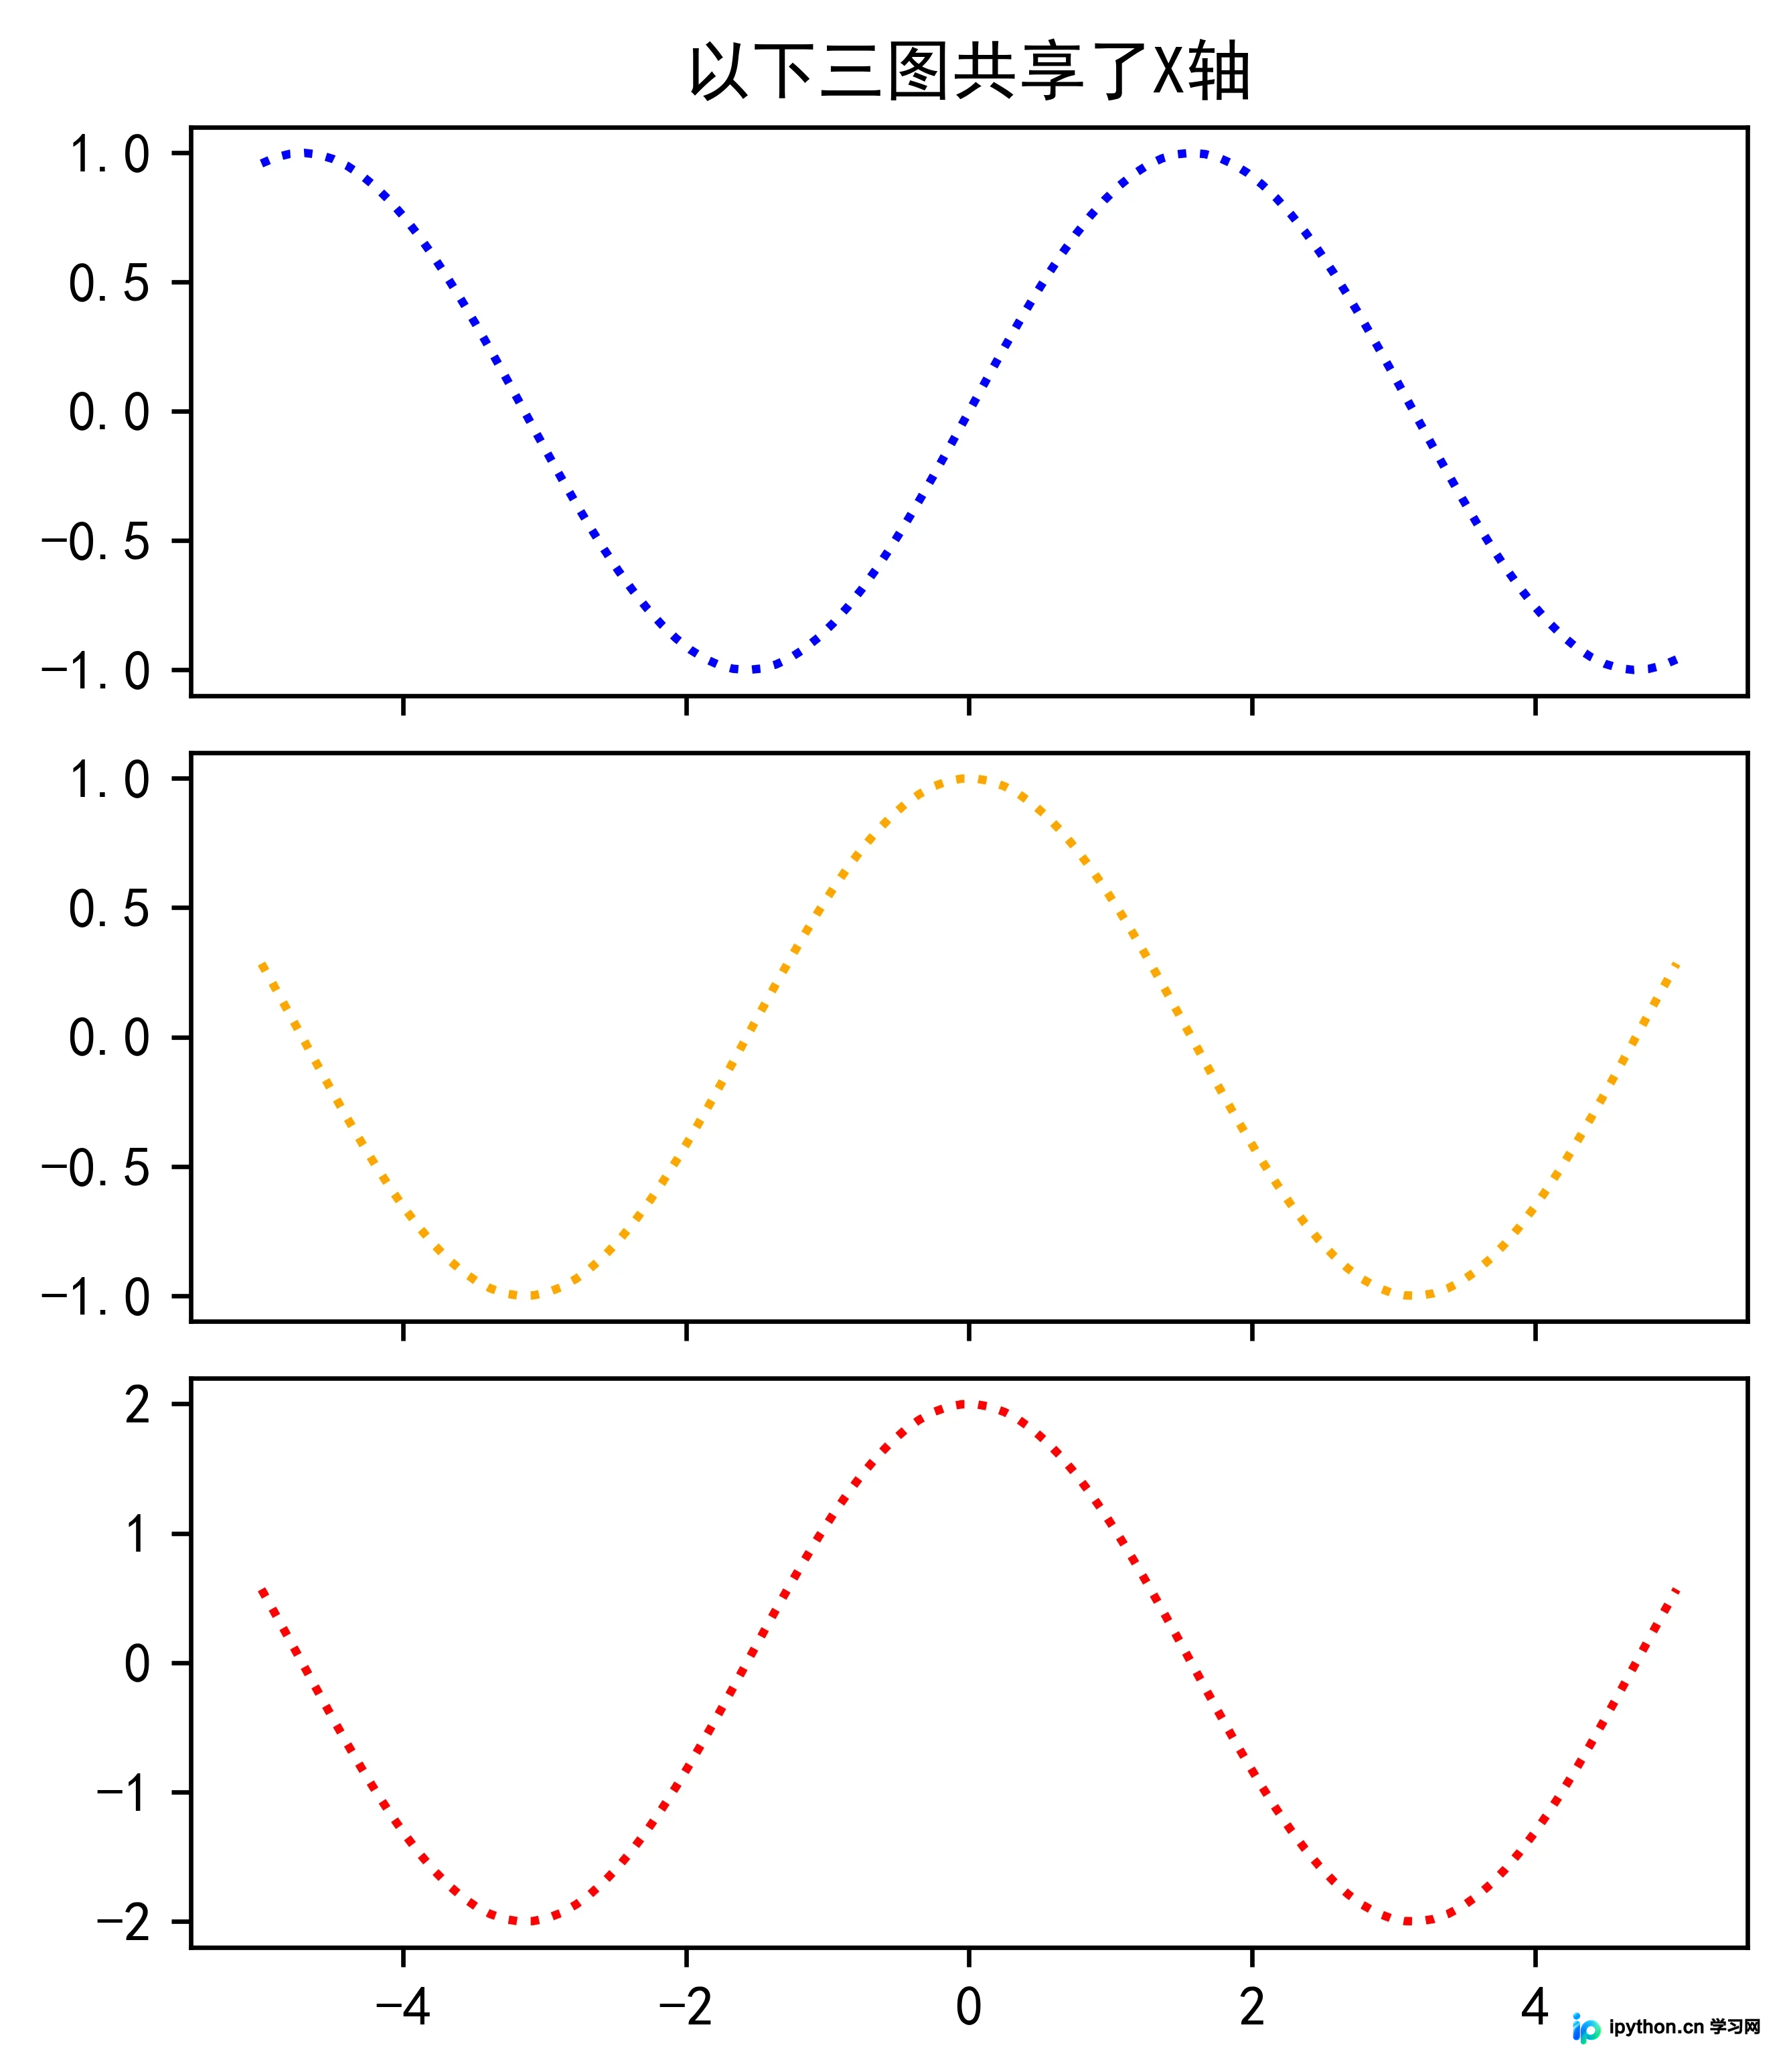
本文详细介绍如何在matplotlib中使用subplots函数实现子图间的坐标轴共享。通过解析sharex和sharey参数,演示如何创建共享X轴、Y轴或同时共享两者的多子图图表,并包含调整子图间距及混合绘图类型的实际代码示例。
本文详解高斯模糊原理,介绍如何使用Python的OpenCV库生成随机高斯模糊图片。通过调整高斯矩阵尺寸和标准差控制模糊程度,并结合random库实现随机化生成,提供完整代码示例与参数说明。