

Python 大文件读取内存溢出排查与优化指南

本文详解 Python 读取大文件时常见的内存溢出问题,对比 read()、readlines() 与迭代器的性能差异,并提供正确的分块读取代码。同时介绍 memory_profiler 和 guppy 两个内存监控工具的安装与使用方法,帮助开发者高效排查内存占用。
查看相关代码示例。
import gc
for x in list(locals().keys())[:]:
    del locals()[x]
# del all_s_x, AE, AE_split, x_ticks, split
gc.collect()
补充说明:Python 读取大文件时容易遇到的陷阱以及如何进行内存占用检测。
Python 中读写文件的 API 虽然简洁,但稍有不慎便可能陷入性能或内存陷阱。本文记录了一次实际的踩坑经历,并总结了几点建议,旨在帮助开发者在使用 Python 时规避潜在的隐患代码。
1. read() 与 readlines() 的潜在风险:
在搜索 Python 文件读写教程时,经常能看到 read() 和 readlines() 这对函数被频繁使用。因此,我们常会见到如下代码片段:
with open(file_path, 'rb') as f:
    sha1Obj.update(f.read())
或者
with open(file_path, 'rb') as f:
    for line in f.readlines():
        print(line)
对于小文件,上述方法通常不会引发异常;然而,一旦尝试读取大文件,极易触发 MemoryError(内存溢出错误)。
为什么会发生内存错误?
首先,我们来分析这两个方法的具体行为:
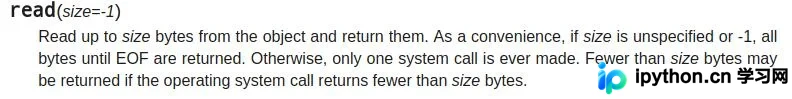
当 read() 方法的默认参数 size=-1 时,它会尝试读取文件直到 EOF(文件末尾)。如果文件大小超过了系统可用内存,自然会抛出内存溢出错误。
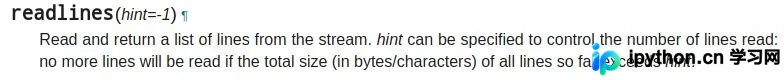
同样地,readlines() 会构建一个包含所有行的 list 对象。由于使用的是 list 而非迭代器,所有数据都会驻留在内存中,因此同样会导致内存溢出。
2. 正确的读取方式:
在实际生产系统中,使用上述方法是非常危险的,这种陷阱往往隐蔽且难以察觉。接下来介绍正确的用法,其实很简单,只需遵循 API 文档中的描述进行编码即可:
如果是处理二进制文件,推荐使用以下写法,可以指定缓冲区的大小(byte)。显然,缓冲区越大,读取速度通常越快。
with open(file_path, 'rb') as f:
    while True:
        buf = f.read(1024)
        if buf:
            sha1Obj.update(buf)
        else:
            break
如果是处理文本文件,可以使用 readline() 方法或直接对文件对象进行迭代(Python 在此处封装了语法糖,两者的底层逻辑一致,但直接迭代文件的写法更符合 Pythonic 风格)。每次读取一行的效率相对较低。笔者进行了简单测试,在 3GB 文件的情况下,其性能大约比分块读取方式低 20%。
with open(file_path, 'rb') as f:
    while True:
        line = f.readline()
        if buf:
            print(line)
        else:
            break
with open(file_path, 'rb') as f:
    for line in f:
        print(line)
3. 内存检测工具介绍:
针对 Python 代码的内存占用问题,对代码进行实时监控是非常必要的。这里推荐两个用于检测 Python 代码内存占用的工具。
memory_profiler首先,通过 pip 安装 memory_profiler:
pip install memory_profilermemory_profiler 基于 Python 的装饰器机制工作,因此需要在待测试的函数上添加相应的装饰器。
from hashlib import sha1
import sys
@profile
def my_func():
    sha1Obj = sha1()
    with open(sys.argv[1], 'rb') as f:
        while True:
            buf = f.read(10 * 1024 * 1024)
            if buf:
                sha1Obj.update(buf)
            else:
                break
    print(sha1Obj.hexdigest())
if __name__ == '__main__':
    my_func()
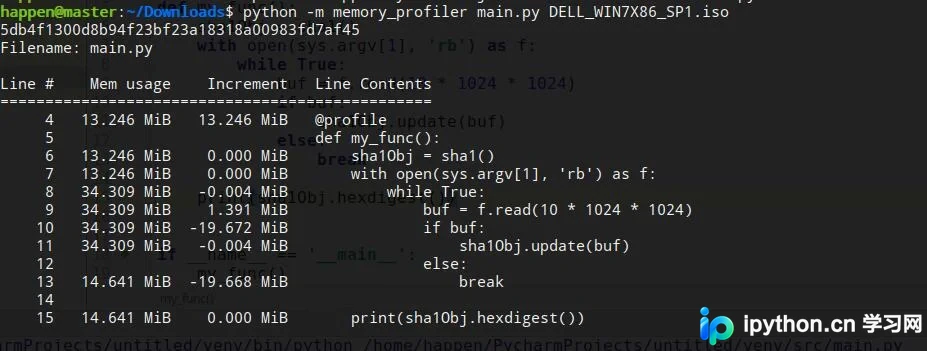
随后,在运行代码时加上参数 -m memory_profiler:
这样就可以查看函数中每一步代码的内存占用情况。
guppy 工具:
同样地,首先通过 pip 安装 guppy:
pip install guppy之后可以在代码中利用 guppy 直接打印出各种 Python 类型(如 list、tuple、dict 等)分别创建了多少对象,以及它们占用了多少内存。
from guppy import hpy
import sys
def my_func():
    mem = hpy()
    with open(sys.argv[1], 'rb') as f:
        while True:
            buf = f.read(10 * 1024 * 1024)
            if buf:
                print(mem.heap())
            else:
                break
如下图所示,可以看到打印出的具体内存占用数据:
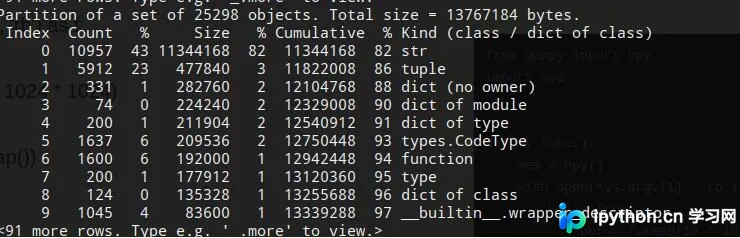
通过上述两种工具 guppy 和 memory_profiler,可以有效地监控 Python 代码运行时的内存占用问题。
4. 小结:
Python 是一门崇尚简洁的语言,但正是这种简洁性使得代码中隐藏了许多需要仔细推敲和思考的细节。希望大家在日常工作和学习中,多对细节进行总结,少踩一些不必要的“坑”。
以上为个人经验总结,希望能给大家提供参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









