详细指南:如何使用多种方法列出已安装的Python包
列出已安装的 Python 包有助于快速审计项目依赖或排查环境冲突。本文详细演示如何通过 pip 命令行、Python 内置模块、依赖可视化工具以及 Jupyter 等常见开发环境,准确获取安装包列表及其版本信息,并提供对应的参数设置与结果核对方法。
2026-10-11
23

列出已安装的 Python 包有助于快速审计项目依赖或排查环境冲突。本文详细演示如何通过 pip 命令行、Python 内置模块、依赖可视化工具以及 Jupyter 等常见开发环境,准确获取安装包列表及其版本信息,并提供对应的参数设置与结果核对方法。
本文详解Python中向集合添加数据的标准做法。通过内置的add()方法可安全插入单个唯一值,利用update()方法支持从列表等可迭代对象批量导入元素。文章涵盖具体代码示例、字符串传入时的常见陷阱及规避方案,帮助开发者快速掌握集合扩容与去重操作。
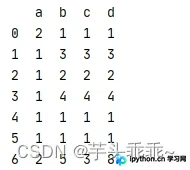
Pandas 提供的 drop_duplicates() 方法专为 DataFrame 数据去重设计。通过调整 subset 指定查重范围、keep 控制保留策略以及 inplace 决定修改方式,可灵活清理冗余记录。本文结合标准示例数据,逐步演示默认去重、全量剔除、单列或多列组合去重的完整操作逻辑,助力高效完成数据预处理。
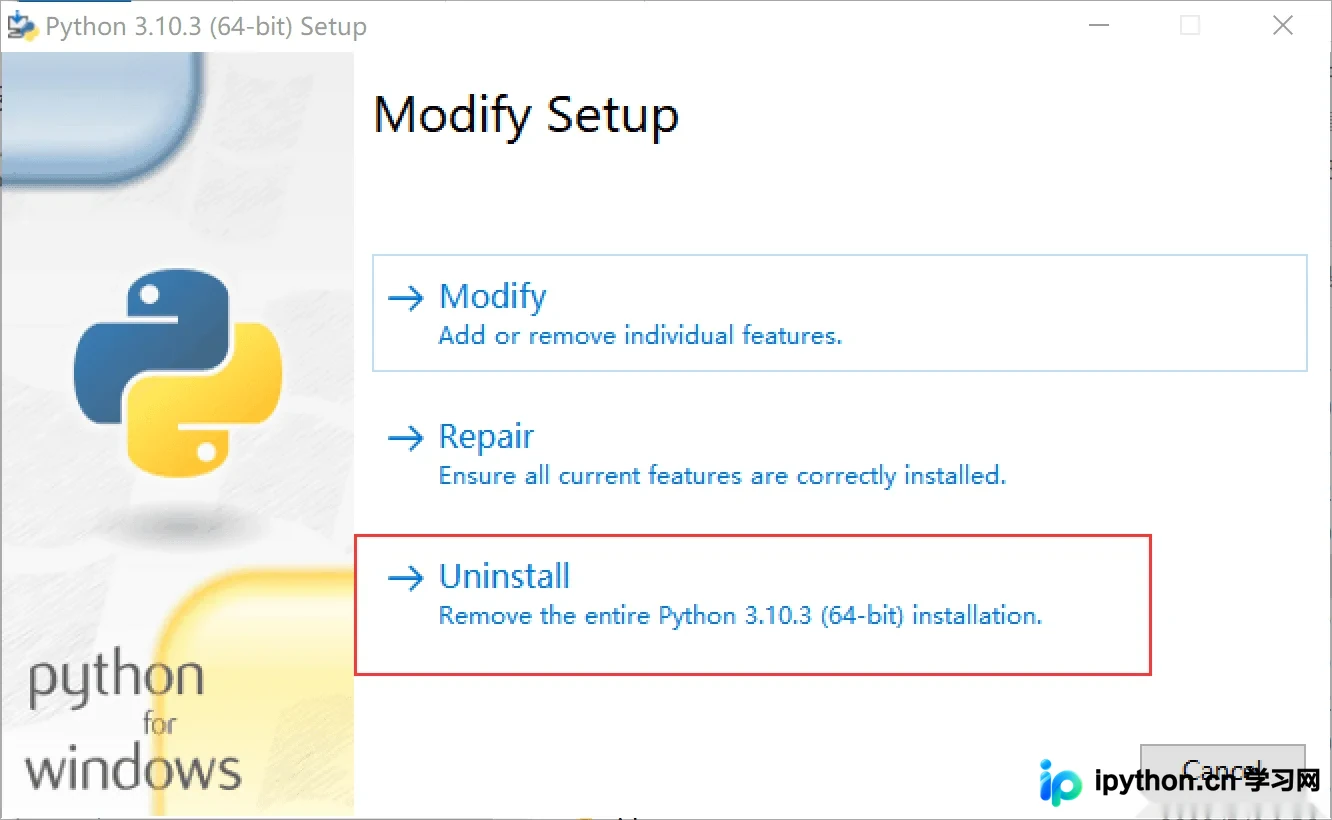
本文详细介绍在Windows系统中彻底卸载Python环境的三种标准方法,涵盖安装包移除、系统设置及控制面板操作。同时提供清理用户目录下的程序文件夹与pip缓存的具体路径,帮助用户安全清除所有关联数据,并说明版本升级时的库文件保留建议。
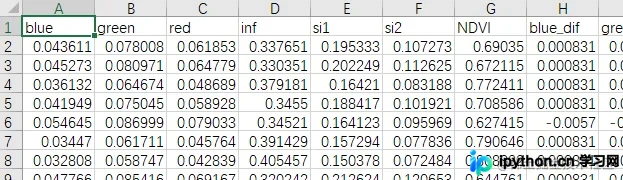
本文详细介绍如何使用Python的Pandas库读取Excel或CSV表格,通过设定各列数据的数值区间进行条件过滤。演示多条件独立筛选与批量合并筛选的代码实现,快速剔除不符合范围的异常样本行,保留核心数据并导出为新文件。
本文详细解析Python中模块、包与库的概念边界,逐步演示自定义代码文件的编写规范、__name__防重复调用机制以及__all__导出限制用法,结合import导入语法与系统搜索路径原理,完整覆盖项目实战中的代码组织结构管理需求。
Python 处理本地数据时,常需自动获取目录文件列表以替代繁琐的手动筛选。本文基于标准库 os,详细演示如何精准提取单层目标文件、递归收集多级子目录内容,并结合实际业务流完成文件批量重命名。代码附带路径安全校验与异常处理机制,帮助开发者快速搭建稳定的自动化数据预处理管道。
本文深入解析Python中闭包与装饰器的核心机制。详细阐述闭包的三个构成条件,并系统介绍装饰器的定义、执行顺序、带参数实现、基于类的实现方式以及内置装饰器如@property的用法。通过具体代码示例,帮助开发者掌握如何利用装饰器扩展函数功能,提升代码复用性与可维护性。
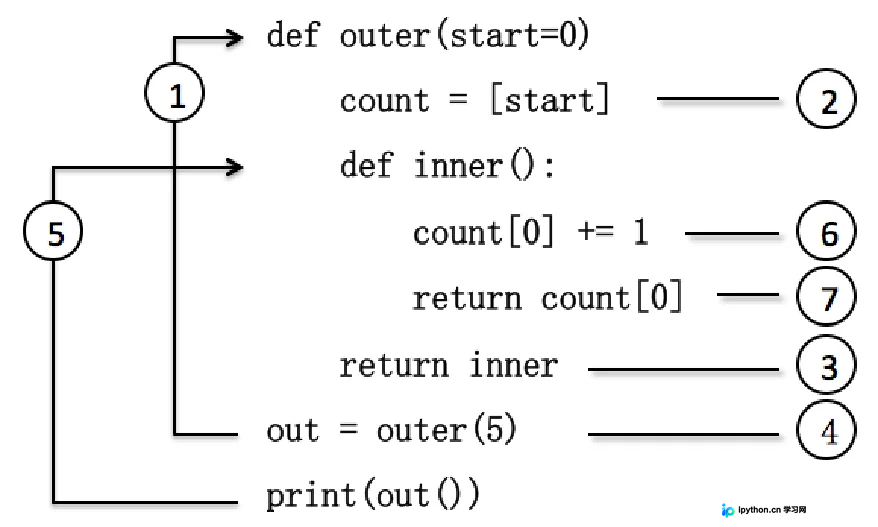
本文详细解析 Python Requests 库中管理 Cookie 的多种实现方案。涵盖直接通过 headers 和 cookies 参数发送凭证、利用 Session 对象自动捕获响应头中的 Set-Cookie,以及通过字典赋值、set() 方法、RequestsCookieJar 对象和 utils 工具类进行精细化控制的实操代码。附带参数冲突处理建议,帮助开发者快速完成身份验证与会话保持功能。
针对Excel表格中单元格内包含多行换行数据的解析难题,本文演示如何使用Python读取原始文件,通过字符串替换与列表推导将换行符转化为坐标序列,结合matplotlib自动批量绘制散点图并归档。代码已优化类型转换与画布管理逻辑,可直接用于同类数据清洗与可视化任务。
本文详细介绍 Python 中使用 **kwargs 灵活处理关键字参数的完整流程。涵盖如何安全接收与解析 kwargs 数据、利用 get() 方法避免键缺失错误,以及通过 ** 运算符高效解包传递字典参数。遵循明确声明、结合位置参数与规范注释的最佳实践,可显著提升函数的健壮性与代码可读性。
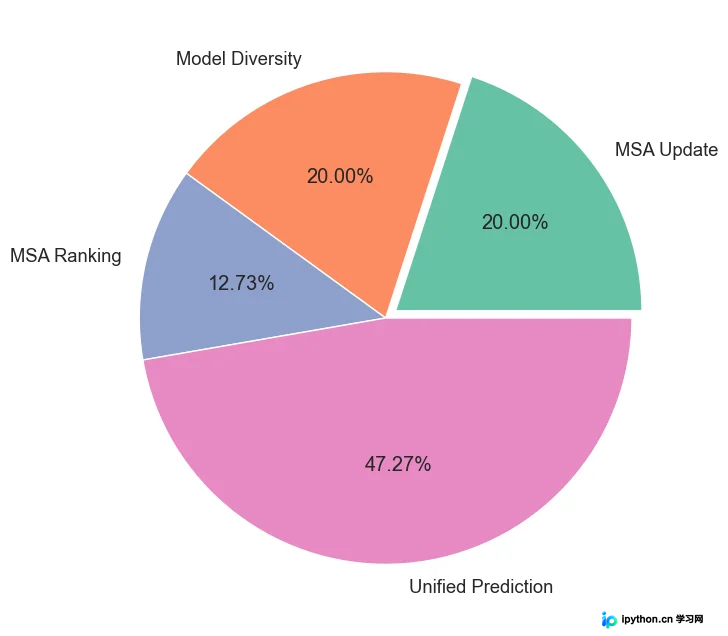
本文介绍如何利用 Python 的 Matplotlib 结合 Seaborn 快速生成支持局部高亮的饼图。通过配置 explode 参数可精确控制目标扇区的偏移距离,配合预设调色板与尺寸缩放,轻松实现数据占比的视觉突出,适用于报告展示与数据分析场景。