Python抓取网页链接的四种方案及iframe处理详解
本文深入分析Python中获取当前页面所有链接的四种主流方法,涵盖正则表达式、BeautifulSoup、lxml及Selenium。重点指出iframe内容无法通过常规DOM解析获取的问题,并提供针对iframe的额外抓取策略,帮助开发者全面掌握网页数据提取技巧。
2026-10-13
23

本文深入分析Python中获取当前页面所有链接的四种主流方法,涵盖正则表达式、BeautifulSoup、lxml及Selenium。重点指出iframe内容无法通过常规DOM解析获取的问题,并提供针对iframe的额外抓取策略,帮助开发者全面掌握网页数据提取技巧。
本文详细介绍如何使用Python实现一个支持多用户登录和并发处理的多线程FTP服务器及客户端。系统采用SHA512加密进行用户身份验证,具备独立的磁盘配额管理和家目录隔离功能。核心功能包括文件的上传与下载(含进度条显示)、目录切换、文件浏览及删除等。文章提供了服务器端main.py、file_handler.py以及客户端client.py、file_handler.py的核心代码逻辑,并补充了os、sys及re模块在文件操作和正则匹配中的常用方法,适合Python网络编程学习者参考。
本文介绍利用Python处理数字列表并提取相邻数的方法。通过遍历输入列表识别连续序列,对每个序列前后分别补全两个相邻整数,同时过滤掉小于0或大于400的数值。文章提供了详细的算法步骤及完整Python代码示例,适用于需要规范化连续数据范围的场景。
本文介绍在 Python 中如何利用 set() 函数高效比较两个数组的元素异同。通过集合的交集、并集及差集运算,可快速提取两个数组中共有元素、所有元素以及各自独有的元素。该方法简洁直观,适用于数据去重、差异比对等常见编程场景。
本文详解Python中super()函数调用时报错“must be type, not classobj”的原因。该错误源于Python 2.2前后新式类与旧式类的区别,super仅支持新式类。通过将父类定义为继承object的新式类(如class A(object))即可解决此问题,确保子类能正确调用父类方法。
本文详解Python中executemany函数的用法,通过SQLite示例展示如何利用序列批量插入数据并统计删除行数。涵盖代码实现、运行结果分析及常见应用场景,帮助开发者高效处理数据库批量操作。
本文详细介绍 Python 实现网站模拟登录的两种方法。重点在于获取表单提交地址并携带 Cookie 进行 POST 数据提交。通过普通脚本方式与面向对象封装两种方式,演示如何利用 urllib 和 http.cookiejar 模块完成身份验证及后续页面访问,帮助开发者掌握抓取需登录权限网页的核心技术。
本文介绍使用Python PIL库扩展图片尺寸并叠加文字的方法。针对OpenCV字体支持少及中文乱码问题,PIL提供了更灵活的解决方案。通过计算文本像素宽度与指定图片宽度的比例,自动确定换行行数并扩展画布高度,最终实现文字与图片的自然融合。
本文提供一段Python初学者适用的购物车程序代码,涵盖商品列表展示、用户工资输入、商品选择及余额计算等核心逻辑。通过该实例,读者可直观理解列表枚举、类型转换、循环控制及条件分支在实战中的应用,适合编程新手进行代码阅读与修改练习。
本文介绍使用Python将Excel文件转换为JSON格式的具体方法。通过xlrd库读取Excel数据,利用json模块生成标准JSON字符串,并处理编码问题。文中提供了完整的Python代码示例,涵盖文件读取、数据遍历及写入TXT/JSON文件的步骤,同时推荐了多款实用的JSON在线校验与优化工具,辅助开发者高效完成数据格式转换任务。
本文详解 Python 爬虫中因 URL 包含中文导致 UnicodeEncodeError 的原因及解决方案。通过 urllib.parse.quote 对链接进行编码转换,可有效避免 ASCII 解码异常,确保爬虫程序正常抓取含中文参数的网页内容。
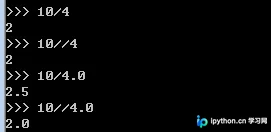
本文深入解析Python中的数字类型体系,涵盖整数、浮点数、复数及布尔值的基础特性。重点对比Python 2与3在除法运算上的差异,详解Decimal与Fraction模块如何解决浮点数精度丢失问题,并系统介绍集合的交集、并集等运算方法及注意事项,帮助开发者掌握Python数值处理的核心工具。