Python文本对齐:ljust/rjust/center与format()详解
本文介绍Python中实现文本对齐的两种主要方式:字符串内置方法ljust()、rjust()、center()以及通用的format()函数。通过示例演示如何指定宽度和自定义填充字符,并对比旧式%操作符,说明format()在类型通用性和功能强度上的优势。
2026-10-13
23

本文介绍Python中实现文本对齐的两种主要方式:字符串内置方法ljust()、rjust()、center()以及通用的format()函数。通过示例演示如何指定宽度和自定义填充字符,并对比旧式%操作符,说明format()在类型通用性和功能强度上的优势。
本文系统介绍Numpy库的基础用法,涵盖ndarray对象的多种创建方式,包括列表转换、随机数生成及特定值数组构造。详细解析数组维度、形状与数据类型等属性查看与转换方法,演示批量运算、维度重塑与矩阵转置。同时深入讲解一维及多维数组的切片索引技巧,并汇总常用数学计算、统计分析及逻辑判断函数,帮助开发者快速掌握Numpy核心操作。
本文提供Python实现屏幕截取并保存为文件的完整代码,利用PIL库获取图像,结合schedule库设定周期性截屏与定时清理任务。代码演示如何按日期创建目录保存截图,并自动删除指定天数前的旧截图目录,适用于需要定期监控屏幕状态的场景。
本文详细解析Python中Socket套接字的原理与实现,涵盖基于TCP协议的简单通信代码示例。重点探讨了阻塞模式下的同步问题、数据发送非空判断以及接收超过1024字节时的粘包现象,并结合subprocess模块实现服务端命令响应机制,为后续解决粘包问题奠定基础。
本文系统梳理Python内置的序列结构与散列结构。详细解析List、Tuple、String等序列类型的创建、切片及操作方法;深入讲解Set和Dict的特性、常用方法及数学运算。涵盖从基础创建到高级应用的完整指南,助您高效处理数据。
本文详解Python中字典排序的多种实现方法。重点介绍如何使用内置sorted函数结合lambda表达式分别实现按键和按值排序,对比keys()、items()及map映射等技巧的性能差异,并提供完整代码示例与注意事项,帮助开发者高效处理无序字典数据。
本文介绍如何使用Selenium结合PhantomJS模拟浏览器行为,以绕过豆瓣读书严格的反爬机制。针对直接请求导致的数据缺失和报错问题,通过模拟浏览器加载获取完整页面信息,并解析存储书籍数据。
本文探讨在 Python 中如何提升固定格式元组的可读性。通过对比普通元组访问方式,介绍了利用 IntEnum 定义字段索引以及使用 collections.namedtuple 创建具名元组两种方案。这两种方法能有效避免硬编码索引,使代码更清晰易维护,适用于学生系统等场景。
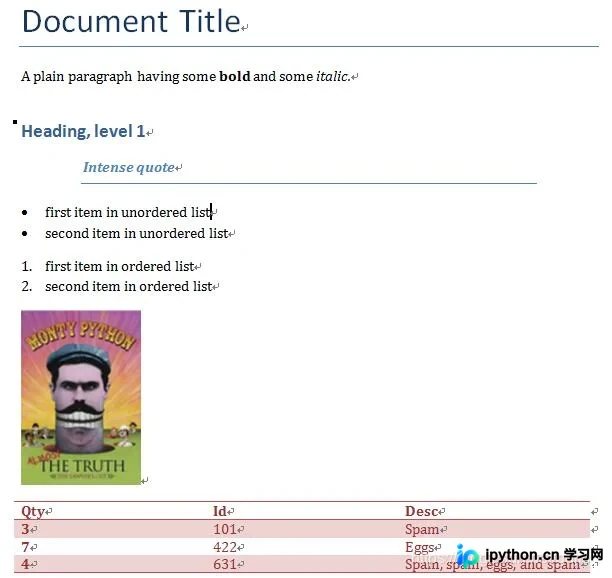
本文介绍如何使用python-docx库在Python中创建和编辑Microsoft Word文档。内容涵盖库的安装方法、.docx文件格式原理、文档创建(包括标题、段落、列表、图片及表格)以及文档读取操作。通过具体代码示例,展示如何生成包含格式文本的demo.docx文件并提取其内容,适用于需要自动化处理Word文档的开发者。
本文详细介绍Python Selenium中处理Select下拉选择框的两种核心方法:通过XPath直接定位元素,以及利用Selenium内置的Select模块进行标准化操作。重点解析select_by_index、select_by_value和select_by_visible_text三种选择方式,以及取消选择和获取选项属性的相关方法,适用于标准HTML select标签及非标准伪下拉框的自动化测试场景。
本文演示了如何使用Python将Excel数据高效导入SQL Server数据库。通过结合xlrd读取Excel文件与pymssql建立数据库连接,实现了批量插入操作。示例中处理一万多条数据耗时仅1秒左右,代码逻辑清晰,适合需要快速迁移数据的场景参考。
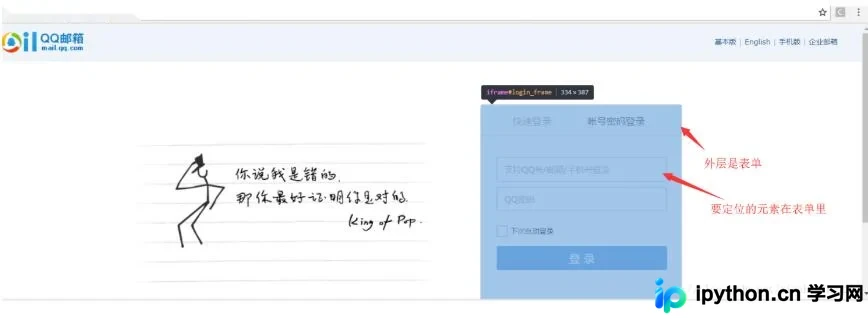
本文详解在Python3 Selenium自动化测试中处理Frame表单嵌套问题的方法。针对直接定位元素报错的情况,通过QQ邮箱登录实例,演示如何识别iframe结构并使用switch_to.frame()进行切换,从而成功定位并操作内部元素,提供完整可运行的代码参考。