

Python读取TXT文件中特定位置字符的方法
本文介绍在Python中读取TXT文件并提取特定位置字符的方法。通过open函数打开文件,使用readlines()读取所有行,再结合split()方法以固定字符为分隔符进行分割,最后通过索引n获取目标字符串并写入新文件。
2026-10-13
23

本文介绍在Python中读取TXT文件并提取特定位置字符的方法。通过open函数打开文件,使用readlines()读取所有行,再结合split()方法以固定字符为分隔符进行分割,最后通过索引n获取目标字符串并写入新文件。
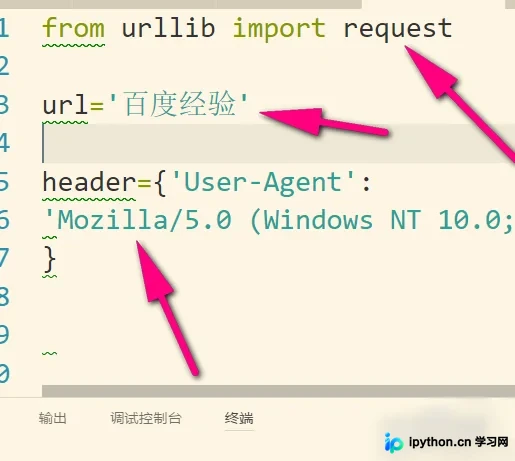
本文详解Python3爬虫中请求头Header的构建方法。通过浏览器开发者工具Network面板提取User-Agent,结合Request类构造GET或POST请求,并演示使用urlopen发送请求的完整流程,帮助开发者有效伪装浏览器身份。
本文介绍在Python中将TXT文件数据读取并转换为NumPy数组或列表的方法。针对包含混合数据的TXT文件,提供逐行处理并转为数组的代码示例;针对纯数字文件,推荐loadtxt直接读取。同时详细解析split和strip函数的语法、参数及实际应用案例,帮助开发者高效处理文本数据。
本文介绍在Python中实现输入数字反向输出的具体方法。通过示例代码展示如何利用循环和取余操作完成数字反转,适用于初学者理解基础算法逻辑与字符串处理技巧。
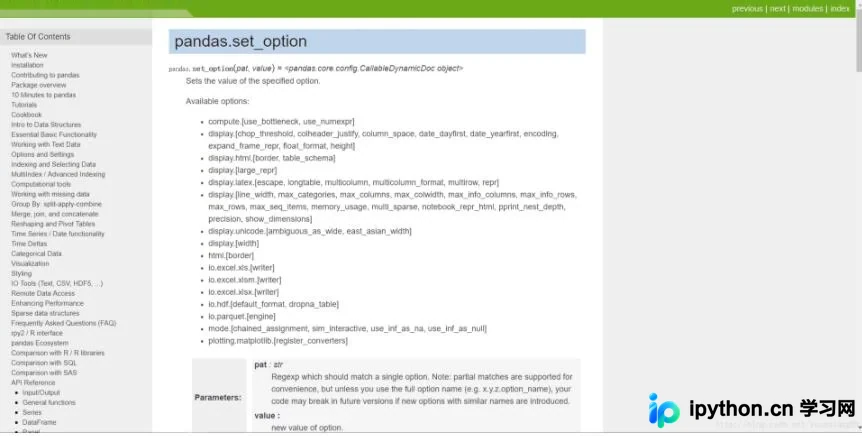
本文介绍在Python中使用Pandas打印Dataframe时,因行数过多导致中间数据显示省略号的问题。通过调用pandas.set_option()函数,配置display.max_rows为None及调整display.width,即可强制输出完整数据,避免信息截断。
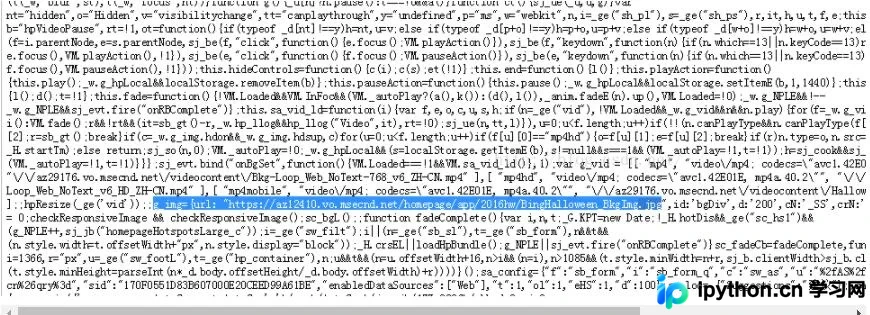
本文分析Python中使用正则表达式匹配网页图片URL时,因HTML源码包含换行符导致匹配失败的问题。通过对比单行与多行字符串匹配结果,指出默认模式下'.'不匹配换行符。解决方案为在re.compile中传入re.S标志,使点号匹配所有字符包括换行符,从而完美提取跨行显示的图片地址。
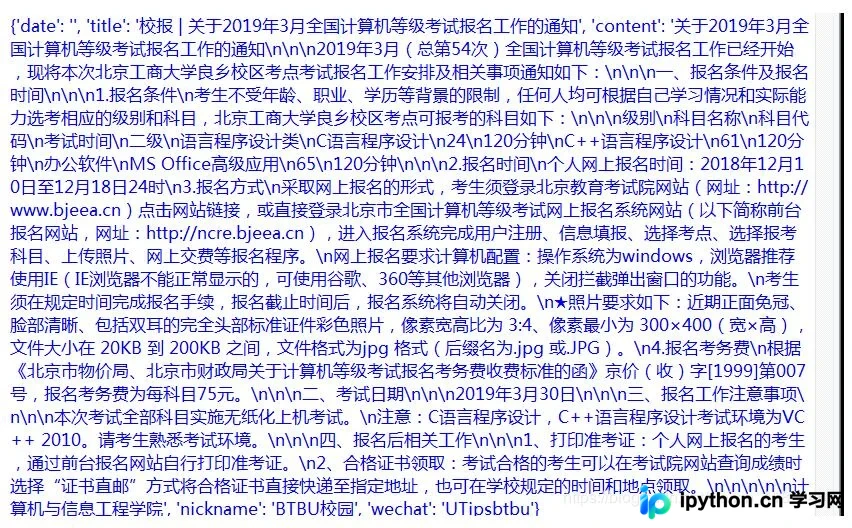
本文提供使用Python采集微信公众号文章的完整代码方案。通过搜狗微信搜索接口获取文章列表,利用PyQuery解析内容,并将结果存储至MongoDB。代码包含配置模块config.py及主程序采集公众号文章.py,支持关键词搜索、分页抓取及代理池配置,实测可有效运行,适合Python初学者参考学习。
本文解析Python中内置map与six.moves.map的区别。内置map直接返回列表,而six.moves.map返回迭代器对象,适用于Python 2与3的兼容处理。
本文针对Python3环境下使用HTMLTestRunner生成测试报告时出现的中文乱码问题,深入分析其根本原因。通过对比print输出与文件写入的差异,定位到文件打开方式未指定编码导致的编码错误。文章提供了两种有效的解决方案:一是在打开文件时显式设置encoding='utf-8';二是将写入模式改为二进制'wb'并对字符串进行UTF-8编码。
本文深入解析Python命名空间的本质、加载与查找顺序、生命周期及访问方式。详细阐述局部、全局及内置命名空间的层级关系,解析变量查找的LEGB规则,并通过locals()和globals()函数演示如何访问及修改命名空间,揭示两者在读写权限上的关键差异。
本文介绍了一种在Python中直接获取API返回参数的简化方法。通过移除不必要的传参步骤,仅保留核心的HTTP连接与请求代码,即可高效获取接口数据。该方法经过多次测试,被验证为最简单且有效的实现方式,适合初学者参考。
本文详解Django抽象基类中related_name的冲突问题及解决方案。通过在相关名称中使用%(app_label)s和%(class)s占位符,可自动生成唯一的反向关联名,避免子类字段命名冲突。同时介绍未指定related_name时的默认行为及验证机制。