

Python组合数据类型与自定义函数完整指南
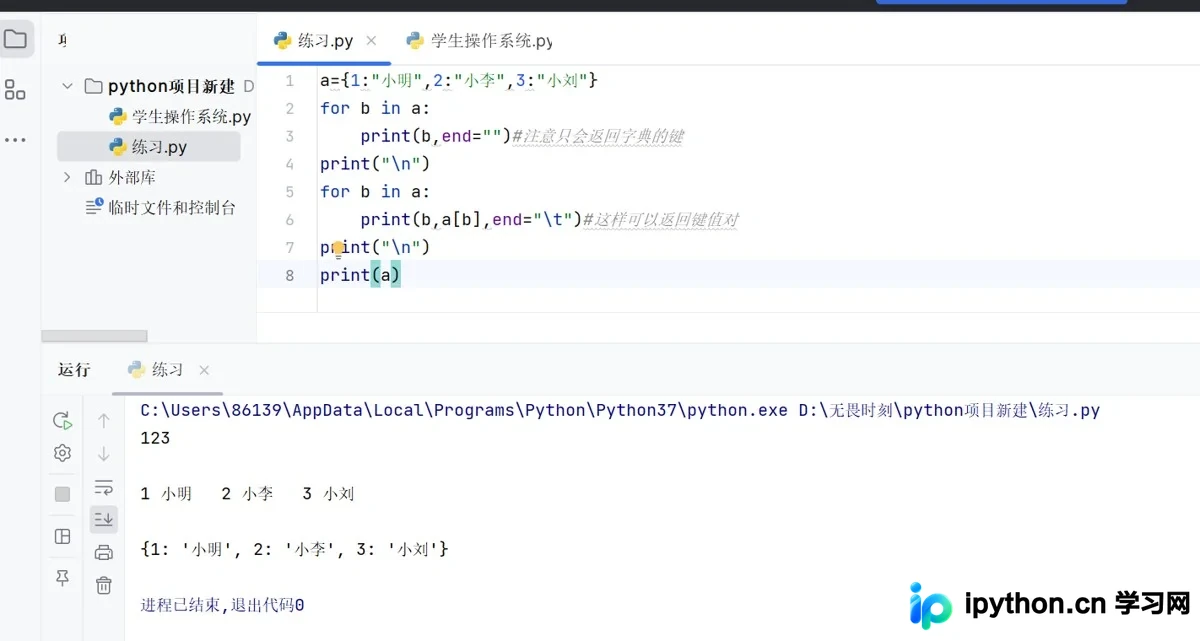
Python内置了元组与字典等组合数据类型用于高效存储与映射数据,其中字典通过键值对实现高维信息处理。结合自定义函数的参数规则(默认、可变与关键字参数)、LEGB作用域机制、global声明及标准模块导入方法,可避免重复编码并提升程序模块化程度。本文详解核心语法、避坑要点与实战逻辑。
2026-10-10
23

Python内置了元组与字典等组合数据类型用于高效存储与映射数据,其中字典通过键值对实现高维信息处理。结合自定义函数的参数规则(默认、可变与关键字参数)、LEGB作用域机制、global声明及标准模块导入方法,可避免重复编码并提升程序模块化程度。本文详解核心语法、避坑要点与实战逻辑。
深入解析Python异常处理机制,详细讲解try-except-finally标准结构、自定义异常与日志记录的最佳实践。提供多异常捕获、上下文管理器及性能优化策略,结合unittest单元测试用例,帮助开发者构建高稳定性的生产级代码。
本文详解Python中文件处理的核心流程,涵盖字符编码配置、文件打开参数、全文与逐行读取方法以及读写权限的区别。通过标准代码示例演示如何安全创建、读取、写入与追加文本文件,有效规避资源泄露与文件锁定问题,帮助开发者快速掌握本地数据存取的标准操作。
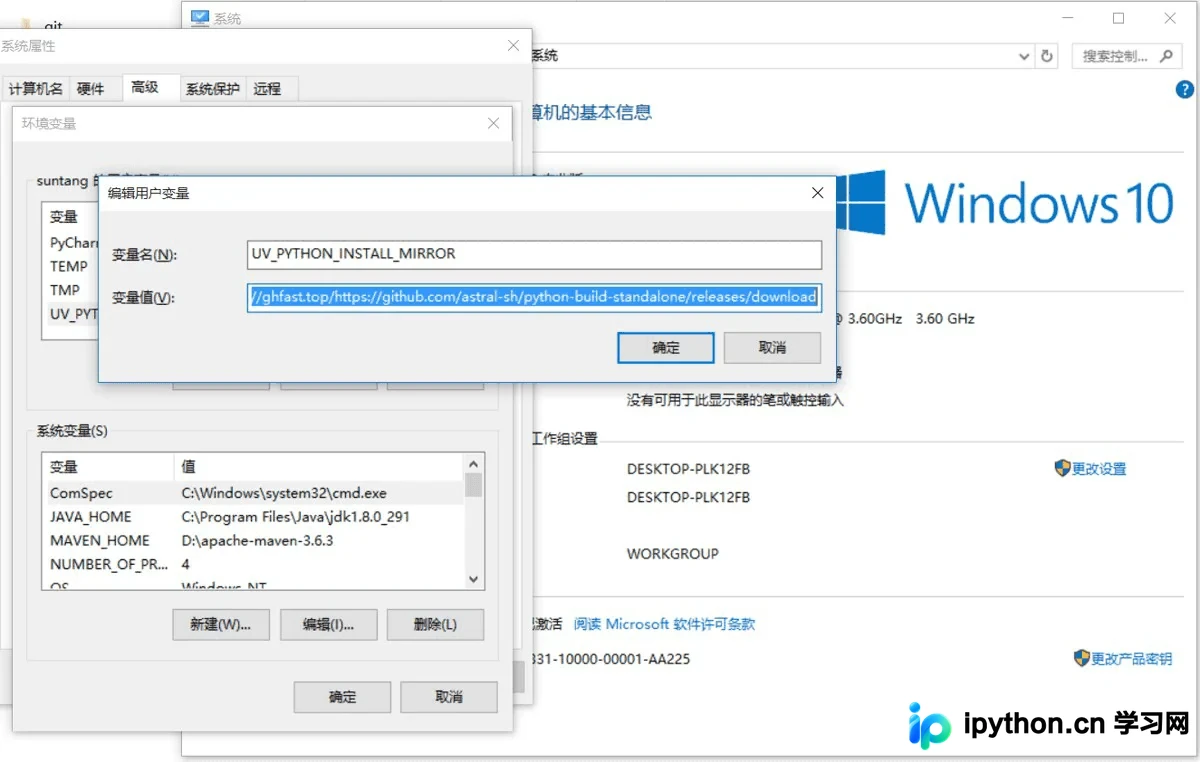
在使用 Python 包管理工具 uv 安装指定版本时,默认直连官方源会导致国内网络环境下载极慢或频繁超时。通过配置 UV_PYTHON_INSTALL_MIRROR 环境变量指向可用的镜像代理地址,即可显著提升获取速度并顺利完成 Python 版本的下载与安装。
本文介绍如何使用Python结合Spire.Doc库,将本地HTML文件或动态HTML字符串高效转换为Word(.doc/.docx)与PDF格式。涵盖环境安装、核心API调用、文件与字符串两种输入方式的完整代码示例,适用于报表生成、内容归档与批量文档处理场景。
本文详细演示如何在Python桌面端应用中实现文件浏览器的核心模块,涵盖目录智能分层遍历、文件列表过滤加载,以及针对.docx、.doc和.xlsx格式的文本级内容预览。通过策略模式分发与多维度降级处理,确保多格式文档安全读取与结构化展示,附带完整可运行代码与性能优化建议。
本文深入解析Python模块与包的导入机制,详细阐述sys.path的查找优先级、__init__.py在包组织中的作用,以及import与from...import语句的区别。同时涵盖相对导入的限制、命名空间(LEGB)规则及常见文件类型,帮助开发者快速定位模块导入错误并优化代码结构。
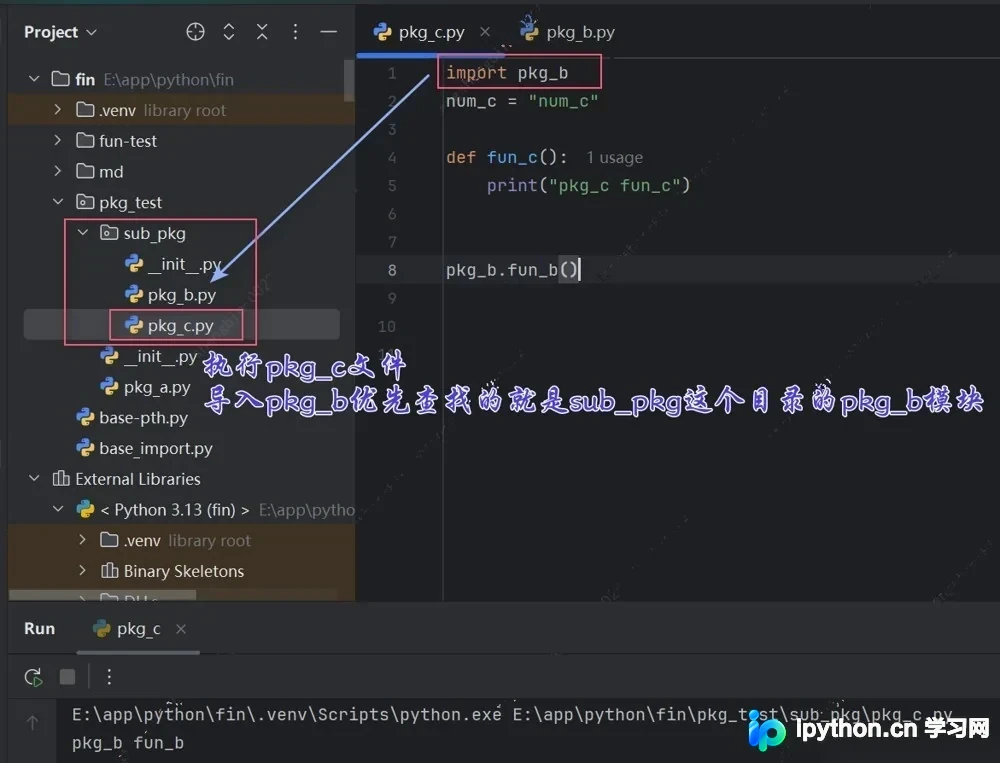
本文详细解析Python面向对象中__new__、__init__与__call__三大特殊方法的职责划分与调用顺序。通过实例演示对象创建、属性初始化与实例调用的完整生命周期,并总结单例模式、装饰器类及常见报错的排查方案,帮助开发者精准控制类行为与内存分配。
本文详解如何用Python将财务票据中的中文大写金额自动转换为阿拉伯数字。通过正则表达式提取元角分、按亿万千百逐级分割与映射计算,结合完整代码示例与测试验证,提供一套高可用的转换方案,适用于票据核对与自动化记账场景。
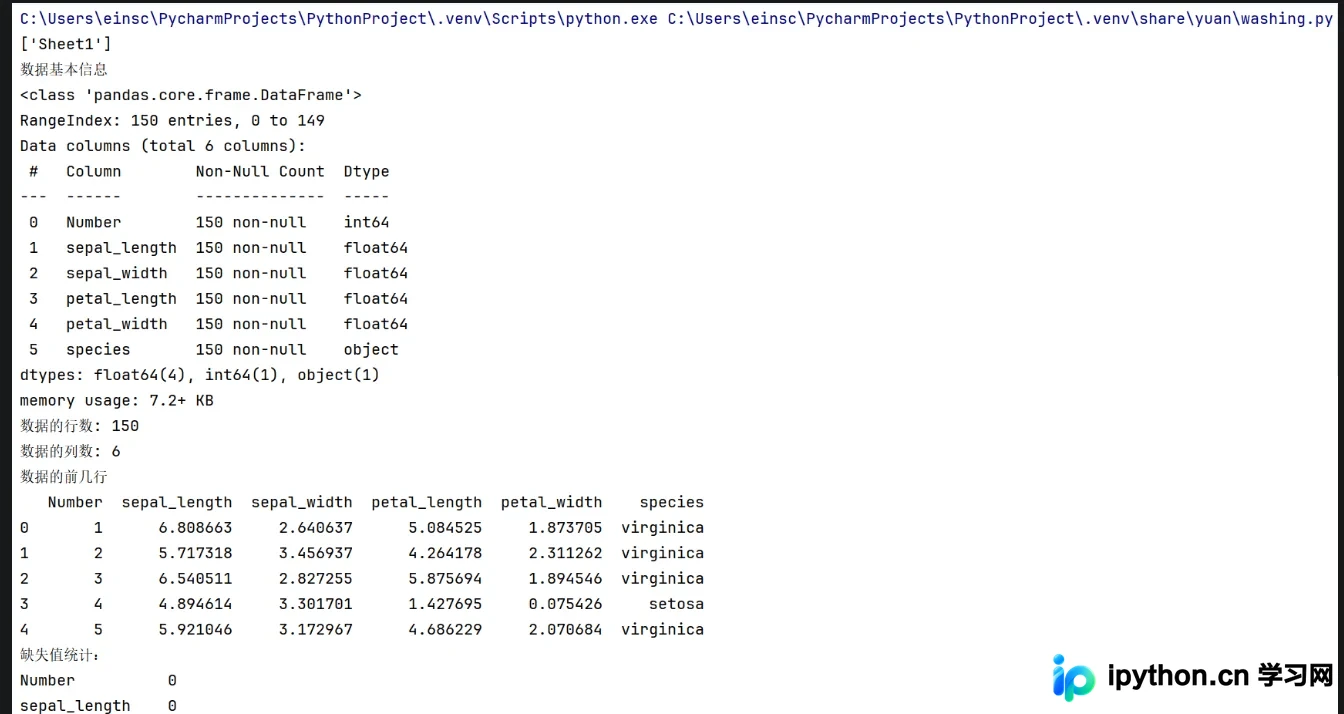
本文详解利用Python进行数据清洗与预处理的完整工作流。通过Pandas实现CSV/Excel数据加载、缺失值智能填充、重复行过滤、基于IQR的异常值检测与截断、类型转换以及Z-score与MinMax特征缩放。结合鸢尾花数据集提供可直接运行的端到端脚本与结果验证,助力开发者快速搭建高质量的机器学习数据输入管道。
详细讲解在Python环境中将Unix时间戳转换为人类可读时间字符串的完整实现路径。内容覆盖datetime模块核心转换步骤、strftime格式定制规则、time模块对比、跨时区同步方法及非法输入异常处理,附带可直接运行的代码模板,助力高效处理项目中的时间数据。
Python执行效率常受解释型特性、全局锁及动态内存管理制约。本文从代码结构、算法设计、系统工具与调试工作流四个维度提供优化方案,涵盖数据类型替换、生成器延迟计算、PyPy加速、Cython与Numba编译及向量化运算,配合标准性能分析流程,帮助开发者在保障正确性的前提下显著提升运行速度。