Python实现字符串逆序输出的多种方法详解
本文详细介绍Python中实现字符串逆序输出的几种常用方法,包括利用索引切片、列表反转以及奇偶位字符提取。同时深入解析了Python中变量覆盖导致isinstance()报错的常见陷阱,强调规范命名的重要性,帮助开发者避免潜在的程序错误。
2026-10-13
23

本文详细介绍Python中实现字符串逆序输出的几种常用方法,包括利用索引切片、列表反转以及奇偶位字符提取。同时深入解析了Python中变量覆盖导致isinstance()报错的常见陷阱,强调规范命名的重要性,帮助开发者避免潜在的程序错误。
本文提供了一段使用Python编写的查询IP地址归属地的完整代码示例。该脚本支持通过命令行传入单个IP、域名或包含IP的文件进行批量查询,利用淘宝IP接口获取国家、地区、城市及运营商信息,适合需要快速集成IP地理位置查询功能的开发者参考使用。
本文介绍在PyCharm中运行Python代码时出现中文乱码的两种解决方案。首先建议在文件头部添加编码声明及sys模块设置;若无效,则通过修改IDE全局设置中的控制台编码为UTF-8来解决。
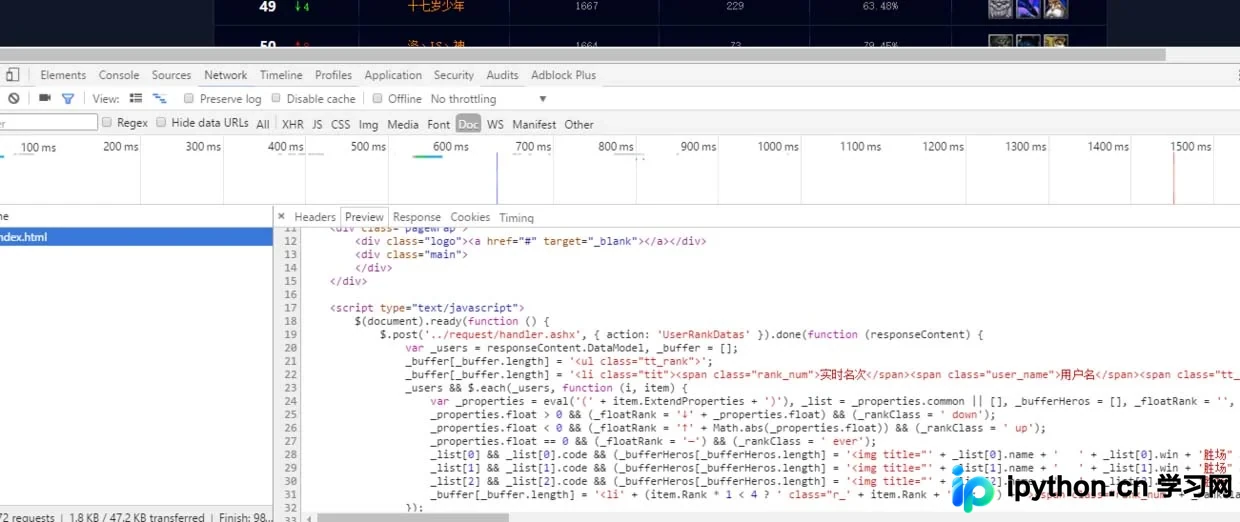
本文详细介绍如何利用Python抓取DOTA2游戏排行榜数据。通过浏览器开发者工具分析网络请求,定位异步POST接口及JSON数据结构,编写脚本模拟浏览器行为获取数据,并最终将结果保存至Excel文件中。适合希望学习网络爬虫基础及数据处理流程的开发者参考。
本文系统梳理Scrapy框架的五大核心命令行操作,涵盖从项目初始化、Spider文件生成到程序执行及交互式调试的完整流程。详细解析scrapy startproject、genspider、crawl及shell等关键指令的语法结构与使用场景,帮助开发者快速掌握Scrapy基础工作流,提升爬虫开发与调试效率。
本文介绍在Python中快速删除列表中重复元素的方法。通过示例代码展示如何利用set函数实现去重,并指出该方法会改变元素原有顺序。同时提供在线去重工具链接及Python相关教程推荐,帮助开发者高效处理数据。
本文深入解析Django ORM中objects.all()、get()与filter()的核心区别。all()返回QuerySet对象,支持惰性查询与迭代;get()直接执行SQL并返回单个Model实例,适用于精确查找;filter()则提供丰富的查询条件支持。文章详细列举了__exact、__contains等常用查询后缀及distinct去重用法,帮助开发者根据场景选择高效的数据获取方式。
本文详细介绍 Python 中枚举类 Enum 的定义方法、成员访问方式及比较规则。涵盖如何导入模块、使用 class 继承 Enum 类、处理重复值限制(@unique)以及通过名称或值获取成员。同时说明枚举的单例特性、不可变性及迭代支持,帮助开发者规范使用常量。
本文介绍在Fedora12和Python2.6.2环境下,利用urllib、urllib2及cookielib模块实现自动登录百度空间的Python代码。通过构建请求并处理Cookie,程序成功登录并获取页面内容,验证了跳转至个人主页的功能。
本文介绍在Python中使用正则表达式进行替换时,如何先对匹配到的内容进行特定处理(如转大写并反转),再将结果替换回原文。通过对比使用Lambda表达式和定义独立函数的两种实现方式,展示了re.sub函数的灵活用法,并附带了完整的代码示例与运行输出结果供参考。
本文详细介绍如何使用Python的urllib2库向服务器发起包含Accept-encoding: gzip头部的HTTP请求,获取压缩后的网页数据,并利用StringIO和gzip模块将其还原为原始内容。示例代码包含完整的请求构建、数据读取及解压写入流程,附带运行结果对比,适用于需要处理服务器压缩响应的Python开发场景。
本文介绍了一款基于Python开发的Windows单词监控翻译工具。该程序利用Qt监听系统剪切板变化,自动识别英文单词并调用有道翻译接口获取释义,最终通过Qt界面展示结果。解决了传统PDF阅读器翻译与注释功能冲突的问题,提升英文文献阅读效率。