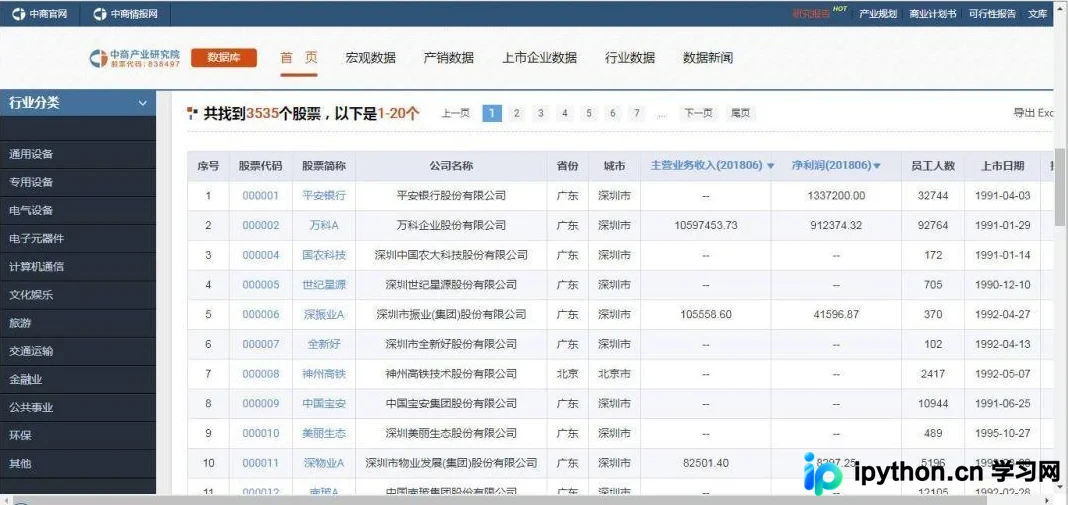
Python爬虫实战:从5行代码到爬取3000+上市公司数据
本文通过Python爬虫实战,展示如何从简单的5行代码逐步完善,最终实现爬取3000多家上市公司信息。文章涵盖环境配置、异常处理、灵活性优化及多进程加速等技巧,帮助初学者快速掌握爬虫开发流程。
2026-10-13
23

本文通过Python爬虫实战,展示如何从简单的5行代码逐步完善,最终实现爬取3000多家上市公司信息。文章涵盖环境配置、异常处理、灵活性优化及多进程加速等技巧,帮助初学者快速掌握爬虫开发流程。
本文介绍如何利用Python3和PIL库读取图片像素数据,通过遍历RGB值筛选特定颜色区域,并将其替换为大红色。代码示例展示了如何判断像素条件并保存修改后的图片,适用于需要批量处理图片颜色的场景。

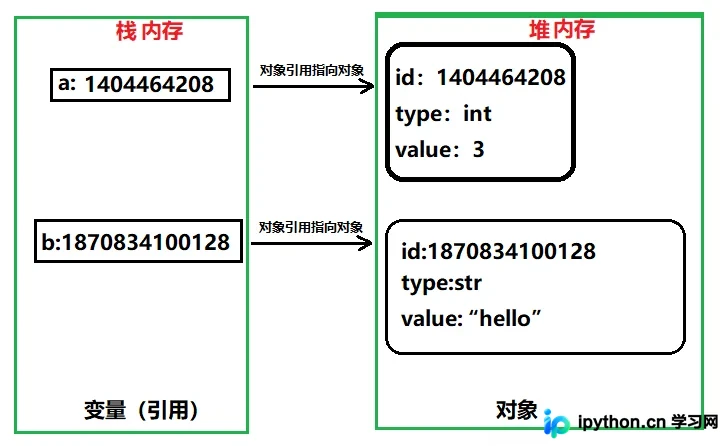
本文深入解析Python中“一切皆对象”的核心概念,详细阐述对象的三大属性:标识、类型与值。通过区分栈内存中的变量引用与堆内存中的实际对象,阐明动态类型与强类型的语言特性。同时介绍链式赋值、解包赋值及del语句对内存引用的影响,帮助开发者理解Python的内存分配与垃圾回收机制。
本文介绍如何使用Python的sklearn库实现K近邻回归模型。通过波士顿房价数据集,演示数据预处理、标准化及模型训练流程。重点对比等权重(uniform)与不等权重(distance)两种策略在预测精度上的差异,包括均方误差和平均绝对误差的分析,帮助开发者理解不同权重设置对回归结果的影响。
本文介绍Python中利用string模块的Template类进行字符串格式化的方法。通过导入Template类并实例化,可以使用substitute方法替换占位符。默认定界符为$,也可通过继承Template类并重写delimiter属性来自定义定界符,实现更灵活的字符串替换操作。
本文介绍如何使用Python实现类似王者荣耀的敏感词过滤功能。通过定义敏感词元组,接收用户输入并进行替换处理,最终输出过滤后的消息。该示例帮助初学者理解字符串操作与条件判断在实际场景中的应用。
本文详细解析了Python中将自定义对象设置为可迭代的两种主要实现方式。第一种是通过定义 __getitem__ 方法,利用系统默认从0开始的索引机制实现迭代;第二种是通过实现 __iter__ 和 next 方法,使对象具备生成器般的迭代行为。文章提供了具体的代码示例,帮助开发者理解并应用这两种技术。
本文介绍如何在Python中通过循环处理文本数据,实现字典中一个键对应多个值的存储结构。通过读取CSV或分隔符文本,演示如何构建基础键值对并删除指定键,以及如何利用列表作为值来合并重复键对应的多个结果,提供完整的代码示例与逻辑解析。
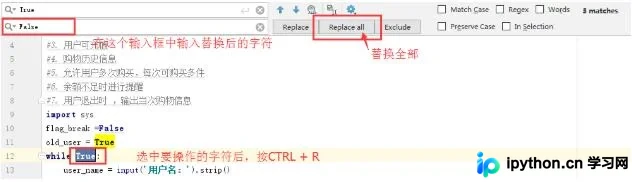
本文介绍在PyCharm中实现批量查找及替换的三种核心快捷键操作。通过Ctrl+R进行当前文件替换,利用Ctrl+Shift+F执行全局查找,以及使用Ctrl+Shift+R完成全局替换。掌握这些技巧可显著提升代码修改效率,适用于各类编程场景。
本文介绍如何在Python中通过继承collections.UserDict来自定义字典类。通过重写__missing__、__contains__、__setitem__和__getattr__等方法,实现类似字典的访问方式,包括属性访问和键值对操作。
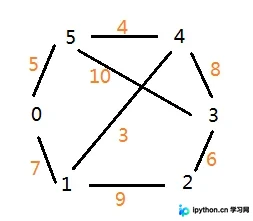
本文通过Python代码详细演示了Dijkstra和Floyd两种经典图搜索算法的实现。Dijkstra算法用于计算单源最短路径,而Floyd算法则用于求解所有节点对之间的最短距离。文章提供了完整的邻接矩阵定义、核心函数逻辑及路径回溯示例,帮助开发者理解算法原理并应用于实际编程中。
本文详细解析Python中Kruskal与Prim两种最小生成树算法的实现逻辑。Kruskal通过边权重排序及并查集思想构建,Prim则基于节点分组与贪心策略扩展。文章提供完整的Graph类代码示例及运行结果,帮助开发者理解算法核心差异与适用场景。