

Numpy矩阵求逆与伪逆实战指南
本文介绍如何在Numpy中计算矩阵的逆与伪逆。通过非奇异矩阵示例展示inv()函数与.I属性的用法,并针对奇异矩阵演示pin()求伪逆的方法,解决不可逆矩阵的计算问题。
2026-10-13
23

本文介绍如何在Numpy中计算矩阵的逆与伪逆。通过非奇异矩阵示例展示inv()函数与.I属性的用法,并针对奇异矩阵演示pin()求伪逆的方法,解决不可逆矩阵的计算问题。
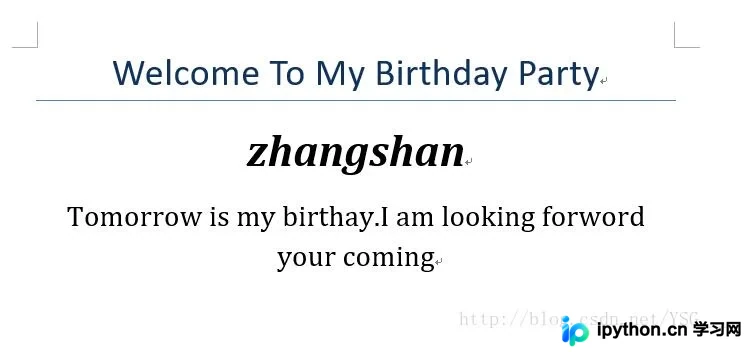
本文介绍如何利用Python的python-docx模块,通过读取客人名单文件,批量生成个性化的Word格式生日邀请函。代码演示了如何设置段落对齐、字体大小及样式,实现自动化文档创建,适用于聚会邀请等场景。
本文提供一段Python代码,用于批量将Excel文件中的多个Sheet页转换为CSV格式。通过xlrd和pandas库,自动处理包含空格字段的复杂表格,并按指定规则清洗数据。该脚本适用于需要高效处理大量Excel数据的场景,避免手工转换的低效与错误。
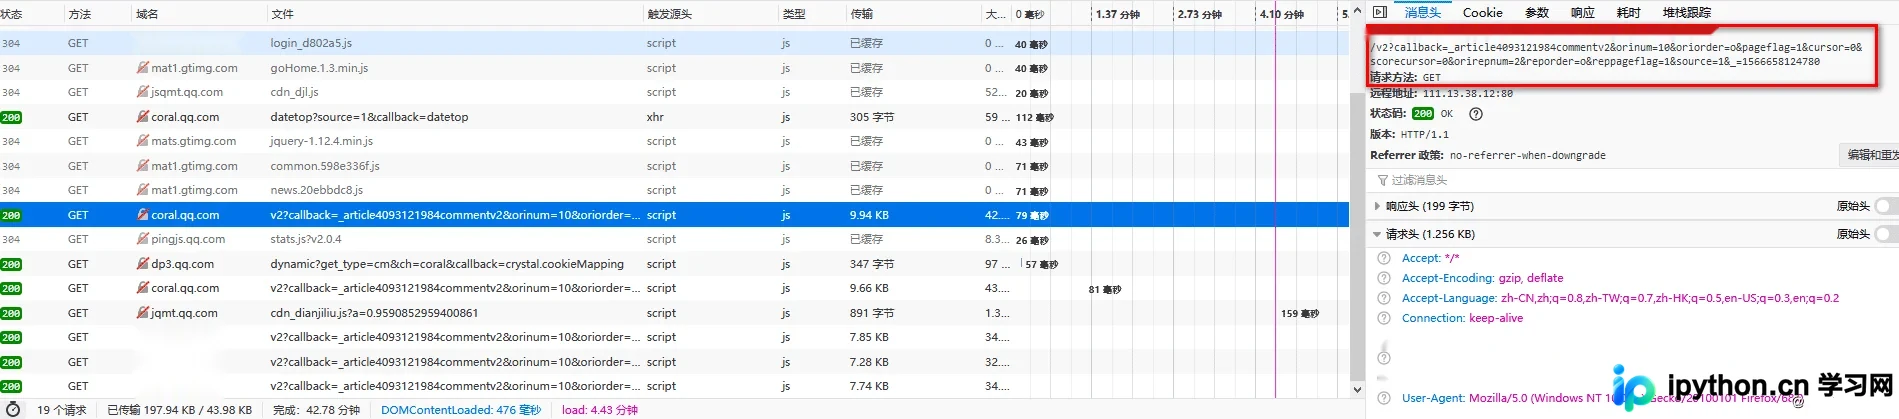
本文解析如何使用Python抓取2019年《中国好声音》第六期在腾讯视频的公开评论数据。通过逆向分析接口参数,实现分页评论、用户昵称及地区信息的自动化采集。随后利用jieba库进行中文分词,结合WordCloud生成主题词云,并通过Matplotlib绘制国内各地区参与用户分布直方图,完整展示从数据抓取到可视化分析的技术流程。
本文提供基于Python的电影下载链接爬虫实现方案。利用urllib2发起请求,结合BeautifulSoup解析HTML结构,提取电影标题及下载URL。代码包含分页处理、文件写入及编码转换逻辑,适用于学习Python网络爬虫基础与网页数据提取技术。
本文详细介绍Python Selenium中处理Select下拉选择框的两种核心方法:通过XPath直接定位元素,以及利用Selenium内置的Select模块进行标准化操作。重点解析select_by_index、select_by_value和select_by_visible_text三种选择方式,以及取消选择和获取选项属性的相关方法,适用于标准HTML select标签及非标准伪下拉框的自动化测试场景。
本文详细介绍在Ubuntu系统中配置Python环境以实现基于Tesseract的OCR文字识别功能。涵盖tesseract-ocr、pytesseract及Pillow库的安装步骤,提供完整的Python识别代码示例。针对中文识别缺失训练包的问题,给出chi_sim训练数据的安装方法,并说明中英文识别效果的差异。

本文演示了如何使用Python将Excel数据高效导入SQL Server数据库。通过结合xlrd读取Excel文件与pymssql建立数据库连接,实现了批量插入操作。示例中处理一万多条数据耗时仅1秒左右,代码逻辑清晰,适合需要快速迁移数据的场景参考。
本文深入解析Python Flask框架中的视图内容与模板实现。详细阐述Session基于Cookie的存储机制及Secret Key配置,区分请求与应用上下文。涵盖模板渲染、内置与自定义过滤器、宏继承包含等高级用法,以及Web表单处理与CSRF防护策略,提供完整代码示例。
本文通过具体代码示例,深入解析 Python 中类的继承机制以及实例方法、静态方法和类方法的定义与调用方式。文章展示了如何在注册登录系统中应用类继承,并详细对比了三种方法在实例和类层面的调用差异及参数传递规则,帮助开发者掌握面向对象编程的核心概念。
本文详细讲解如何在Django项目中集成Elasticsearch搜索引擎。内容涵盖通过Docker安装配置Elasticsearch及IK分词器,利用Haystack和drf-haystack封装REST framework接口。重点阐述索引类定义、模板配置、序列化器与视图集的开发,并解决drf-haystack与新版REST framework兼容性问题,提供完整的代码示例与配置指南。
本文详解在Django模板中通过url标签生成动态超链接的方法。重点解析namespace与name的配置对应关系,演示如何在urls.py中定义路由及视图函数,并在HTML模板中结合循环结构生成带参数的链接,适用于需要动态跳转的Web开发场景。