

TensorFlow加载模型后获取全部张量名称的方法
本文介绍在TensorFlow中加载预训练模型(如Inception_v3)后,如何提取图中所有节点的张量名称。通过遍历tf.get_default_graph().as_graph_def().node,可获取完整节点列表。支持直接打印输出或写入TXT文件保存,便于后续分析模型结构。
2026-10-13
23

本文介绍在TensorFlow中加载预训练模型(如Inception_v3)后,如何提取图中所有节点的张量名称。通过遍历tf.get_default_graph().as_graph_def().node,可获取完整节点列表。支持直接打印输出或写入TXT文件保存,便于后续分析模型结构。
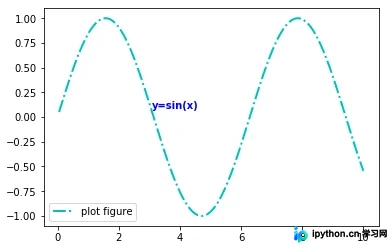
本文详细介绍Python中Matplotlib库的text()函数,用于在图表中添加无指向型注释文本。通过解析x、y坐标、字符串内容及weight、color等关键参数,结合完整代码示例,帮助开发者快速掌握在图形中添加自定义文本标注的技巧,适用于数据可视化场景。
本文详解如何在Django中利用Pillow库和pre_save信号,在保存ImageField时自动压缩图像。通过调整JPEG质量参数及结合尺寸调整,有效减小文件体积,提升网站加载速度并节省服务器存储空间。
本文详细介绍Python爬虫框架Scrapy的基础使用,涵盖环境安装、项目创建及目录结构解析。通过一个具体的题库抓取案例,演示如何编写Spider、定义Items、配置Pipeline以及处理数据库存储,帮助开发者快速掌握Scrapy的核心流程与代码实现。
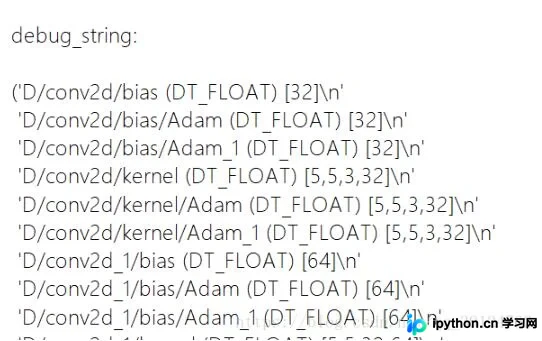
本文介绍如何在 TensorFlow 中使用 tf.train.NewCheckpointReader 类来读取保存的模型文件。通过该工具,开发者可以查看模型中所有变量的名称、数据类型及形状,并直接获取特定变量的张量值,适用于模型调试与权重分析。
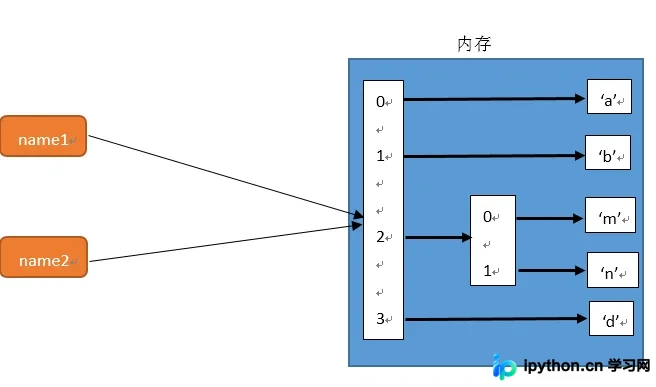
本文深入解析Python中字典、列表等可变对象的赋值、浅拷贝与深拷贝机制,通过内存地址变化直观展示区别。同时对比了字典的两种常见循环方式,指出直接遍历Key与items()方法的性能差异,为大数据量场景下的代码优化提供实践建议。
本文详细介绍Python中实现数字类型转换的核心函数。涵盖int()、float()、complex()用于数值类型互转,eval()处理字符串数值,以及chr()和ord()实现字符与ASCII码的相互转换。通过具体代码示例解析各函数的用法、参数及返回值,帮助开发者掌握Python数据类型转换的关键技巧。
本文介绍在Python中使用TensorFlow时如何精确控制GPU资源。通过设置CUDA_VISIBLE_DEVICES指定可用GPU,利用per_process_gpu_memory_fraction限制显存使用百分比,以及通过allow_growth=True实现按需最小化占用。适用于多GPU环境下的资源分配与显存优化场景。
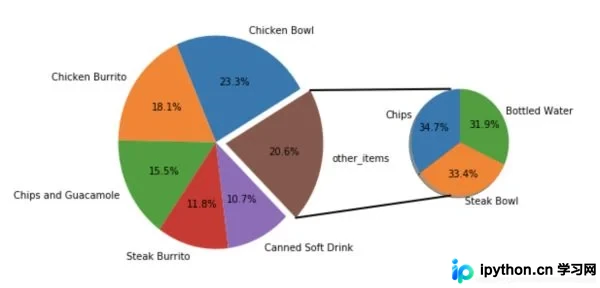
本文介绍如何利用Python的matplotlib库绘制复合饼图。通过创建两个子图分别展示主数据与次要数据,并使用ConnectionPatch连接两者,实现更直观的数据展示效果。
本文详解TensorFlow中tf.Variable的创建、类型形状固定机制及值修改方法。介绍global_variables_initializer全局初始化与initialized_value依赖初始化的使用场景,结合代码示例说明如何在Session中正确启动Graph并完成变量赋值操作。
本文详细介绍如何使用Python Scrapy框架搭建第一个爬虫项目。内容涵盖从创建项目、定义抓取字段、编写Spider逻辑到配置管道保存数据至MongoDB的完整流程,帮助初学者快速掌握Scrapy的核心使用方法。
本文针对TensorFlow在批量测试时因sess.run导致的内存溢出问题,分析发现根源在于for循环内部动态创建tf操作节点,导致计算图无限膨胀。通过将resize_bilinear和argmax等Op移出循环至初始化阶段,可有效防止图节点重复增加,显著降低内存占用并提升推理速度。