Python Pydantic 序列化详解:从基础转换到高级定制
介绍在 Python 中使用 Pydantic 进行数据序列化的完整方法,涵盖基础的 model_dump 转换、使用装饰器实现字段与模型级自定义序列化、通过类型注解统一控制行为,以及灵活运用 exclude/include 和 SerializeAsAny 精确控制输出格式,帮助开发者高效处理模型到 JSON 或字典的转换。
2026-10-11
24

介绍在 Python 中使用 Pydantic 进行数据序列化的完整方法,涵盖基础的 model_dump 转换、使用装饰器实现字段与模型级自定义序列化、通过类型注解统一控制行为,以及灵活运用 exclude/include 和 SerializeAsAny 精确控制输出格式,帮助开发者高效处理模型到 JSON 或字典的转换。
本文详细解析Python内置print函数的完整语法结构,重点说明sep、end、file和flush四个核心参数的作用机制。通过实际代码示例展示如何自定义分隔符、终止符、输出目标及刷新策略,附带常用格式化符号速查表,帮助开发者精准控制终端或文件的打印行为。
本文详解在单台Linux服务器上部署Python项目的完整流程。通过手动配置环境与Docker容器化两种主流方案,逐步涵盖虚拟环境创建、依赖包安装、代码上传、防火墙放行及进程守护。结合实际命令与状态检查标准,帮助开发者快速实现项目上线并保持服务稳定可用。
本文详细解析 Python 标准库 pathlib 模块的核心应用。对比传统 os 模块,逐步演示如何利用 Path 对象实现安全的路径拼接、目录增删、属性解析、存在性校验及高效读写与通配符搜索,助开发者编写更简洁稳定的文件系统交互代码。
本文针对Windows系统中PyCharm终端无法自动激活Conda虚拟环境的问题,分析其原因为默认终端PowerShell兼容性问题。分别提供社区版通过切换至cmd.exe解决的方法,以及专业版利用终端下拉菜单配置的两种方案,帮助用户快速恢复环境激活功能。
使用 Python 批量合并多个 Excel 工作表或按固定行数拆分大型表格是日常数据处理的常见需求。本文通过 pandas 与 xlrd/xlwt 库提供两段可直接运行的核心代码,演示如何实现多文件纵向拼接生成新 xlsx 文件,以及如何将超长 xls 表格按指定行数切割并保留原表头。
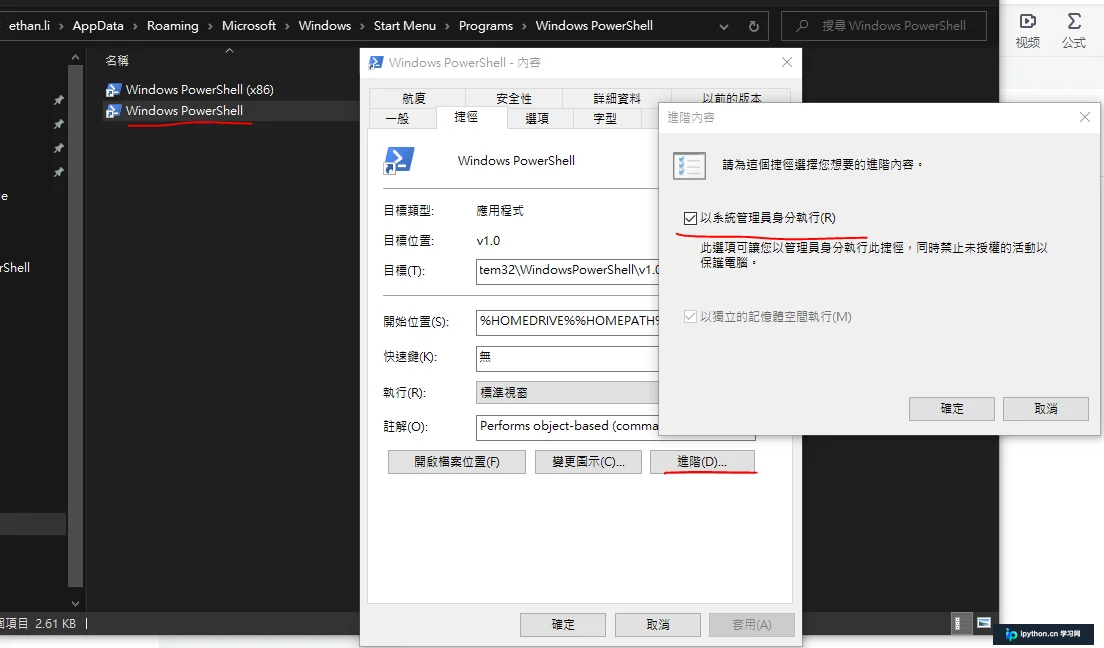
在配置本地Python或AI环境时,常遇到PyCharm终端执行conda激活时报错profile.ps1无法加载,或提示不含activate指令。本文通过修改PowerShell脚本执行策略、提升终端管理员权限及调整IDE配置,快速解决环境激活受阻问题。
本文详细讲解如何使用Python中的psycopg2库安全连接PostgreSQL数据库,并通过参数化查询完成建表、数据插入、记录更新、表数据清理与删除以及结果集读取等核心操作。内容包含完整的代码片段、关键参数说明与常见陷阱规避指南,助您快速搭建Python与PostgreSQL的数据交互流程。
本文详细讲解在 Pandas DataFrame 列中按条件筛选和查找数据的方法。通过 .where() 方法与布尔索引实现跨列条件判断、绝对值过滤及数值比对,附完整代码示例与输出结果说明,帮助开发者快速处理特征数据。
本文介绍如何在Python中去除字符串中的不间断空白符\xa0、制表符\t及换行符\n。通过对比translate方法结合fromkeys,以及利用split()和join()的组合技巧,提供高效且简洁的代码解决方案,并解析相关内置函数的原理。
本文介绍如何利用Python的tkinter库配合ttkbootstrap美化组件,快速构建一个具备基础四则运算与清除功能的桌面级计算器应用。通过定义窗口布局、绑定按钮事件与执行表达式计算,帮助初学者掌握Python GUI开发的核心流程与界面交互逻辑。
使用 Flask 框架处理文件上传时,上传数据会暂时存放于内存或临时位置。开发者可通过 request.files 字典获取文件对象,利用 secure_filename() 过滤非法字符后调用 save() 方法将文件安全保存至服务器磁盘。本文完整演示后端路由配置、前端表单编写及本地运行验证流程。