

Python将JSON数据写入Excel并计算总分与平均分
本文介绍如何使用Python将JSON格式的成绩数据读取并写入Excel文件。通过json模块解析数据,利用xlwt库创建Excel工作表,自动计算每位学生的总分与平均分,并将结果保存为xls格式文件,供学习参考。
2026-10-13
24

本文介绍如何使用Python将JSON格式的成绩数据读取并写入Excel文件。通过json模块解析数据,利用xlwt库创建Excel工作表,自动计算每位学生的总分与平均分,并将结果保存为xls格式文件,供学习参考。
本文详细解析Python中os和sys模块的核心区别:os专注于操作系统相关功能如文件目录操作,而sys用于与解释器交互及运行时配置。文章总结了os模块的文件、路径处理常用方法,以及sys模块的命令行参数、环境变量、标准输入输出等关键属性,帮助开发者高效调用系统接口。
本文深入探讨Python在人工智能领域的核心地位,对比Lisp、Prolog、C/C++及Java等语言的优劣,重点分析Python在文档、跨平台、易用性及开源生态方面的优势。同时列举AIMA、scikit-learn、NLTK等主流AI库,并通过员工情绪分析案例展示Python在物联网与AI结合场景下的实际应用价值。
本文详解Python中布尔值True与False的定义及严格的大小写规范,深入解析and、or、not三种逻辑运算符的计算规则与优先级。通过具体代码示例展示布尔运算结果,帮助开发者掌握Python基础逻辑判断与条件控制的核心概念。
本文详解Python中math模块的atan2()函数,用于计算给定x和y坐标值的反正切值。文章涵盖语法结构、参数说明、返回值定义及具体代码实例,帮助开发者掌握该函数的正确调用方式与结果解读。
本文详解如何使用Django限制同一IP在十分钟内仅能注册一次。通过创建Ip模型存储IP与时间,利用View类处理请求,比对当前时间与上次访问时间差值是否小于600秒。结合makemigrations与migrate命令更新数据库,并展示完整的视图逻辑代码,帮助开发者有效防止重复注册。
本文详解Python中矩阵行的全排列与组合切片方法。通过np.random.permutation实现随机行重排,利用itertools.combinations与permutations处理指定k行的组合与排列。文章提供C52、A52及列表任意组合的代码示例,解析排列组合公式C(m,n)的递归实现,帮助开发者掌握多维数据降维与空间切片技巧。
本文介绍如何利用Python编写网络爬虫程序,自动抓取万维网上的电商售卖信息。通过示例代码展示如何使用Requests发起HTTP请求,并结合BeautifulSoup解析HTML页面结构,提取商品标题、价格、发布时间及地区等关键字段。该示例以58同城电脑售卖信息为对象,演示了URL列表获取与详情页数据提取的基本流程,旨在帮助开发者掌握基础的数据爬取技巧。
本文详细介绍利用Python进行数据抓取的完整流程,涵盖分类网址获取、产品链接识别及详情解析。通过requests发起请求,结合BeautifulSoup与XPath处理HTML及JS动态数据,最终将结构化信息存入MongoDB数据库。文中提供了关键代码逻辑与异常处理机制,帮助开发者实现高效的数据采集与持久化存储。
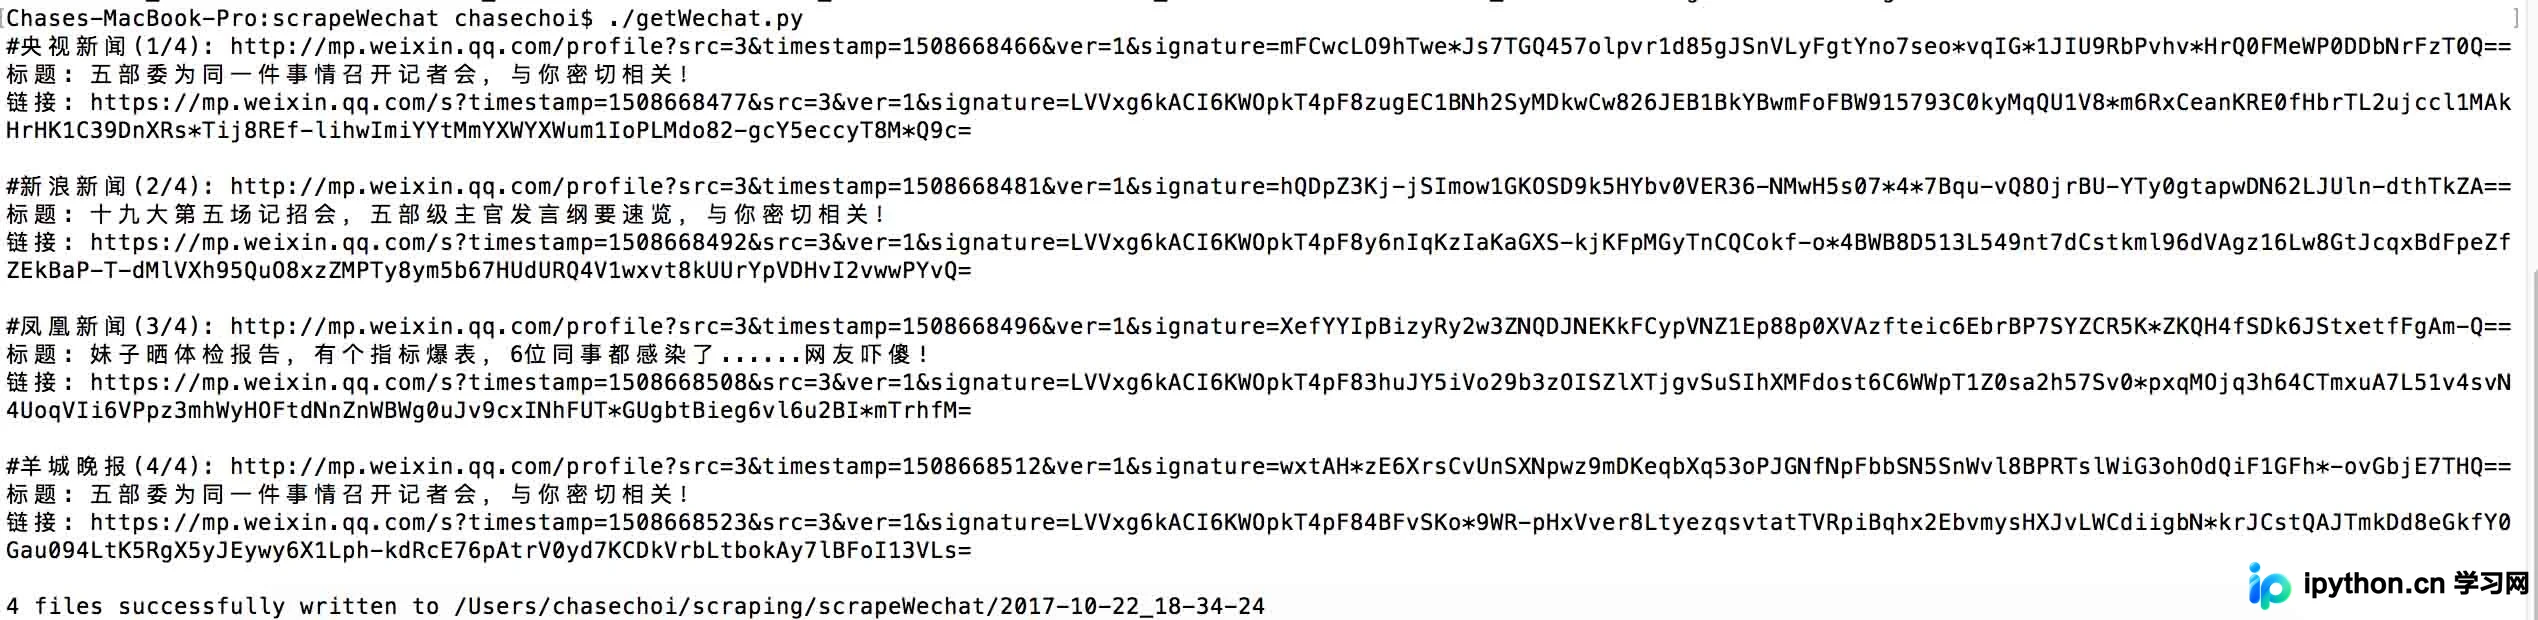
本文介绍如何使用Python抓取指定微信公众号的最新推送文章。针对搜狗微信搜索链接的时效性及动态网页渲染问题,结合Requests与Selenium+PhantomJS技术获取HTML内容,并通过BeautifulSoup提取链接。代码包含处理验证码提示、跨平台文件路径构造及带时间戳的文件保存逻辑,旨在提供一套完整的抓取示例供参考。
本文详细介绍Python中timeit模块的使用方法,用于精准测量代码执行耗时。通过timeit函数可测试单次或多次运行的时间,结合number参数控制循环次数;repeat函数支持多次重复测试并返回时间列表,取最小值作为最终结果,有效排除系统资源干扰,适用于函数性能评估。
本文详解Python中正则表达式模块re的findall()函数。通过对比search(),展示如何利用findall()查找并返回所有匹配字符串。结合具体代码示例,解析参数设置与输出结果,帮助开发者掌握批量提取文本信息的技巧。