Python实现文件夹内文件批量排序与重编号
本文介绍利用Python脚本对指定文件夹内的文件进行批量排序和重编号的方法。通过遍历目录并修改文件扩展名,可实现有序命名。若需保持格式一致,建议分两次运行脚本以转换格式,确保最终结果符合预期。
2026-10-13
24

本文介绍利用Python脚本对指定文件夹内的文件进行批量排序和重编号的方法。通过遍历目录并修改文件扩展名,可实现有序命名。若需保持格式一致,建议分两次运行脚本以转换格式,确保最终结果符合预期。
在使用Pandas处理数据时,isnull()生成的布尔矩阵难以直观识别缺失位置。本文介绍通过df.isnull().any()筛选含缺失值的列,并结合df[df.isnull().values==True]直接过滤出包含NaN的行,从而精准定位缺失数据的具体行列位置并辅助统计数量,提升数据清洗效率。
本文深入解析Pandas中DataFrame的行列数据筛选方法。通过对比df[]、df.loc、df.iloc及已弃用的df.ix,详细阐述基于标签与位置的索引逻辑。重点说明列选取时行索引不能为空的操作规范,以及混合索引类型的注意事项,帮助开发者高效处理表格数据。
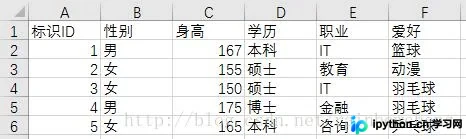
本文详细介绍Python中Pandas库的concat函数,用于DataFrames的合并操作。通过设置axis参数实现纵向(行)或横向(列)拼接,并解析objs、join等关键参数的作用,帮助开发者高效处理数据整合任务。
本文介绍如何在Python3环境下调用搜狗人工智能API进行图像文字识别(OCR)及身份证信息提取。文章提供了完整的代码示例,包括SougouAPIMsg类的签名生成逻辑、请求封装及结果解析。针对搜狗API接口标准化程度较低、不同接口返回结构不一致的问题,文中给出了具体的处理策略,并提供了GitHub源码链接供参考。
本文介绍如何使用Pandas对DataFrame进行排序操作。通过示例演示如何对单列(如user_id)进行默认升序排序,以及如何基于多列(如user_id和sku_id)进行复合排序。掌握sort_index方法的使用,提升数据清洗与处理效率。
本文介绍了如何在Python的Pandas库中,利用set_index方法将DataFrame中的指定列转换为索引。通过示例代码展示了具体操作,帮助用户快速掌握数据预处理中索引设置的关键技巧。
本文介绍在Python中如何使用DataFrame获取行数、列数、索引以及指定行列的值。通过示例代码展示如何创建DataFrame,并提取其列数、行数、索引值及特定单元格的值。
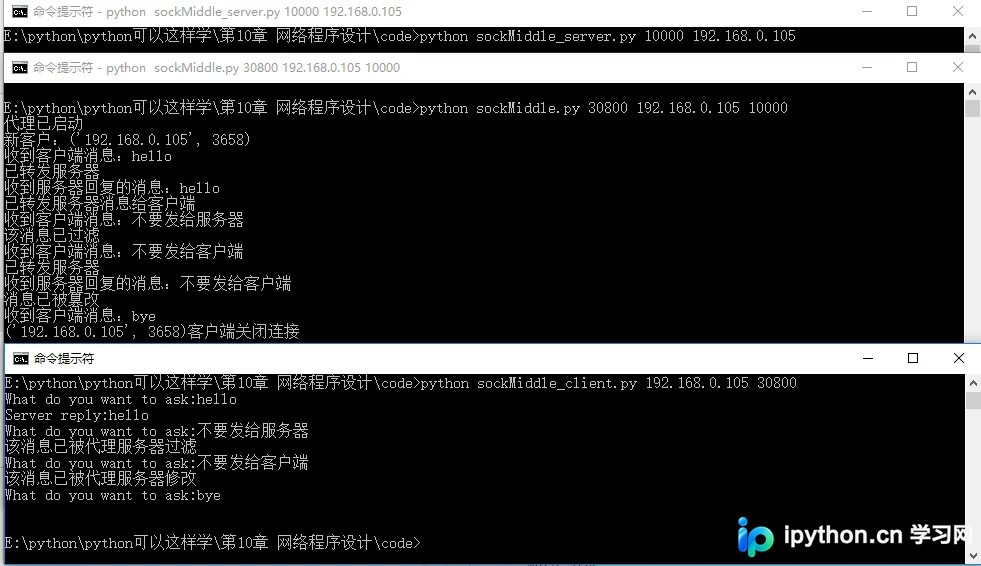
本文通过Python代码演示了简易代理服务器的实现,涵盖服务端、代理层及客户端的完整交互流程。示例展示了代理服务器如何记录并修改通信内容,包括消息过滤与篡改功能。文章指出此类机制可能侵犯用户隐私,建议涉及资金交易时谨慎使用代理。
本文介绍在pandas中处理数据时,如何将现有Dataframe的指定行高效添加至新Dataframe。对比了使用append方法的低效与潜在问题,推荐先构建包含字典的列表再转换为Dataframe的方法,以解决速度慢及数据类型异常的问题,并提供完整代码示例。
本文深入解析Python中基于C语言libcurl实现的pycurl模块。详细阐述Curl对象的创建、连接超时、重定向及User-Agent等关键setopt参数的配置方法,并列举getinfo方法获取HTTP状态码、传输耗时及下载速度等性能指标的具体用法,为高性能网络请求处理提供实用参考。
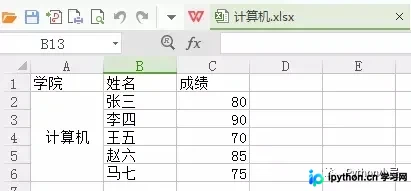
本文详细讲解如何使用Python批量合并包含合并单元格的Excel文件。针对部分学院成绩单中“学院”列存在合并单元格的情况,通过代码实现数据读取、合并逻辑处理及结果输出,解决格式不一致导致的合并难题,提供完整参考代码与运行效果展示。