

Python实现日志增量抓取与正则匹配示例
本文介绍了一种使用Python实现的日志增量抓取方法。通过记录文件最后修改时间和读取位置,结合正则表达式对新增日志进行匹配提取。示例代码展示了如何初始化扫描器、判断文件变化并输出匹配结果,适用于需要高效处理持续更新日志文件的场景。
2026-10-13
24

本文介绍了一种使用Python实现的日志增量抓取方法。通过记录文件最后修改时间和读取位置,结合正则表达式对新增日志进行匹配提取。示例代码展示了如何初始化扫描器、判断文件变化并输出匹配结果,适用于需要高效处理持续更新日志文件的场景。
本文介绍在Python3中使用Numpy库将TXT格式的数据文件读取并转换为矩阵的方法。通过打开文件、逐行读取、去除换行符并按空格分割数据,利用列表切片将处理后的数据赋值给预定义的Numpy矩阵对象。文章详细解析了矩阵行索引与数据赋值的逻辑过程,适用于需要批量处理数值型文本数据的场景。
本文详细介绍在Python中去除文件扩展名的几种常用方法。通过os.path模块的splitext函数结合basename,可以精准提取文件名主体。此外,还展示了利用字符串split和rsplit方法进行路径解析的技巧,适用于不同场景下的文件名处理需求。
本文介绍在CentOS7.3.1611_x64系统Python 2.7.5环境下,如何高效批量替换多个源文件中的指定字符串。提供了两种方案:利用sed与grep组合命令快速处理,以及编写Python脚本实现跨平台(含Windows)的目录遍历替换。
本文详解如何使用 joblib 库为 pandas 的 apply 函数实现多进程处理,以去停用词为例对比单进程与多进程的性能差异。通过 groupby 分组并行执行,展示了在大数据量下多进程的优势及小任务下的开销陷阱,帮助开发者合理选择并行策略。
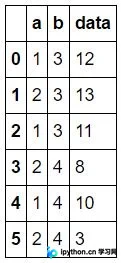
本文介绍在pandas中如何获取groupby分组后最大值所在的行。通过示例DataFrame,演示了使用apply过滤、transform匹配索引、idxmax以及先排序后取首行四种方法。针对多行并列最大值的情况,重点解析了idxmax仅返回第一行的特性及排序法的替代方案,并探讨了扩展至中间值等场景的思路。
本文介绍在Python IDLE环境中输入多行代码(如if-else结构)的具体操作方法。重点说明如何利用Tab键控制代码缩进,并通过连续两次回车键确认输入结束。该技巧适用于Python命令行模式下的交互式编程,帮助开发者更高效地编写和测试逻辑块代码。
本文详细解析Python3中用于对象属性管理的四个核心内置函数:hasattr、getattr、setattr和delattr。通过具体语法说明、参数定义及完整代码示例,展示如何判断属性存在、获取属性值、动态设置属性以及安全删除属性,帮助开发者高效处理Python对象的状态管理。
本文详细介绍使用Python获取酷狗音乐TOP500榜单中歌曲MP3格式下载地址的方法,提供完整代码示例。针对部分页面规律失效导致无法完整爬取的问题,文章提供了转向爬取酷狗飙升榜100首的替代方案,包含API请求与网页解析两种实现路径,帮助开发者解决数据抓取中的跳转与完整性难题。
本文介绍Numpy中实现数组转置的两种常用方法。重点解析一维数组转置时的常见陷阱,指出仅使用transpose无法改变维度,必须配合shape参数指定目标形状,才能正确将行向量转换为列向量。
本文介绍Python中移除列表指定位置元素的实现逻辑。核心在于判断索引是否越界,若超出范围则返回原列表,否则调用pop方法删除指定索引元素。代码包含对负索引及越界情况的处理,适合需要处理列表数据清洗或特定位置删除的场景参考。
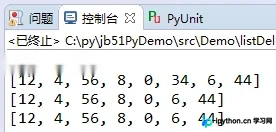
本文总结Python 2.7环境下处理中文编码的实用技巧。通过设置默认编码、使用unicode函数处理文件路径,以及利用codecs模块写入BOM头,可有效解决文件名及Excel打开时的中文乱码问题。