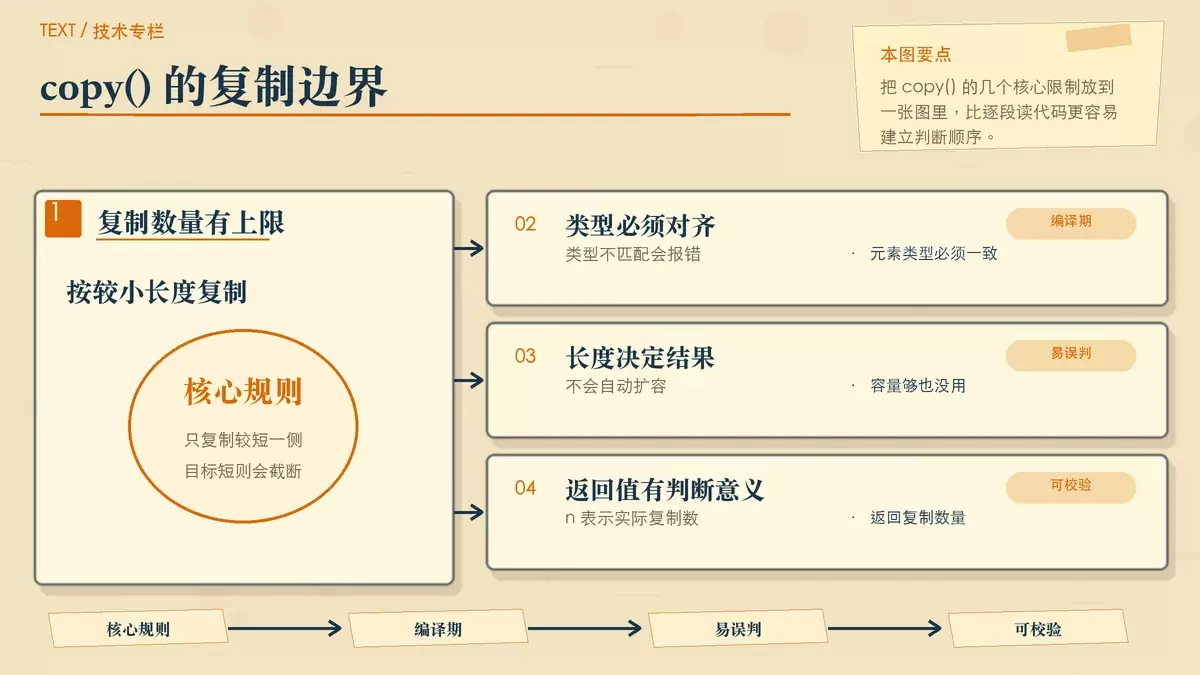
掌握 Go 的 copy() 函数,避开切片复制里的常见坑
Go 里的 `copy()` 看起来简单,真正容易踩坑的却是切片长度、底层数组共享,以及多维切片只做浅复制这几件事。本文把 `copy()` 的返回值、边界行为和几类高频用法拆开讲清,帮助你判断什么时候直接复制就够,什么时候必须手动做深复制。
2026-08-25
182

Go 里的 `copy()` 看起来简单,真正容易踩坑的却是切片长度、底层数组共享,以及多维切片只做浅复制这几件事。本文把 `copy()` 的返回值、边界行为和几类高频用法拆开讲清,帮助你判断什么时候直接复制就够,什么时候必须手动做深复制。
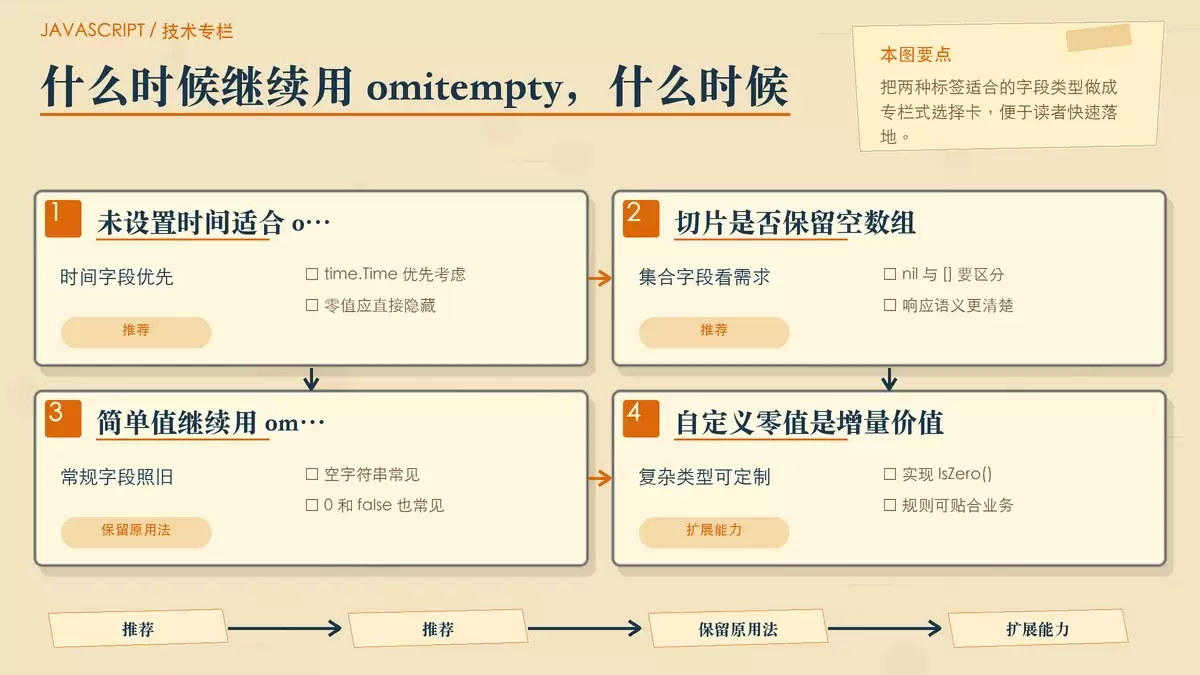
Go 1.24 为 `encoding/json` 增加了 `omitzero` 标签,用来按“零值”而不是“空值”决定字段是否序列化。它解决了 `time.Time` 零值总被输出、`nil` 切片与空切片无法区分,以及自定义类型缺少忽略规则等老问题。 在 Go 项目里,很多人已经把 `omitempty` 用成了默认配置,但一到 `time.Time`、空切片和自定义类型这些细一点的场景,序列化结果就常常不如预期。
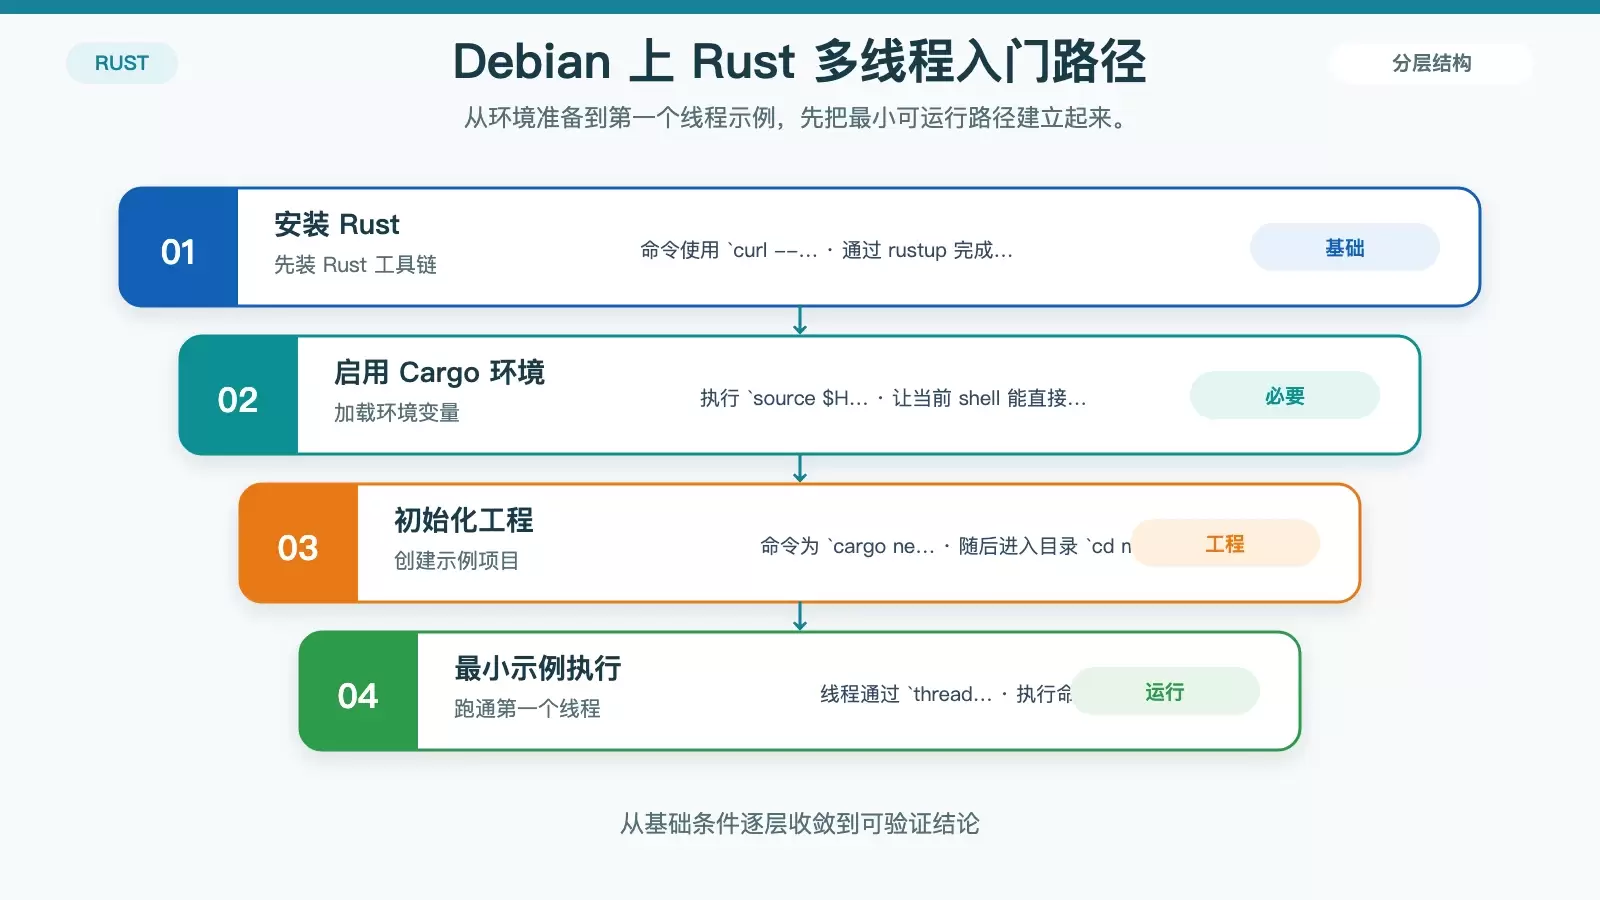
这篇文章按 Debian 环境配置、线程创建、线程间通信、同步控制到调试排查几个环节,梳理 Rust 多线程开发的基本路径。你可以据此快速搭起示例工程,并判断什么时候该用 `thread::spawn`、`mpsc`、`Arc >` 或 `RwLock`。 在 Debian 上写 Rust 多线程程序,真正让人卡住的通常不是安装环境,而是从“能跑”走到“跑得稳”的那一步:线程怎么创建、数据怎么在线程间流动、共。
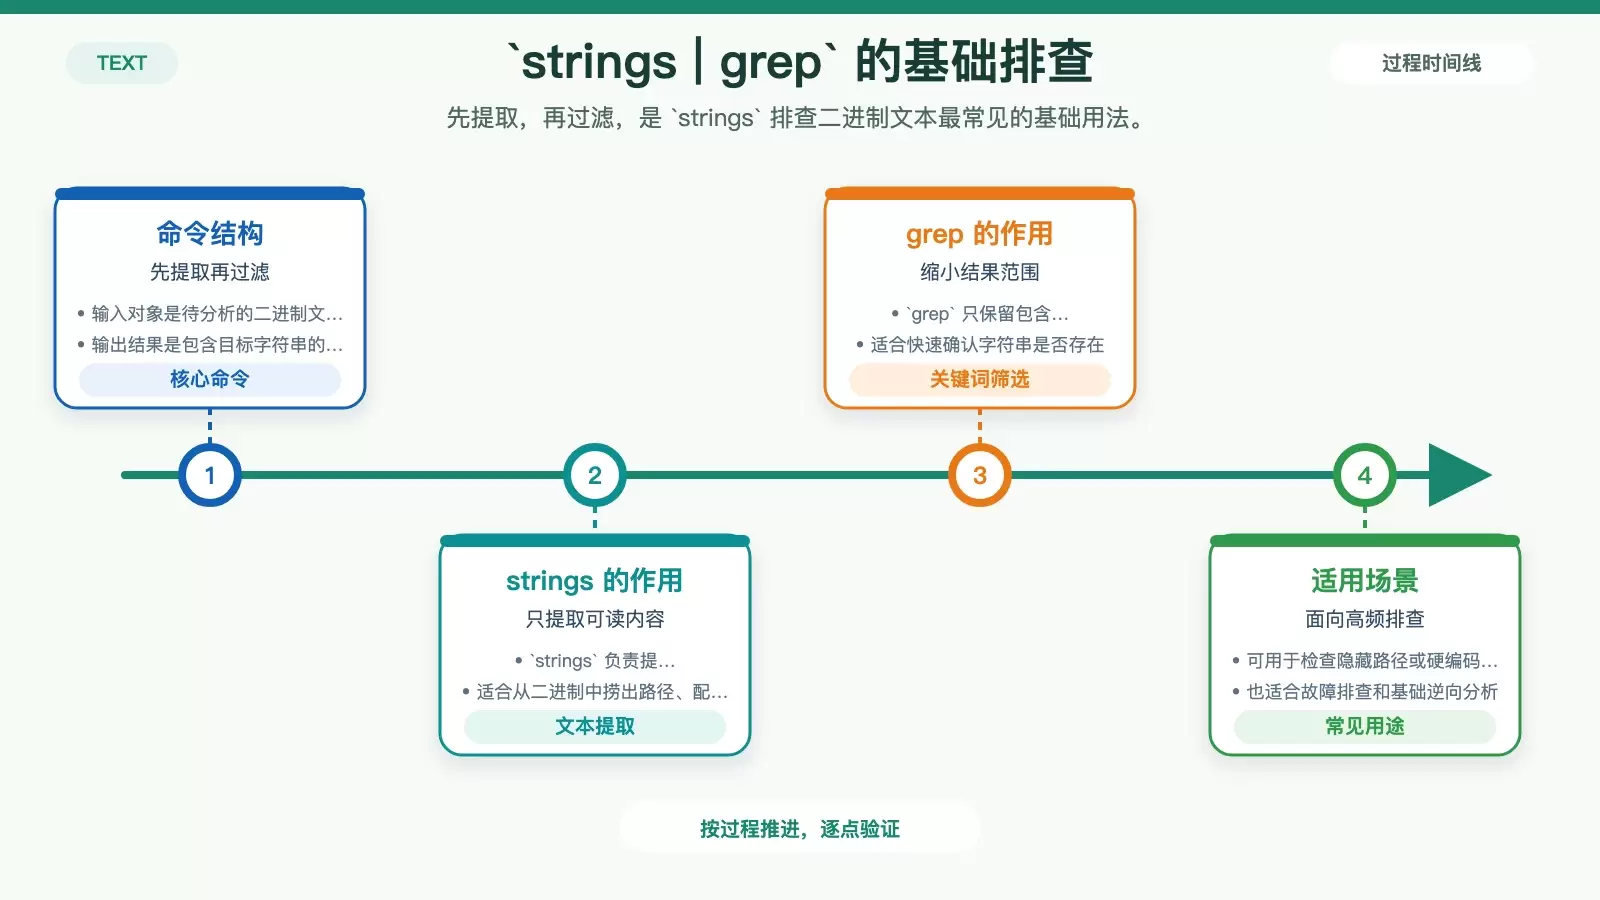
排查二进制文件时,`strings` 是最快能上手的文本提取工具之一。本文把最常见的两种用法拆开说明:先用 `strings | grep` 定位目标字符串,再看如何结合 `grep -n` 与 `awk` 输出匹配结果及对应位置,适合逆向分析、审计和故障排查场景。
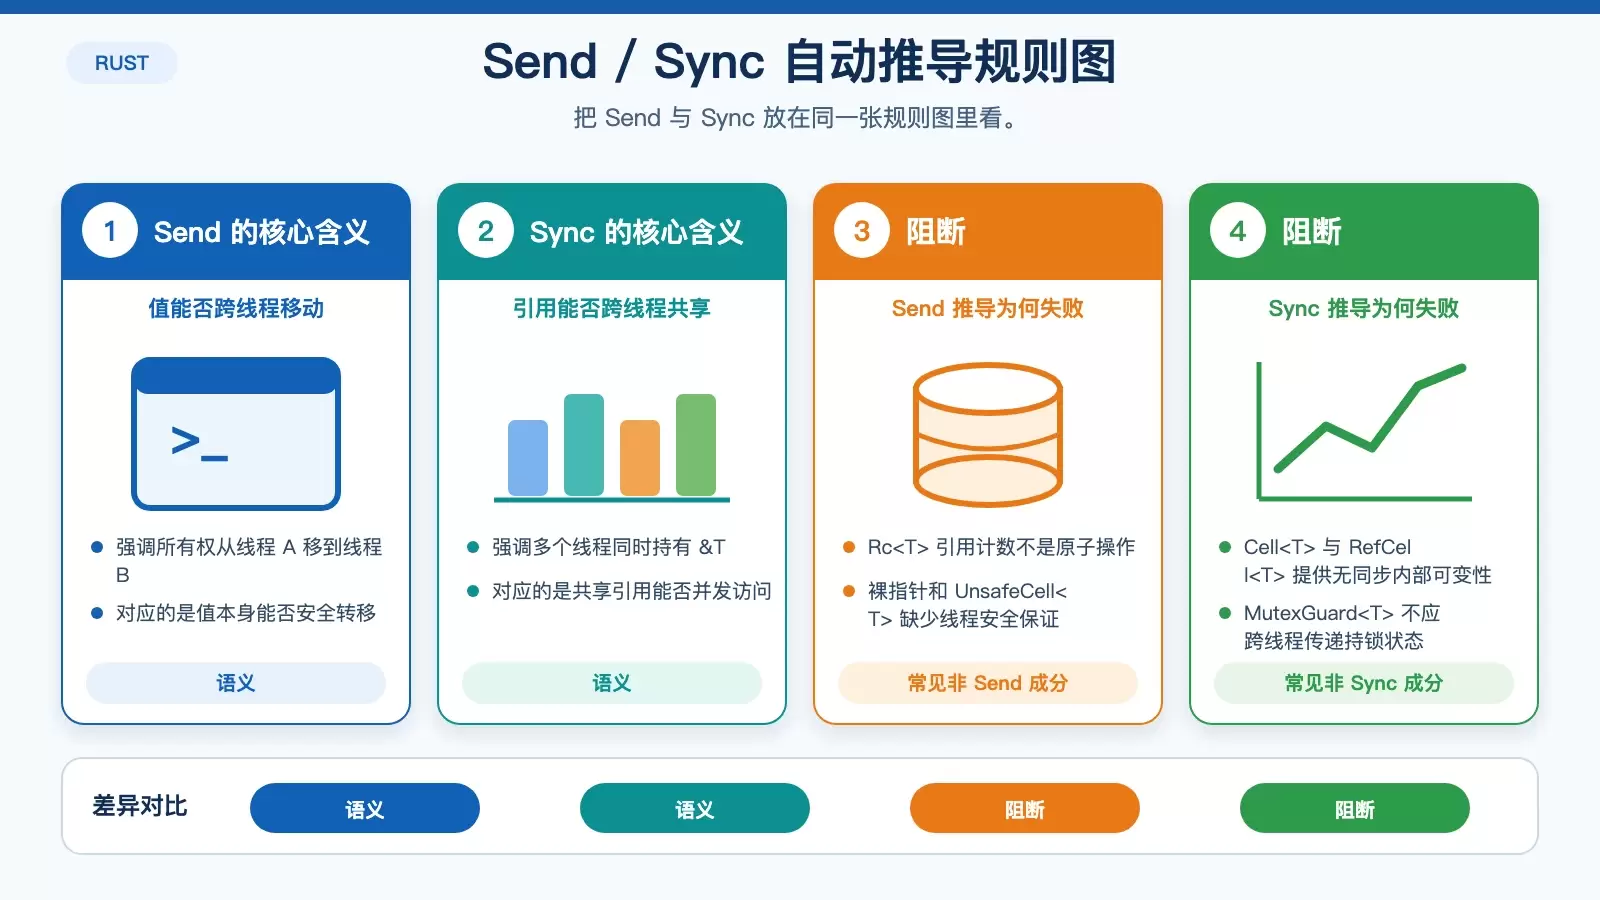
这篇文章围绕 Rust 的 `Send` 与 `Sync` 自动推导机制展开,解释它们如何在编译期拦住线程不安全代码,并结合 `Rc`、`Arc`、`Mutex`、`PhantomData` 与 `unsafe impl` 等典型场景,帮助读者判断什么时候能依赖自动推导、什么时候必须自己承担并发安全契约。
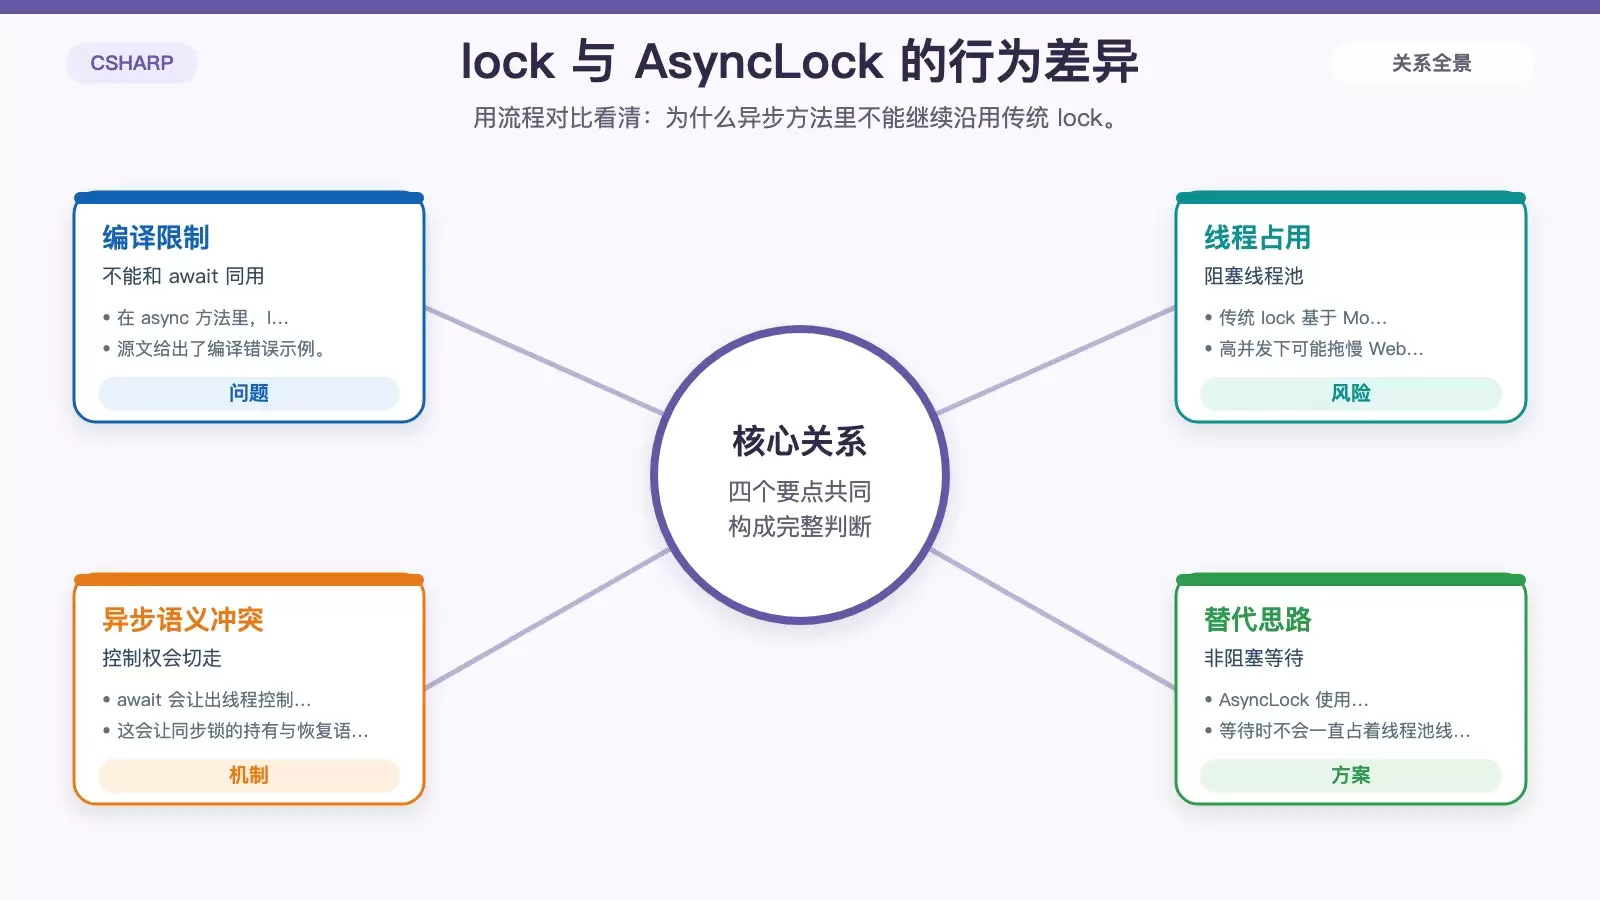
AsyncLock 是 .NET 异步代码里常见的互斥方案,核心价值是用非阻塞方式保护共享资源。本文从传统 lock 为什么不适合 async/await 讲起,再拆解基于 SemaphoreSlim(1, 1) 的实现思路、常见用法、与 SemaphoreSlim 的区别,以及超时和取消等扩展场景。
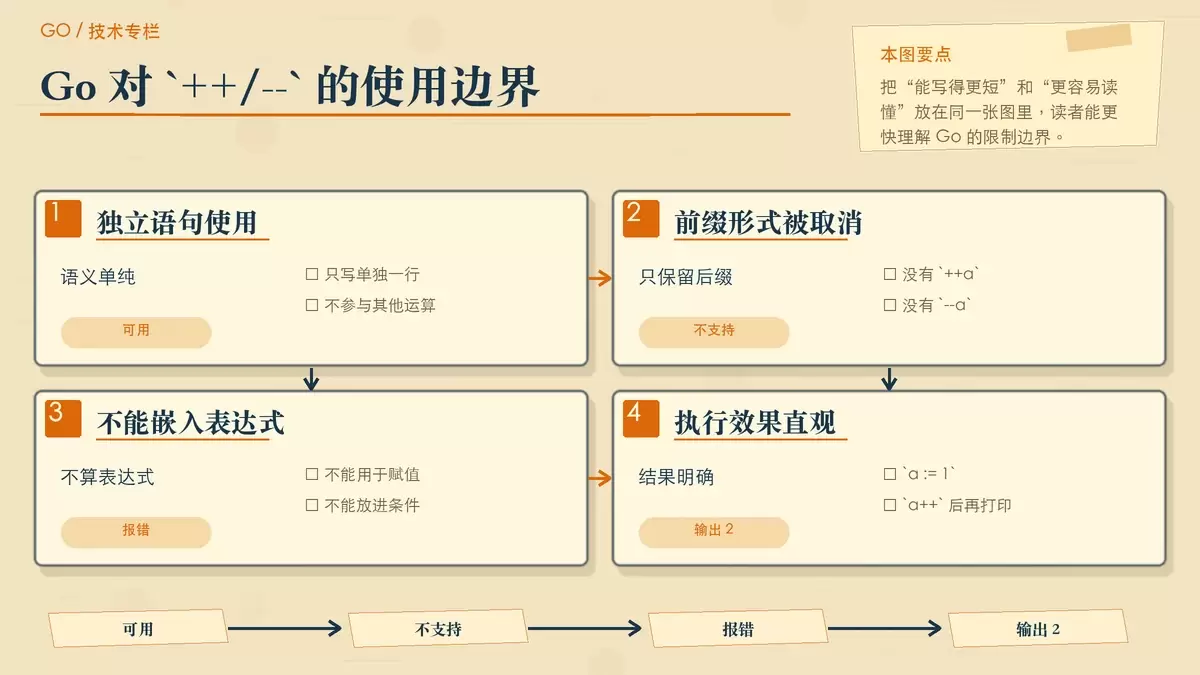
Go 把 `++` 和 `--` 定义成语句而不是表达式,看上去像是少了点“灵活性”,本质上却是在主动规避歧义。理解这个设计后,你会更容易判断哪些写法在 Go 中合法,以及它为什么更强调可读性、求值顺序和团队协作中的一致性。
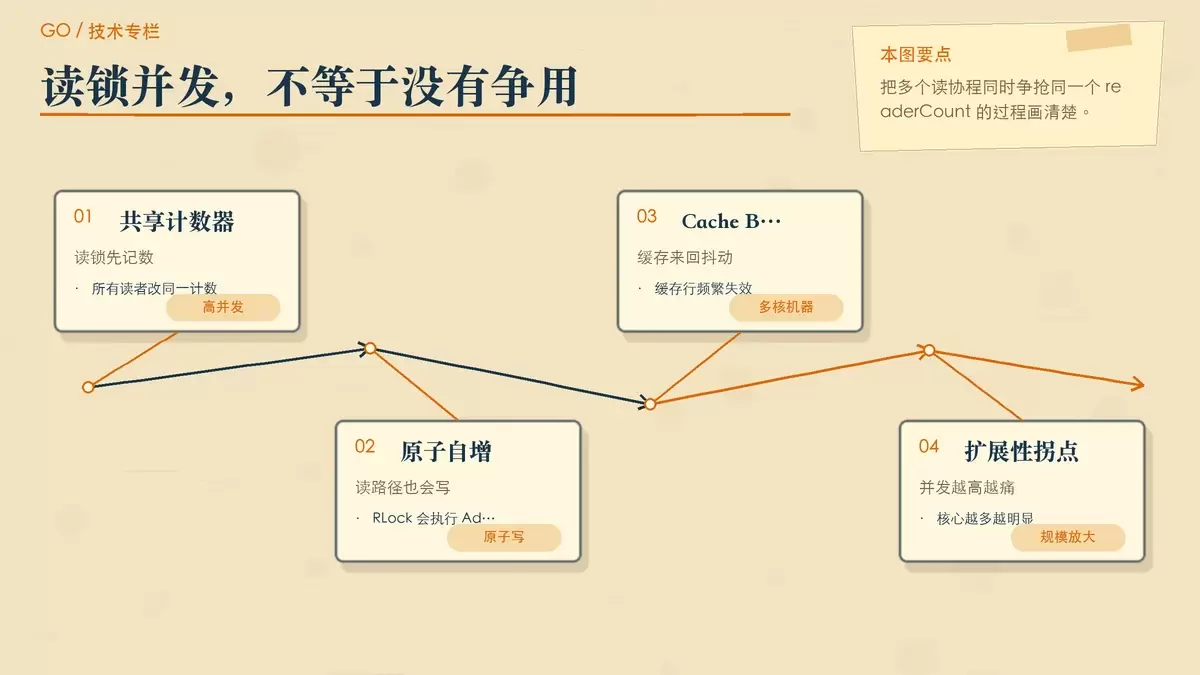
读多写少并不等于可以直接把互斥锁换成 `sync.RWMutex`。在高并发和多核环境下,读写锁的读路径同样要做原子写入,既可能引发缓存抖动,也会在写入到来时让新读请求排队。本文结合 Go 1.19+ 的实现细节,说明 `RWMutex` 何时有效、何时退化,以及 `atomic.Value` 在极端读多写少场景中的工程替代方案。
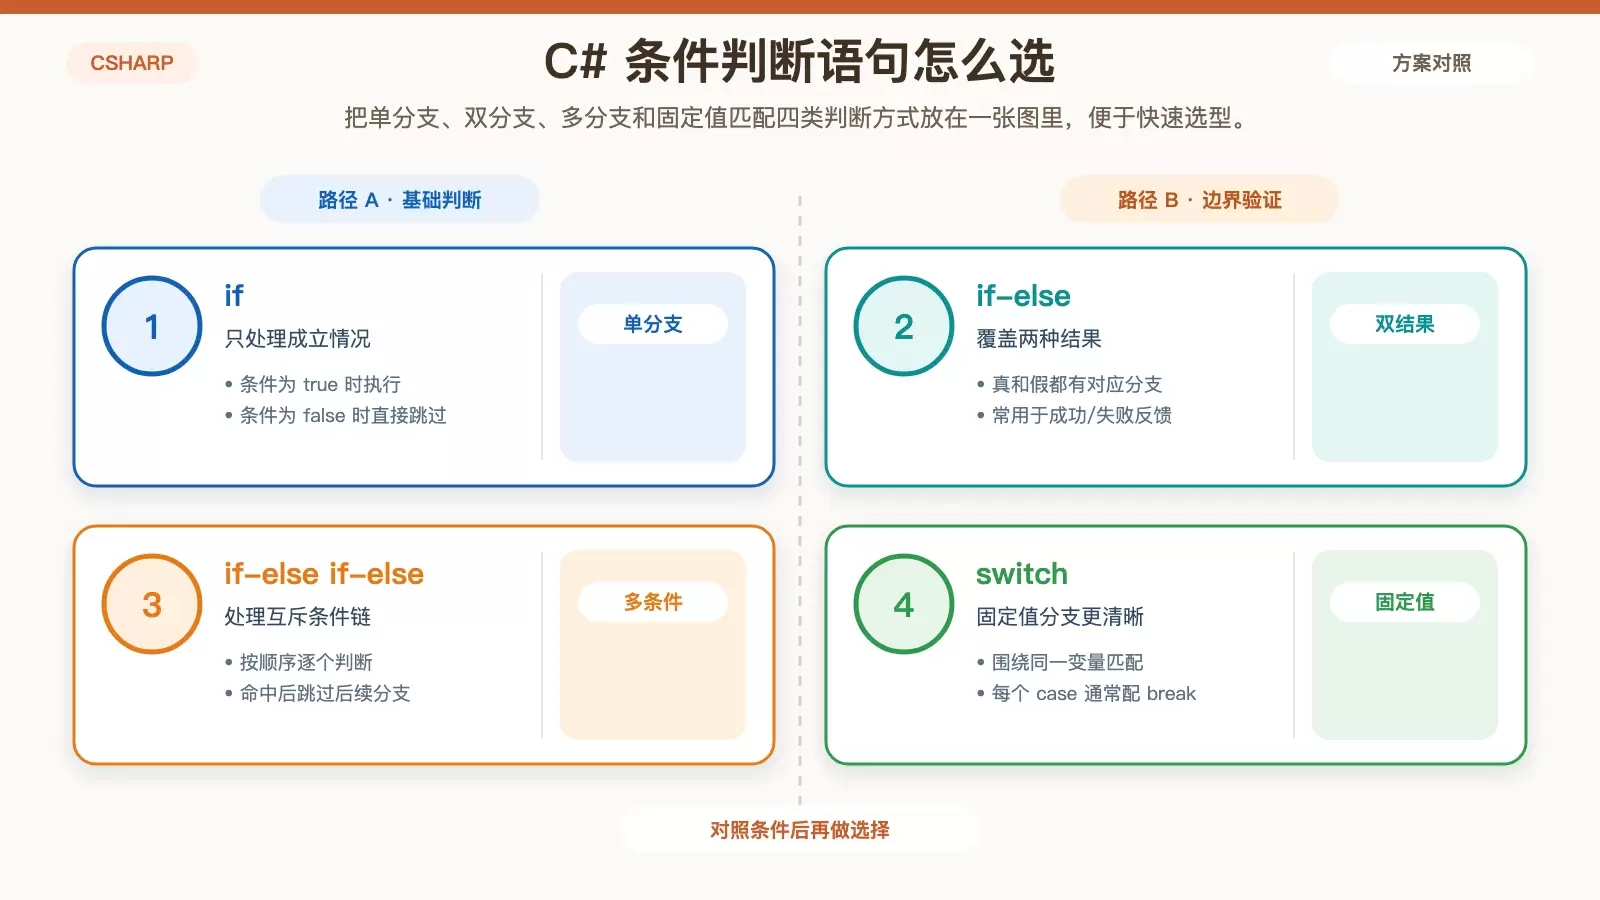
这篇文章按“先判断、再循环、最后控制退出”的顺序,梳理 C# 中最常用的控制流语句。你可以快速分清 `if`、`switch`、`for`、`while`、`do-while`、`break`、`continue` 和 `return` 分别适合什么场景,也能直接对照示例理解执行过程。 写 C# 时,控制流语句决定了程序“何时判断、执行几次、什么时候停下”。很多初学者并不是记不住语法,而是不清楚不同语句分别适合处理什么问题。
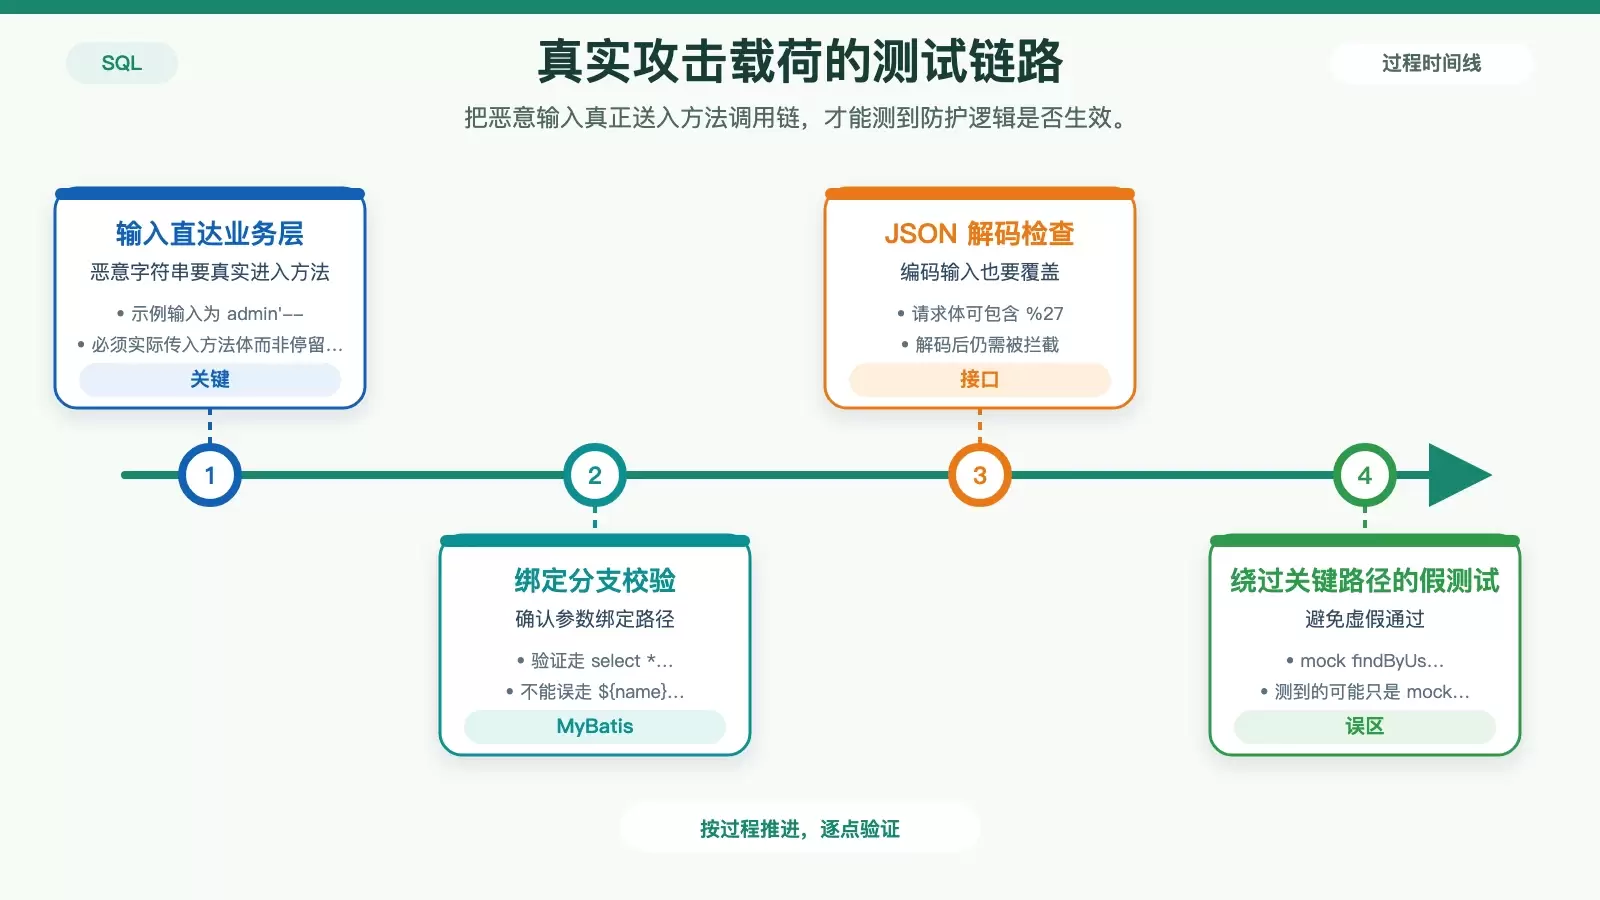
单元测试要验证的不是“接口没报错”,而是恶意输入是否在数据库执行前就被业务层拦截。本文围绕真实攻击载荷传递、异常断言、高危拼接分支、日志审计和二次注入覆盖,整理一套更可靠的 SQL 注入防护测试思路。
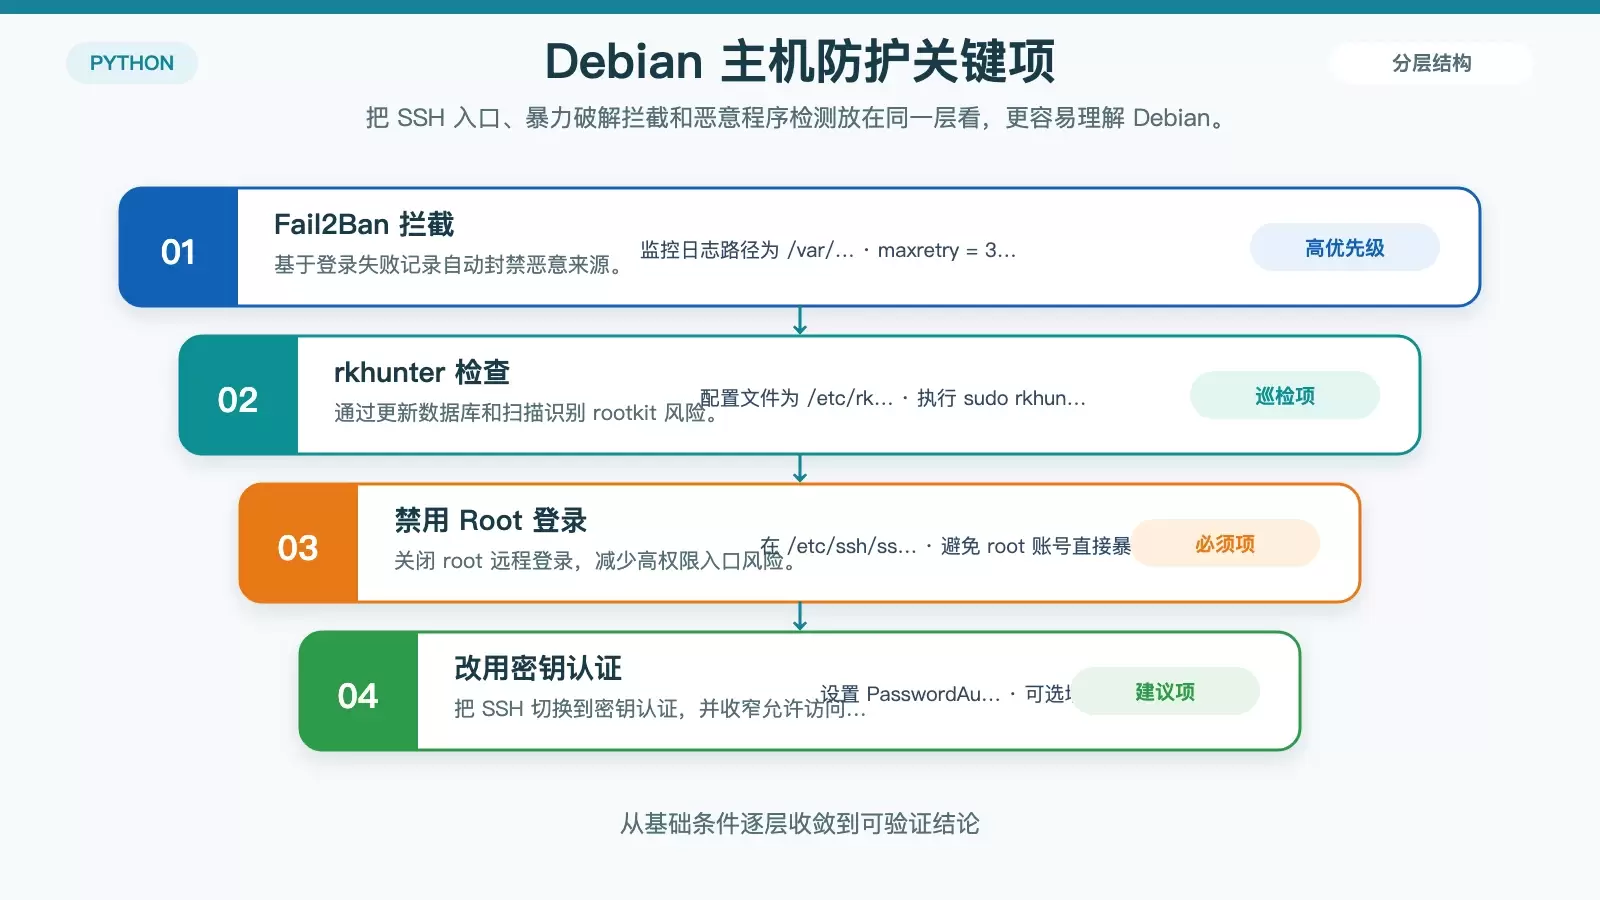
这篇文章把 Debian 上的 Python 安全配置拆成一套可直接执行的清单:先补系统和 Python 基础环境,再做虚拟环境隔离、SSH 与主机防护、依赖审计、代码层加固,以及可选的 SELinux 隔离,最后补上日常巡检重点。
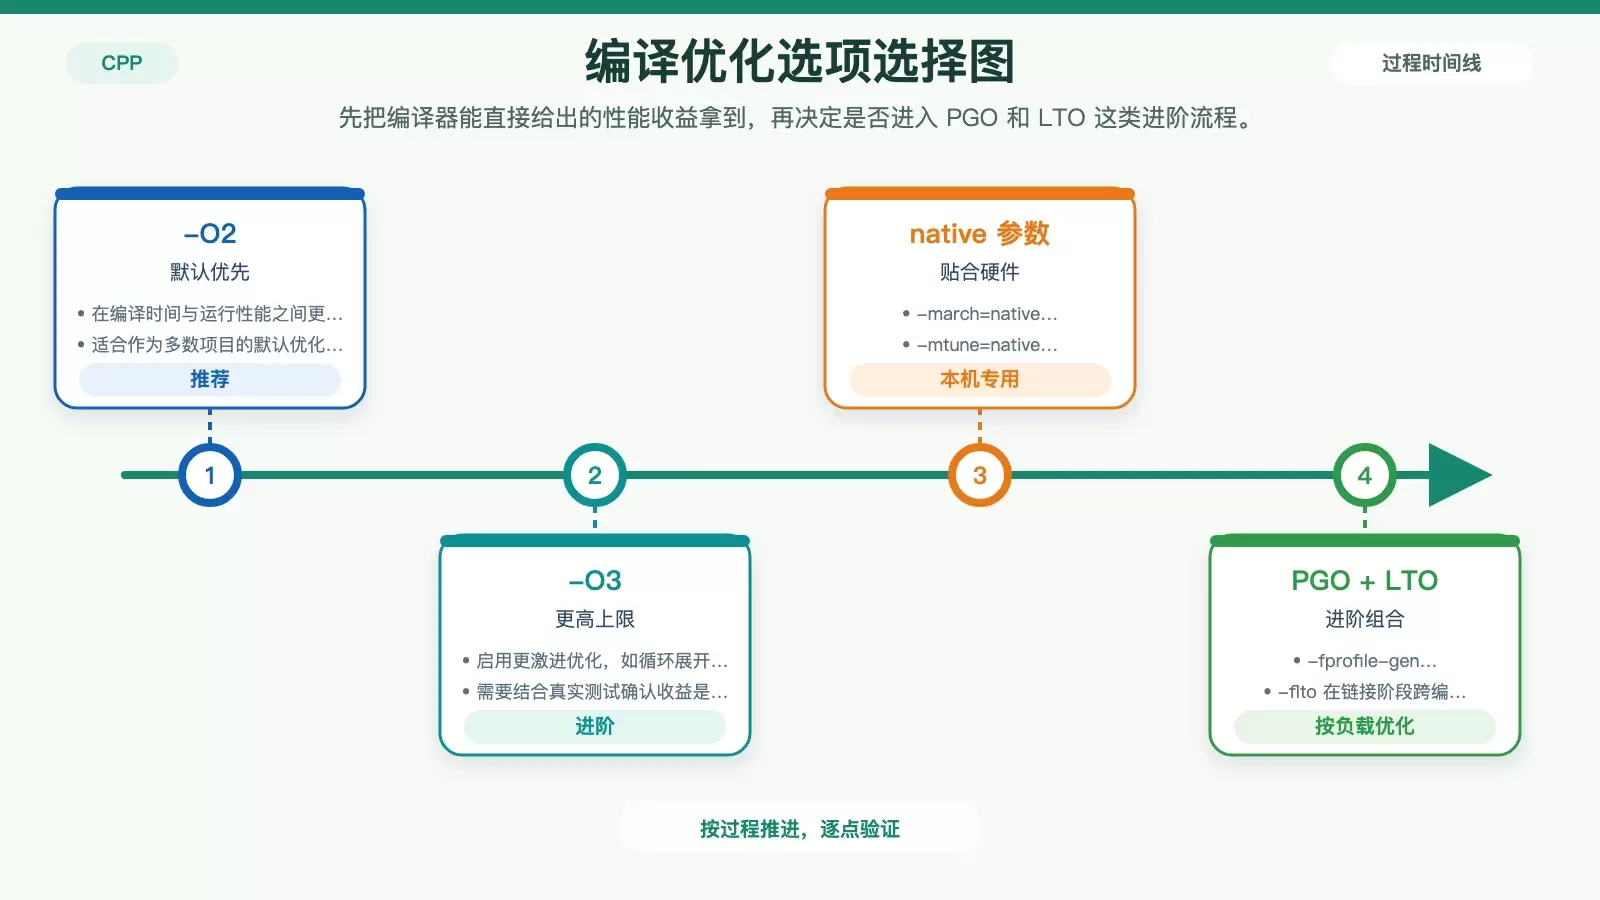
在 CentOS 上做 C++ 性能调优,先别急着改业务逻辑。更高效的做法,是按“编译选项、代码路径、系统参数、分析工具、硬件与库”这条链路逐层排查,用最小改动找到最有收益的优化点。 很多人在 CentOS 上做 C++ 性能优化,第一反应是重写热点代码,但实际更常见的情况是:编译参数没开全、容器和内存策略没选对,系统默认配。