

Python NumPy基础:数组操作与深度学习入门指南
本文详细介绍Python中NumPy库的基础应用,涵盖数组创建、维度转换(ndim/shape)、等差/等比数列生成及初始化方法。作为深度学习的核心计算库,掌握NumPy是理解TensorFlow等框架中张量概念的关键,适合AI初学者入门学习。
2026-10-13
21

本文详细介绍Python中NumPy库的基础应用,涵盖数组创建、维度转换(ndim/shape)、等差/等比数列生成及初始化方法。作为深度学习的核心计算库,掌握NumPy是理解TensorFlow等框架中张量概念的关键,适合AI初学者入门学习。
本文介绍使用Python生成XML报文的两种常见方法。第一种通过循环自增ID并拼接时间戳生成基础报文,适用于MQ接口发送场景;第二种基于预定义模板,利用列表遍历和字符串替换功能生成多行XML节点。代码包含完整实现逻辑,可直接参考用于实际开发中的报文构造需求。
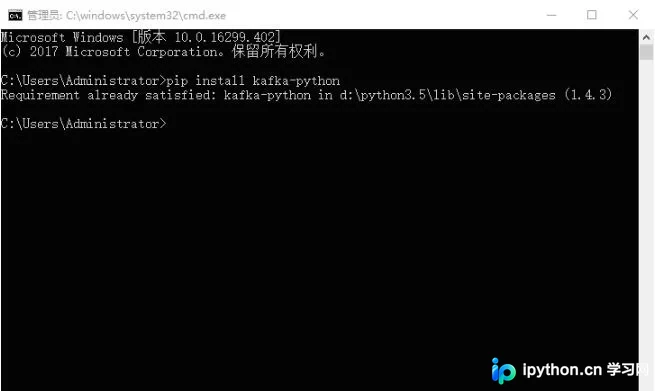
本文介绍如何在Python 3.5.x环境中利用Kafka 1.4.3构建跨平台数据中转站。通过配置KafkaProducer与KafkaConsumer,结合Pandas处理CSV数据,实现从数据源到目标端的实时传输。文中详细说明了环境准备、代码实现及关键注意事项,包括服务器地址配置、JSON序列化转换及编码处理,旨在为开发者提供一套完整的实时数据同步解决方案。
本文介绍如何利用Python的re模块及正则表达式,精准提取两个指定字符或字符串之间的内容。通过示例代码演示findall函数的用法,展示如何从包含特定标记的文本中获取目标子串,适用于日志解析及数据清洗场景。
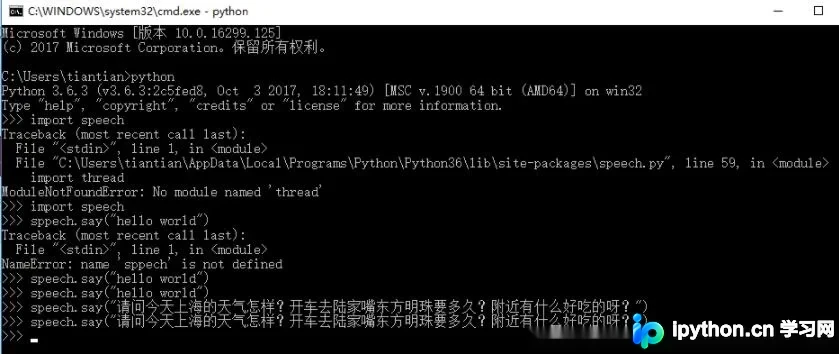
本文介绍在Windows环境下为Python3安装speech模块的完整流程。首先需安装pywin32以提供Windows底层接口,随后通过pip安装speech模块。针对Python3兼容性问题,需手动修改speech.py文件第59行的thread引用为threading。该模块支持文本转语音及语音识别功能,适用于本地语音应用开发。
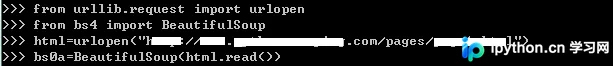
本文详细介绍如何使用Python构建基础爬虫架构。通过解析urllib库的网络请求功能与BeautifulSoup的HTML解析能力,演示从导入模块、打开网址到提取节点信息的完整流程。同时涵盖常见错误如HTTPError和None值的排查与处理,帮助开发者掌握基础爬虫的核心步骤与异常处理机制。
本文详细介绍如何使用Python编写爬虫程序抓取新浪新闻。通过安装requests和bs4库,模拟浏览器请求获取原始数据,并解决常见的乱码问题。接着利用浏览器开发者工具定位HTML标签,结合BeautifulSoup解析提取新闻标题、发布时间及链接,最终实现结构化数据的自动采集。
本文详细介绍如何使用Python进行TCP端口扫描。从利用socket库建立全连接扫描器开始,演示如何检测主机开放端口。接着通过发送数据捕获应用标识以识别服务类型。为解决扫描延迟问题,引入多线程技术实现并发扫描。最后对比展示了使用nmap库进行扫描的方法,帮助读者掌握不同场景下的端口扫描技巧。
本文介绍如何使用Python将TXT文件中的多行内容合并为单行,并彻底去除中间及末尾的空格。通过readlines读取文件,利用strip()移除换行符,split()按空格分割字符串,最后使用join()重新连接。该方法适用于需要清洗文本数据格式的场景,代码简洁且高效。
本文介绍在 Python 中判断数字奇偶性的基本方法。通过取模运算符 % 计算除以 2 的余数,若余数为 0 则为偶数,否则为奇数。文章提供了标准实现及内嵌 if 语句的示例,并展示了具体的代码执行结果,帮助初学者快速掌握这一基础逻辑。
本文介绍利用Python脚本从文本文件中筛选包含中文字符行的方法。通过结合文件读写操作与正则表达式匹配Unicode范围,实现高效的内容过滤。文中提供了完整代码示例,解析了with语句的资源管理优势及正则匹配原理,适用于多语言版本处理场景。
本文深入解析Python中几种通用循环构造方法,包括允许用户交互的无限循环、通过特定数据终止的哨兵循环,以及基于文件行的读取模式。文章详细说明了哨兵值的设定原则、eval()函数的应用及readline()在文件处理中的关键作用,并指出处理含换行符的空行时需注意的细节,旨在帮助开发者掌握不同场景下的循环控制技巧。