

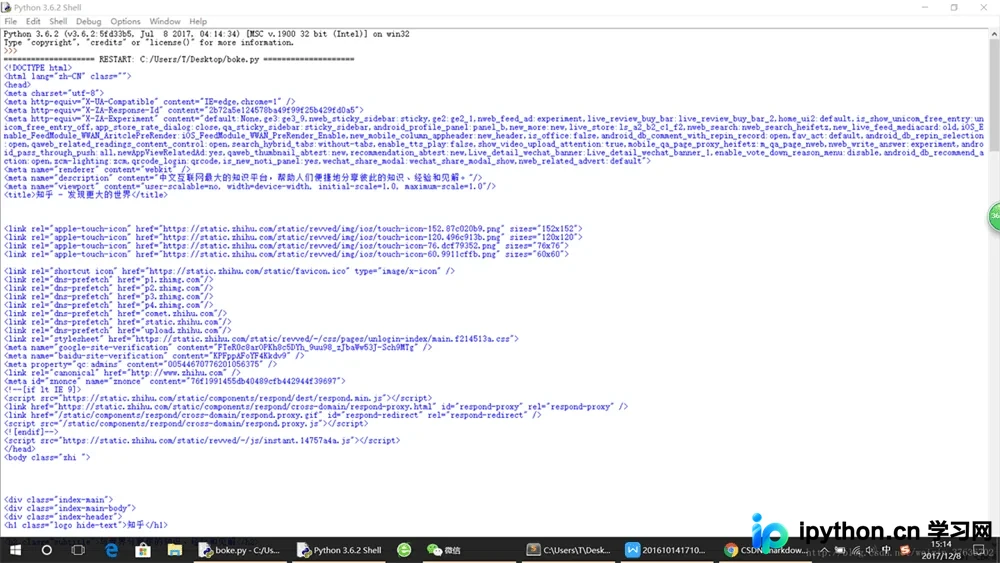
Python3爬虫入门:从知乎抓取源码到urllib模块详解
本文针对Python3环境提供爬虫入门指南,对比Python2差异,推荐边学边做。通过抓取知乎首页源码演示urllib.request.urlopen()用法,解析HTML并处理编码,介绍爬虫流程及数据提取存储方法,帮助初学者快速上手。
2026-10-13
20

本文针对Python3环境提供爬虫入门指南,对比Python2差异,推荐边学边做。通过抓取知乎首页源码演示urllib.request.urlopen()用法,解析HTML并处理编码,介绍爬虫流程及数据提取存储方法,帮助初学者快速上手。
本文介绍如何使用Python的pandas库实现Excel文件(xlsx)与CSV文件之间的相互转换。通过read_excel和to_csv、read_csv和to_excel等核心函数,可快速完成数据格式迁移,适用于日常数据处理与批量文件转换场景。
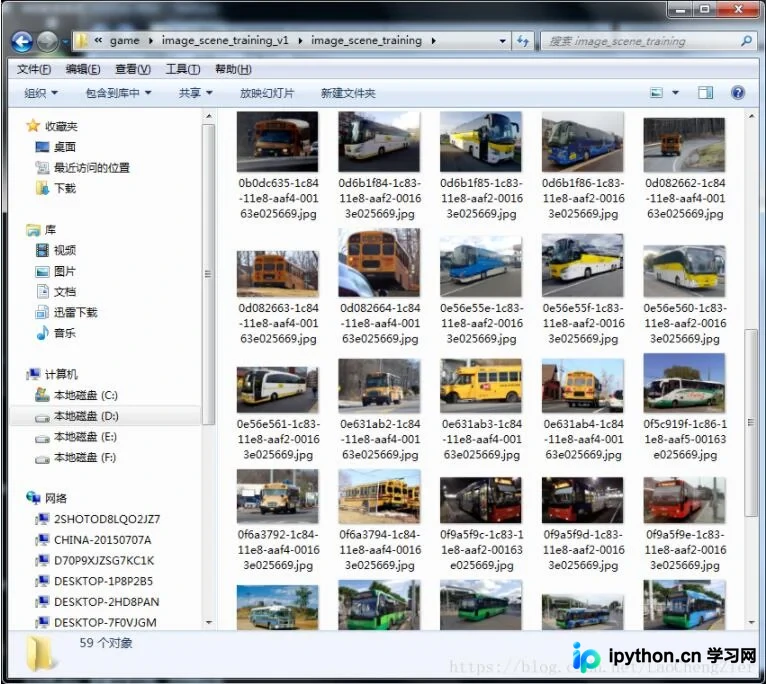
本文详解如何利用Python的glob模块查找指定目录下的所有JPG文件,并通过sort函数对获取的文件路径列表进行排序,确保按文件名顺序输出结果。
本文介绍如何利用Python脚本,结合pandas读取包含图片类别信息的CSV表格,并通过os和shutil库自动创建文件夹及移动图片。该方法适用于需要将大量图片按预设标签(如0-19类)批量整理至独立目录的场景,代码已优化修正,可直接参考使用。
本文介绍了如何使用Python的requests库通过POST方法访问RESTful服务接口。主要步骤包括构建包含数据的字典,利用json模块将其序列化为JSON字符串,设置请求头Content-type为application/json,最后发送POST请求并打印响应结果。该方法适用于需要提交JSON格式数据的API交互场景。
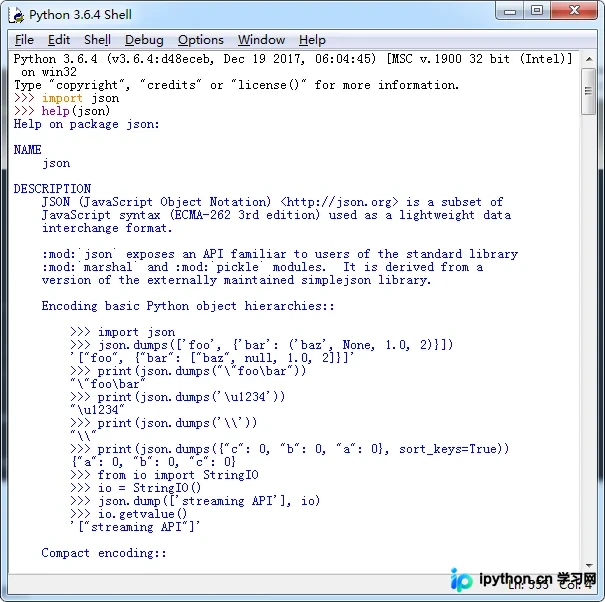
本文详细介绍Python中处理JSON数据的两种核心方法:解码[[wp:a0]]与编码[[wp:a1]]。通过具体代码示例,展示如何将JSON字符串转换为Python字典对象,以及如何将Python字典序列化为JSON格式字符串,并附带相关在线工具推荐。
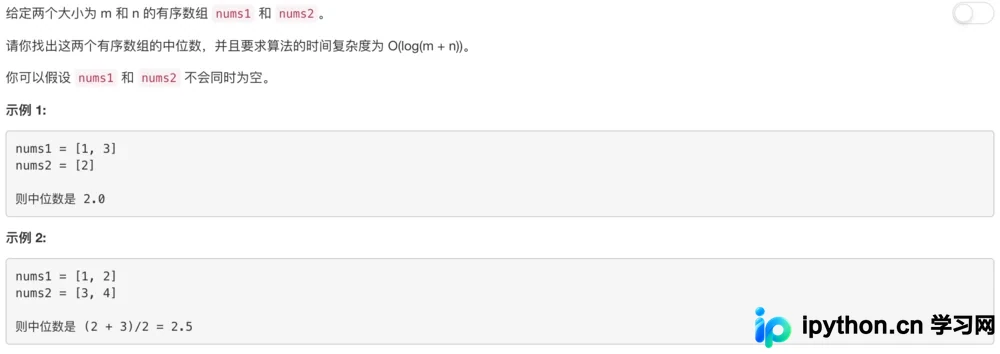
本文详解如何在Python中高效求解两个有序数组的中位数。通过二分查找法,利用递归思想与对称性定理,将时间复杂度优化至log级别。文章深入分析了数组长度差异时的元素剔除策略,并提供了完整的LeetCode标准解法代码,帮助开发者掌握核心算法逻辑。
本文详细介绍基于Python的身份证号码生成与校验工具。内容涵盖18位身份证的结构组成,包括区域码、出生日期、顺序码、性别码及校验码。重点解析ISO 7064:1983 MOD 11-2校验算法,并提供完整的Python代码示例,展示如何随机生成合规身份证号及验证校验码。
本文介绍 Python 中相对路径导入时遇到的 ValueError: Attempted relative import in non-package 错误。提供两种解决方案:一是通过 sys.path 添加父目录路径,二是使用 python -m 以 package 模式执行脚本。结合 __name__ 判断可兼容两种运行方式,确保模块正确加载。
本文深入解析Python中str与unicode对象的存储机制及拼接规则。str以字节码形式存在,其编码取决于解释器或文件声明;unicode则采用双字节存储以支持跨平台。通过正确的decode与encode操作统一编码格式,可避免拼接错误,确保中文处理无误。
本文详细解析Python命令行中-u参数的作用。默认情况下,Python的标准输出(stdout)采用缓存机制,而标准错误(stderr)直接输出。通过添加-u参数,可强制标准输出也采用无缓存模式,确保内容立即显示或写入日志文件。文章通过代码示例对比了有缓存与无缓存的输出差异,并指出Python 3环境下该参数行为可能存在的特殊情况。
本文介绍如何利用Python的string.Template模块,通过定义模板字符串动态生成PyUnit框架下的接口测试用例。示例展示了如何将测试参数化,自动构建包含请求头、数据及断言的测试方法,并结合BSTestRunner执行测试并生成报告。该方法适用于需要复用测试框架并批量生成用例的场景,代码基于Python 2.7.6环境编写。