

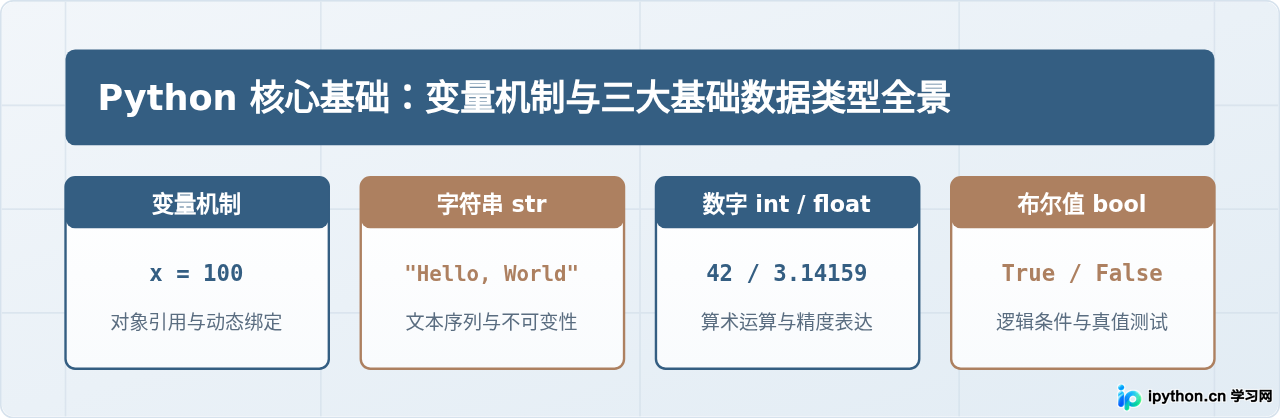
Python变量与数据类型详解:零基础理解字符串、数字和布尔值
面向零基础读者的Python变量与核心数据类型详尽教程,深入讲解变量引用机制、字符串、整数、浮点数与布尔值的原理、操作步骤及避坑指南。
2026-10-10
19

面向零基础读者的Python变量与核心数据类型详尽教程,深入讲解变量引用机制、字符串、整数、浮点数与布尔值的原理、操作步骤及避坑指南。
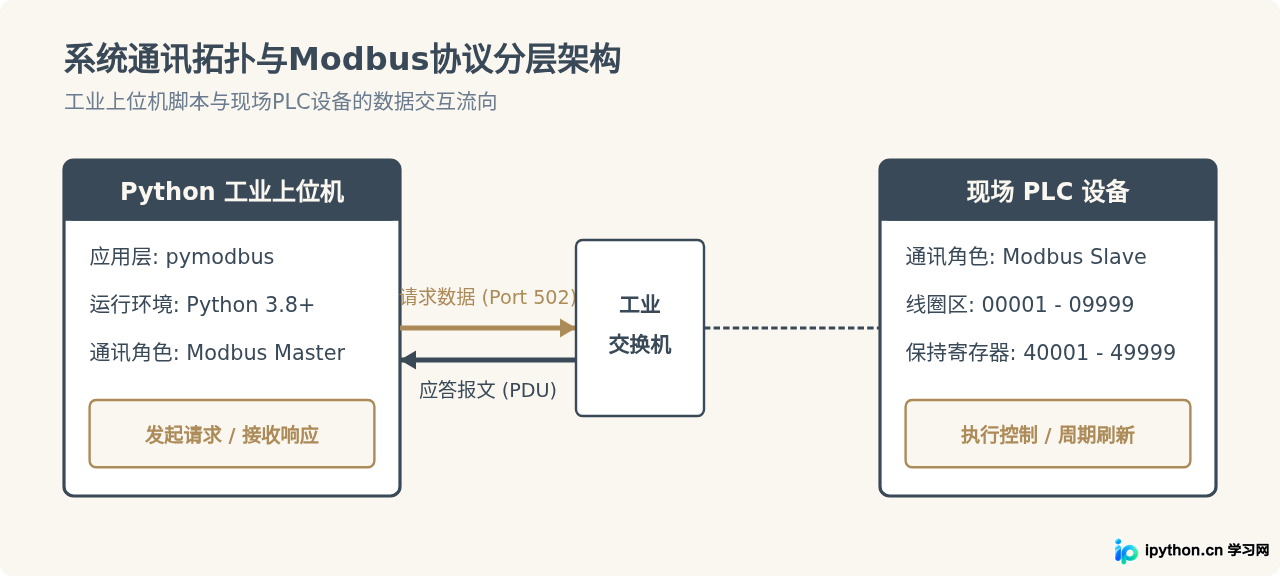
详细讲解在Python中使用pymodbus库通过Modbus TCP协议读写PLC数据,包括环境安装、地址映射规则、线圈与寄存器读写、浮点数解析及常见通讯异常排查。
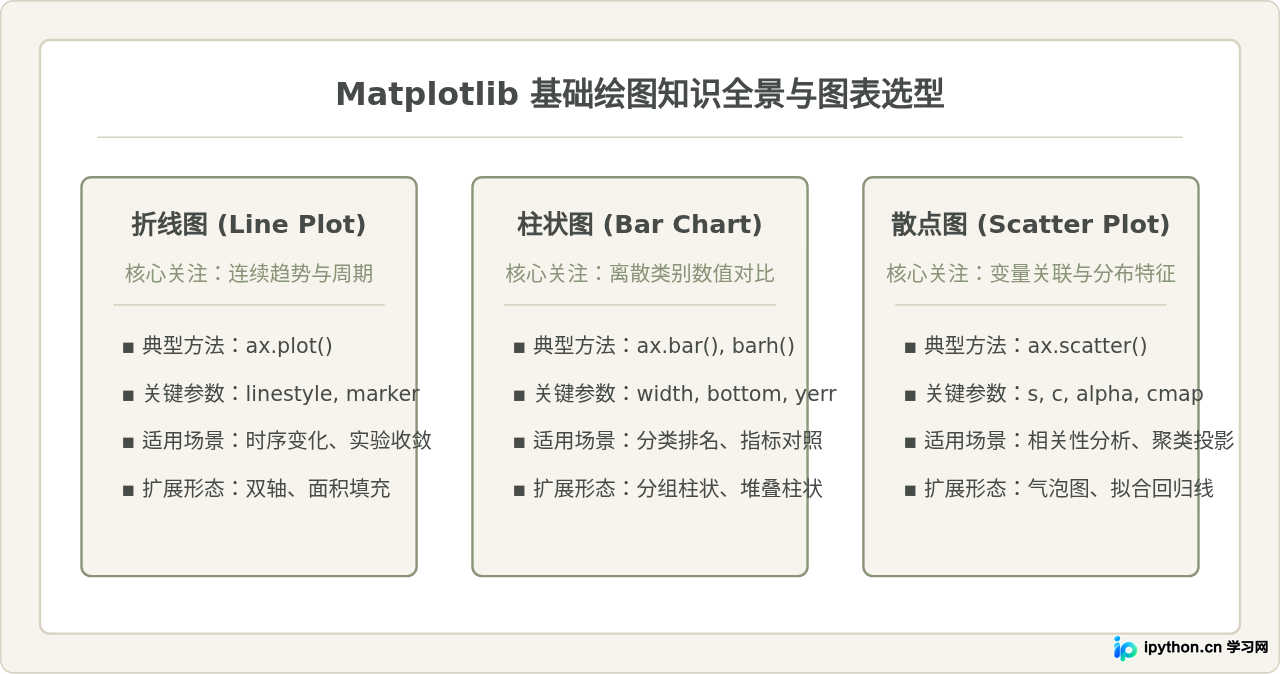
精选20个实用的Python Matplotlib基础绘图代码模板,涵盖折线图、柱状图与散点图的常见应用场景,提供规范的面向对象绘图代码与避坑指南。
本文介绍如何利用 Python 结合第三方库,将 PowerPoint 演示文稿高效转换为 PDF 格式。内容涵盖单文件完整转换、指定幻灯片提取、自定义 A4 纸张尺寸及批量目录处理。通过核心 API 调用与路径校验逻辑,实现稳定可靠的办公文档自动化转换工作流。
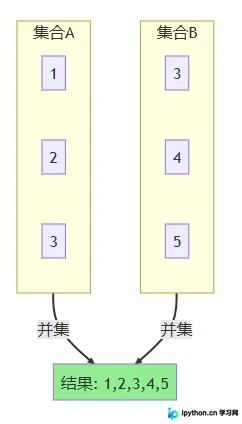
集合(Set)是 Python 中基于哈希表实现的无序且唯一的元素容器。本文系统讲解集合的三种初始化方式、核心增删方法、四则理论运算及原地修改技巧,重点演示列表与字符串的高效去重方案,并说明不可变集合 frozenset 在字典键与嵌套结构中的关键作用。掌握这些特性可显著提升数据处理效率与代码健壮性。
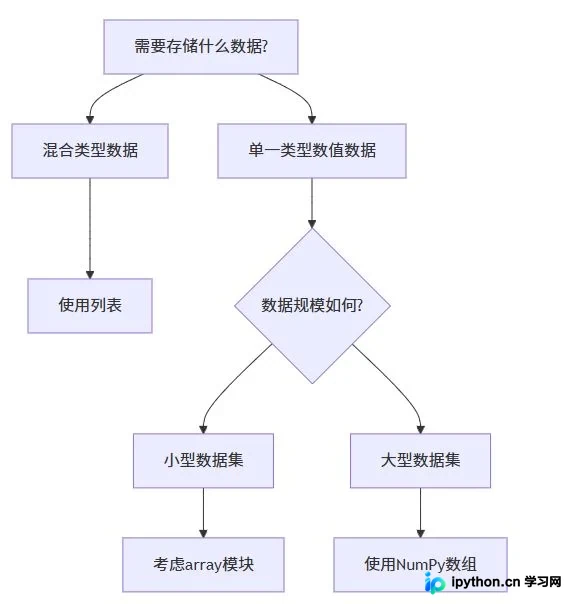
聚焦Python开发中异构数据管理与大规模数值计算场景,对比内置列表与NumPy数组的核心差异。通过内存分配机制、运算性能实测与类型参数说明选型逻辑,提供混合使用策略、视图切片与内存映射等进阶技巧,帮助开发者在灵活性与执行效率间做出最优决策。
面对PDF文档中的冗余页、敏感信息或重复排版,手动调整效率低下。本文基于Python生态,对比PyPDF2、Spire.PDF与PyMuPDF三大工具的特性差异,提供单页删除、多页面批量过滤及空白页自动清理的核心代码。结合内存耗时实测数据与加密文档处理技巧,帮助开发者快速定位技术选型并规避索引越界等常见陷阱。
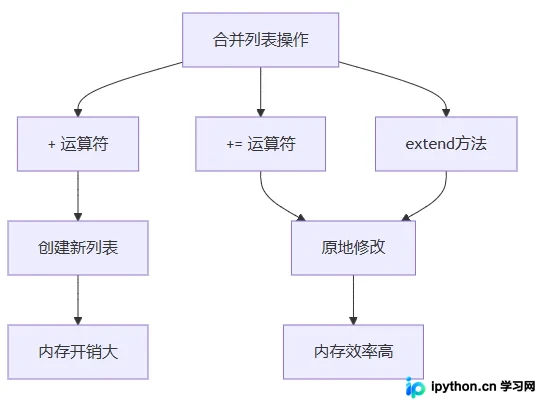
Python合并列表主要依赖`+`运算符、`+=`运算符与`extend()`方法。三者虽结果相似,但在原址修改、内存分配及数据类型兼容性上存在本质差异。本文结合底层执行逻辑与基准测试数据,明确各方法适用边界,提供高效编写列表拼接代码的选型策略。
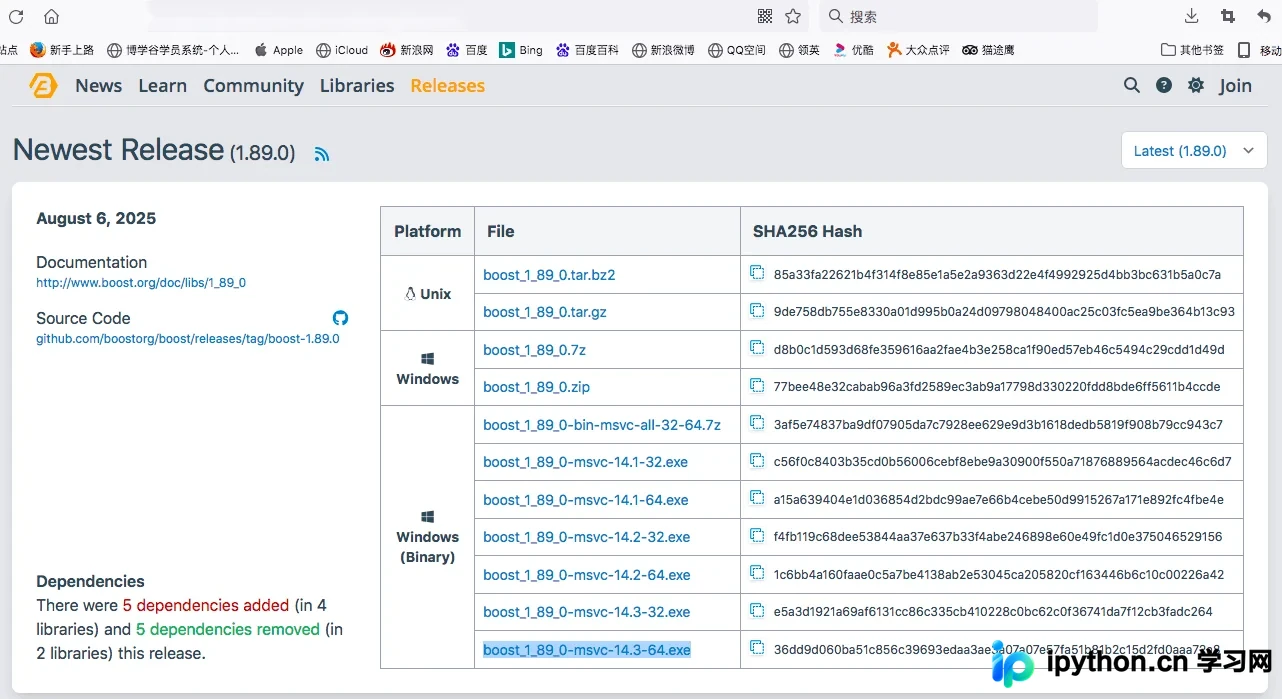
本文详细讲解在Windows环境下配置Boost.Python的全过程,涵盖从下载预编译包、生成b2工具、配置user-config.jam到使用MSVC 14.3编译静态库的完整步骤。同时包含Visual Studio项目属性设置、生成.pyd动态链接库文件以及Python端调用C++函数的完整代码示例与验证方法,帮助开发者实现C++代码向Python接口的无缝转换。
Python模块(Module)是组织与复用代码的核心单元。本文详细解析模块定义、四类导入语法、自定义构建流程、系统搜索路径配置及__name__执行守卫机制,提供从标准库调用到工程化包管理的完整操作指南,助力开发者规范书写高效代码。
本文演示如何利用Python库verify-email实现电子邮箱有效性校验。通过安装依赖包、编写核心调用函数,支持交互式输入单个邮箱检测,也能通过列表循环批量筛查无效地址,适用于日常数据清洗与爬虫预处理场景。

在多进程环境下同时读写同一文件极易引发数据交错或结构损坏。本文基于Python标准库(fcntl、msvcrt)与第三方filelock工具,演示共享锁、排他锁及字节范围锁的配置方法,结合日志追加与序列化数据处理的完整流程,说明如何通过合理控制锁粒度、设置超时与防范死锁保障高并发系统的IO安全。