

Python 注解方式实现缓存数据详解
本文介绍如何在 Python 中通过注解方式实现数据缓存机制,避免每次加载数据时重新执行 Load 操作。文章从基础的 Cache 类继承方案入手,分析其局限性,随后通过嵌套装饰器类进行优化,简化代码实现。内容涵盖缓存路径配置、MD5 哈希文件名生成、pickle 序列化存储及加载逻辑,并提供了完整的代码示例与注意事项。
2026-10-14
13

本文介绍如何在 Python 中通过注解方式实现数据缓存机制,避免每次加载数据时重新执行 Load 操作。文章从基础的 Cache 类继承方案入手,分析其局限性,随后通过嵌套装饰器类进行优化,简化代码实现。内容涵盖缓存路径配置、MD5 哈希文件名生成、pickle 序列化存储及加载逻辑,并提供了完整的代码示例与注意事项。
本文详细介绍基于Python和wxPython构建的光学透镜演示系统框架。重点解析如何通过几何算法计算光线与透镜表面的交点,区分数学表达式与绘图端点的差异,并封装光学元件与光源参数。通过wxPython实现友好的交互界面,展示光线传播路径及透镜参数调节功能,为光学仿真软件开发提供基础架构参考。
在SQL Server中还原数据库时,若提示数据库正在使用或无法获得独占访问权,是因为存在活跃连接。可通过将数据库设为单用户模式、重启服务或使用KILL命令强制断开连接来解决,本文介绍了图形界面与T-SQL脚本两种操作方式。
本文介绍如何利用Python的pynput库监控键盘和鼠标操作。通过创建后台进程,分别监听按键按下与释放、鼠标点击事件,并将这些输入行为实时记录到日志文件中。结合多线程技术可同时处理键盘和鼠标输入,最终通过日志分析还原用户操作轨迹。
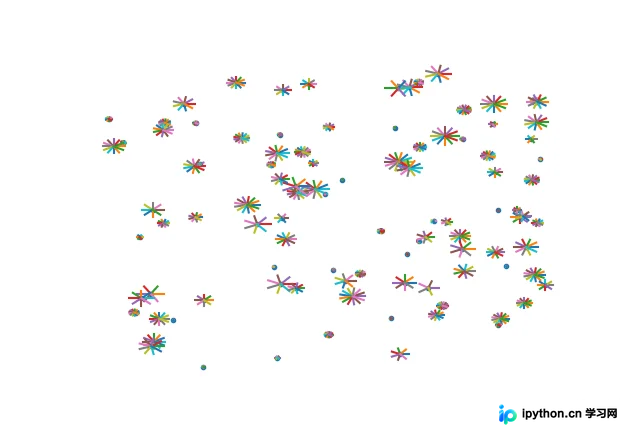
本文详细介绍如何使用Python和Matplotlib库,基于科赫曲线算法生成三维飘雪效果。内容涵盖从随机点枝杈绘制到科赫雪花生成逻辑,再到利用PolyCollection构建3D实心雪花的完整代码实现,帮助开发者掌握分形几何在图形渲染中的应用。
本文详解Python中利用StatsModels进行统计回归分析前的数据准备工作。内容涵盖从CSV、Excel及TXT文件读取数据,使用pandas进行数据拆分合并,以及缺失值、重复值和异常值的预处理方法,并附带完整代码示例。
本文详细介绍Python中的格式化输出技术。首先解析print函数的object、sep和end参数用法,接着对比C语言scanf,讲解%符号支持的%d、%f等格式控制及对齐补齐规则,最后深入探讨功能更强大的str.format()函数及其位置与命名匹配机制,帮助开发者掌握多种字符串格式化技巧。
本文介绍在PyCharm中使用pip安装Python第三方库时遇到Read time-out超时的解决方法。通过调整系统环境变量或直接在pip命令中增加--default-timeout参数(如设置为100秒),可有效延长等待时间,解决网络波动导致的安装失败问题。

本文对比了SQL Server中五种常见的数据分页查询方法,包括NOT IN、嵌套TOP、子连接JOIN、IN子查询及ROW_NUMBER函数。通过针对第1页和第1000页的实测数据发现,使用ROW_NUMBER()OVER()结合主键连接的方式在大数据量深层分页时效率最高且稳定。此外,文章提供了基于第四种方案的通用分页存储过程代码,适用于SQL Server 2005及以上版本,并提示了旧版本兼容性问题。
本文介绍如何将 SQL 时间格式函数转换为 SQLAlchemy ORM 语法。通过 db.func.extract 提取年月,或调用数据库特定函数如 to_char,实现与原生 SQL 相同的数据聚合效果,并提供完整的 Python 代码示例及生成的 SQL 逻辑分析。
本文深入解析C#中的dynamic关键字,阐述其如何简化反射调用及COM对象互操作。通过对比传统Reflection代码,展示dynamic在运行时绑定成员的优势。同时厘清dynamic与var的本质差异、类型转换规则及性能开销,帮助开发者在需要动态行为的场景中做出正确选择。
本文总结SQL Server中批量导入数据的四种核心方法。通过SELECT INTO实现同库表间快速复制;利用Excel作为中间工具进行数据清洗后导入;借助SQL Server Integration Services (SSIS)图形化界面或编程接口完成复杂转换与高效ETL;使用OPENQUERY与OPENROWSET直接连接Oracle等异构数据库并过滤数据。根据数据量、源库类型及清洗需求选择合适的导入策略。