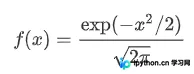pandas清洗与合并北京天津地区数据的完整流程
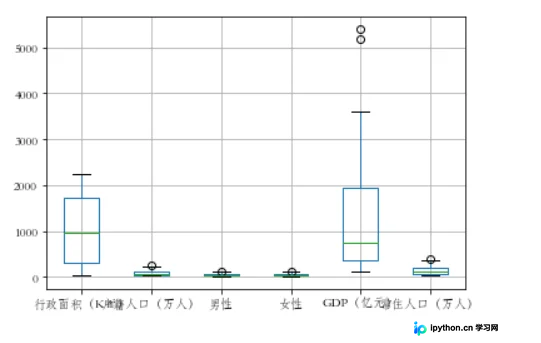
数据清洗是确保后续分析质量的关键环节,主要解决不完整、错误和重复三类问题。本案例演示如何利用 Python 的 pandas 库自动读取 CSV 文件,依次执行重复项过滤、空值均值填充、数值型字段箱线图异常检测,最后将两地表格安全合并。整套流程可快速复用于同类政务或业务数据预处理任务。
2026-10-12
19

数据清洗是确保后续分析质量的关键环节,主要解决不完整、错误和重复三类问题。本案例演示如何利用 Python 的 pandas 库自动读取 CSV 文件,依次执行重复项过滤、空值均值填充、数值型字段箱线图异常检测,最后将两地表格安全合并。整套流程可快速复用于同类政务或业务数据预处理任务。
在 Python 数据处理中,NumPy 是最核心的科学计算库之一。本文详解如何使用整数索引访问一维、二维及三维数组元素,并结合负索引语法实现从末尾向前取值,附带完整代码运行结果与参数对照说明。
本文详细演示如何利用Pygame库实现窗口内小球的流畅反弹动画,并通过面向对象思想将运动逻辑封装为独立类。在此基础上,进一步引入内置的动画精灵组件,结合spritecollide函数完成多球体之间的自动碰撞反馈,提供可直接运行的完整工程结构。
在Python桌面程序开发中,动态调整下拉列表的显示内容是提升交互体验的关键。本文将详细介绍如何使用Tkinter的ttk模块创建下拉列表控件Combobox,并提供完整的代码示例,演示如何初始化选项、运行时动态更换数据、重置默认值,以及如何准确获取用户选中的内容。
面对Python代码运行缓慢或内存占用过高时,如何精准定位瓶颈?本文系统介绍time模块、%%time魔法命令、line_profiler与memory_profiler四种工具,分别提供基础耗时统计、Jupyter环境快速测算、逐行耗时分析及逐行内存监测的完整操作指南与参数配置,帮助开发者快速优化程序性能。
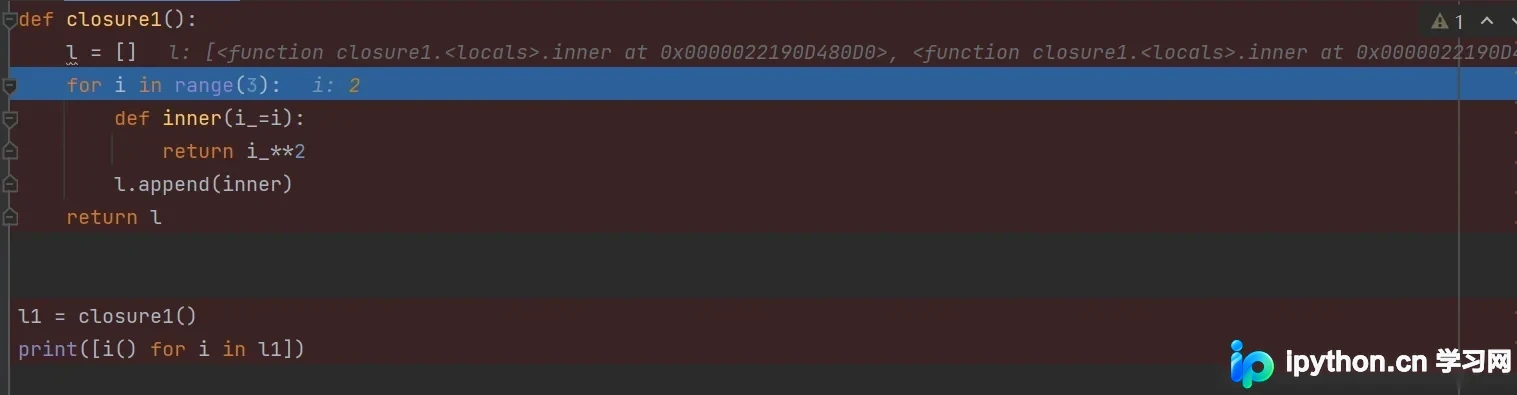
Python 闭包指内部函数引用外部作用域变量并保留其状态的技术。本文通过基础示例演示闭包的数据封装能力,并针对循环中常见的“闭包陷阱”(后期绑定导致变量共享)进行对比分析。通过默认参数捕获当前值的方法可彻底解决该问题,确保函数返回值符合预期。
本文详细拆解使用Pandas批量合并多张Excel表格的标准流程,涵盖有序文件遍历与无序目录扫描两种代码实现。同步给出身份证号等超长数字截断乱码的精准修复方案,助力高效完成底层数据汇总。
Python input() 是用于读取控制台键盘输入的内置函数。该函数始终以字符串形式返回内容,直接进行数学运算会导致拼接而非求和。本文将详细讲解 input() 的语法结构、默认行为特征,演示如何配合 int() 与 float() 完成类型转换,并梳理 Python 历史版本中输入函数的演变逻辑。
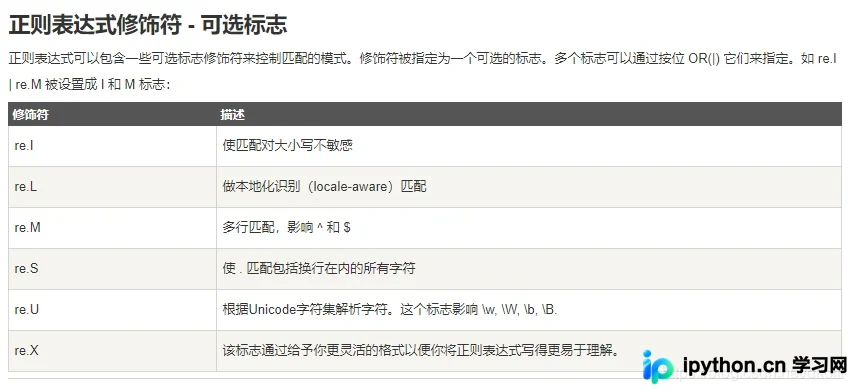
在Python文本处理中,手动逐个替换空格、制表符和换行符效率较低且易遗漏。本文对比了内置方法与正则表达式的实现差异,重点演示如何使用 re.sub 结合 \s 模式一次性清除字符串内所有类型的空白字符,并附带爬虫数据清洗的实际应用步骤与避坑指南。
在Python开发中,经常需要调用系统命令或第三方工具完成自动化任务。本文详细说明如何利用os.system快速执行简单命令,并重点演示subprocess模块的标准输出捕获、字符串解析及异步非阻塞运行机制,附带Windows磁盘空间检测实例,帮助开发者掌握跨进程交互的核心技巧。
本文通过Python基础实战案例,详细演示了如何安全读取本地文本文件,并使用字典(dict)进行高效的词频统计。借助内置的sorted()函数与列表切片技术,将复杂的键值对数据进行排序,最终精准提取出文件内出现次数最多的前10个单词。非常适合初学者熟悉Python的数据结构与文件流处理。
本文详细解析Python中scipy.stats.norm函数的用法。介绍通过直接调用与实例化两种方式设置均值与标准差的方法,对比概率密度(pdf)与随机抽样(rvs)的差异,并列出cdf、ppf等核心统计方法,帮助快速掌握正态分布建模与数据可视化。