

JavaScript正则表达式RegExp创建方式与核心属性方法详解
本文详解JavaScript中RegExp对象的两种创建方式(字面量与构造函数),重点说明标记flags的作用及字符串转义注意事项。系统梳理RegExp实例的核心属性(如source、flags)与关键方法exec(),帮助开发者快速掌握正则匹配技巧。
2026-10-13
22

本文详解JavaScript中RegExp对象的两种创建方式(字面量与构造函数),重点说明标记flags的作用及字符串转义注意事项。系统梳理RegExp实例的核心属性(如source、flags)与关键方法exec(),帮助开发者快速掌握正则匹配技巧。
本文介绍在Python中读写MATLAB数据文件(.mat)的方法。利用scipy.io模块中的loadmat和savemat函数,结合numpy处理数组数据,实现Python与MATLAB之间的数据交换。文中提供了读取和保存.mat文件的示例代码,适用于深度学习框架如Caffe的数据处理场景。
本文深入解析Go语言中interface的核心概念、实现机制及底层数据结构。通过隐式实现规则、值接收者与指针接收者的差异,以及iface和eface的内部布局,阐述接口如何驱动动态派发并影响程序性能。
本文详解OpenCV中cv2.watershed()函数的原理与应用。通过灰度拓扑模型解释算法机制,并介绍基于标记的分水岭算法以减少过度分割。结合Otsu二值化、形态学操作及距离变换,演示如何确定前景、背景及不确定区域,最终实现粘连对象的精准分割。
本文介绍在 Windows 环境下使用 Python 2.7 读取指定文件夹内所有文件名称及内容的方法。通过引入 os 模块,利用 os.walk 遍历目录获取文件路径列表,并结合文件读写操作提取内容。文中提供了完整的代码示例,并简要提及处理编码乱码时的 decode 方法,适合 Python 初学者参考实践。
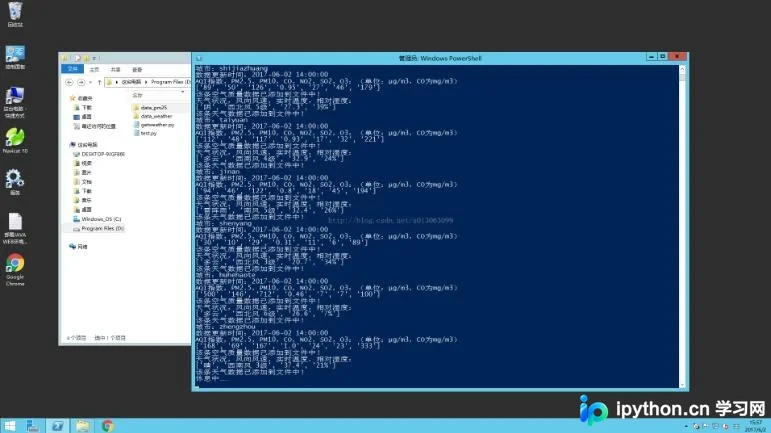
本文介绍使用Python3编写爬虫程序,定期抓取北京及周边省会城市的PM2.5和天气数据。文章详细记录了在爬取过程中遇到的UnicodeDecodeError编码错误,并通过修改解码方式为gbk解决。此外,针对服务器运行时的异常中断问题,增加了URLError异常处理与重试机制,确保数据连续采集。
本文详细介绍使用Python3结合Selenium库破解极验(Geetest)滑块验证码的技术方案。内容涵盖通过API获取缺口图与背景图,利用PIL库进行图像拼接还原,计算滑动轨迹,并通过ActionChains模拟真实人类滑动行为完成验证。代码包含完整的浏览器模拟、图像处理及自动化交互逻辑,适用于Python爬虫开发与自动化测试场景。
本文详细解析Go语言中两个特殊的保留函数:init函数和main函数。重点介绍了包的加载顺序、全局变量初始化以及init函数的多包执行规则。同时深入讲解了defer关键字的“后进先出”特性及其在资源释放和错误处理中的实际应用,附带代码示例说明其执行结果。
本文详解Python即时网络爬虫项目的启动背景,作者从C++转向Python的考量,以及“即时”在系统部署、数据流和模块集成层面的定义。项目旨在通过模块化提取器解决80%的数据抓取工作量,实现快速部署与批量数据收割。
本文介绍使用Python爬取最好大学网大学排名的具体代码。通过requests获取HTML,利用BeautifulSoup解析表格数据,并将排名、学校名称及总分等信息格式化输出,供学习者参考。
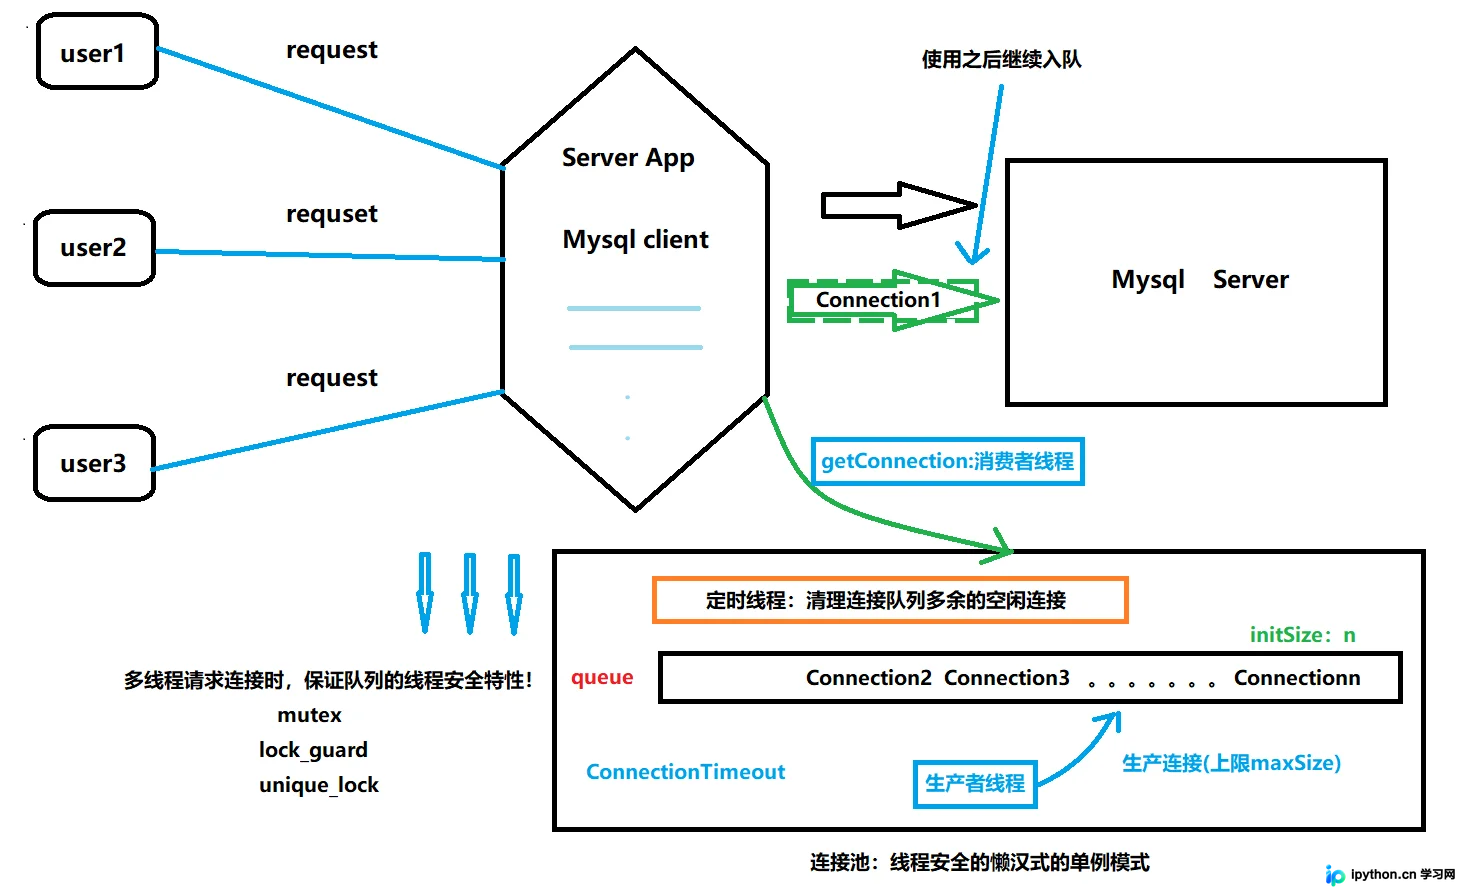
针对高并发场景下MySQL频繁建立TCP连接导致的性能瓶颈,本文介绍基于C++的数据库连接池设计与实现。通过单例模式管理实例,利用互斥锁和条件变量确保线程安全,结合生产者-消费者模型动态分配连接。文章详细拆解了初始连接、最大连接数限制、空闲回收及超时等待等核心机制,并附带有压力测试数据,展示使用连接池后显著缩短的操作耗时。
本文介绍使用Python抓取多页天涯论坛帖子的实战技巧。重点解析BeautifulSoup中find_all与select的选择器差异,演示如何利用zip函数合并作者与内容数据,并构建双层URL结构实现分页抓取,同时探讨多属性筛选的可行性。