C语言分支与循环语句:核心语法、避坑指南及代码规范
本文深入解析C语言中的分支与循环语句。涵盖if-else多分支逻辑、悬空else陷阱及代码书写规范;详解switch-case结构、default子句使用及break控制流机制;剖析while循环中break永久终止与continue跳过本次迭代的关键区别,助您掌握结构化编程核心。
2026-10-16
10

本文深入解析C语言中的分支与循环语句。涵盖if-else多分支逻辑、悬空else陷阱及代码书写规范;详解switch-case结构、default子句使用及break控制流机制;剖析while循环中break永久终止与continue跳过本次迭代的关键区别,助您掌握结构化编程核心。
本文详细介绍MySQL数据库主从同步的配置方法,通过Master-Slave架构实现读写分离、缓解服务器压力。同时利用二进制日志机制完成数据实时备份,提升系统的高可用性。包含端口规划、server-id配置、replication账号创建及GTID或Binlog位置同步等核心步骤。
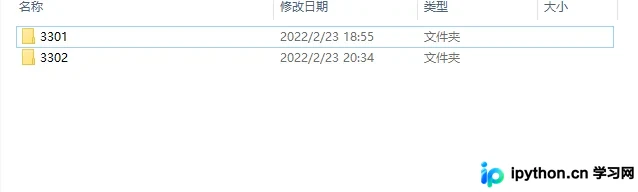
本文详细介绍Python中生成随机数字和字符的两种主要方式。首先解析内置random库,涵盖random.randint、choice及sample等函数的具体用法与代码示例。其次介绍Faker库的安装与配置,演示如何生成姓名、地址、身份证等多样化伪数据。通过对比两种方案,帮助开发者根据实际需求选择合适的数据生成工具。
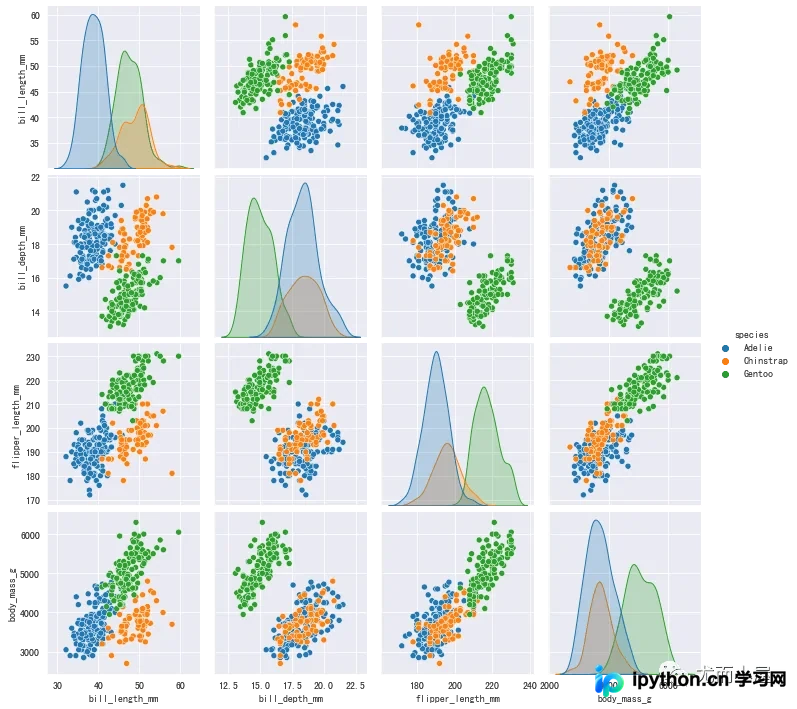
本文详细解析Seaborn库中pairplot函数的核心参数与用法。通过导入默认数据集,演示了kind、hue、diag_kind、palette等关键参数的配置方法,涵盖散点、KDE、直方图及回归等多种图形类型。文章提供了关于颜色控制、标记样式、尺寸调整、变量筛选及缺失值处理的完整代码示例,帮助用户快速掌握绘制高质量双变量关系图的技术。
本文深入解析Flask中Jinja2模板引擎的核心用法。涵盖变量{{ }}与语句{% %}的语法区别,演示如何传递字典、列表及对象至前端;详解if条件判断与for循环的实现方式;并通过block与extends标签解析模板继承机制,帮助开发者构建结构清晰、易于维护的Web页面。
本文详细介绍如何在QT中添加MySQL数据库驱动,通过下载对应版本的插件并配置环境变量来解决QMYSQL加载失败的问题。同时提供了完整的C++测试代码,演示如何创建表、插入数据以及查询,并说明了将libmysql.dll放置于可执行文件目录以解决运行时依赖缺失的方法。
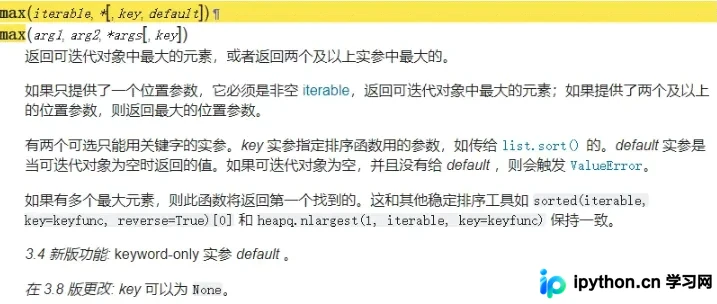
本文探讨在Python中如何优雅地获取最大值对应的变量名而非仅返回值。通过定义包含名称和值的自定义类,并重写__eq__、__gt__等比较魔法方法,使实例可直接参与max()函数比较。该方法避免了globals()遍历的冗余,结构清晰且逻辑顺畅,适用于需要同时获取极值及其标识符的场景。
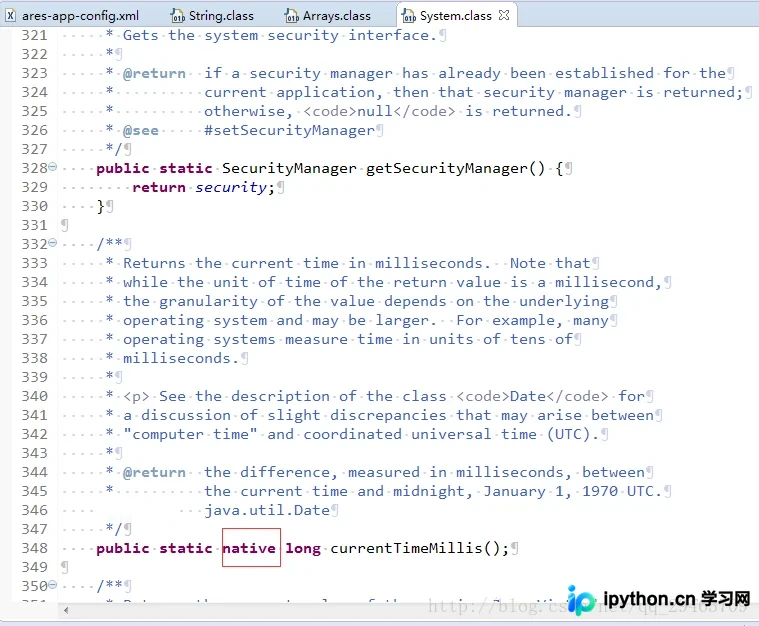
在Java开发中,Native修饰符用于声明由非Java语言(如C/C++)实现的方法。本文解析Native方法的定义、核心用途(如硬件交互、系统调用)、工作原理及加载机制,并通过代码示例说明其在JVM与底层环境通信中的关键作用,帮助开发者理解如何利用JNI扩展Java能力。
在Spring Boot开发中,同一接口存在多个实现类时会导致Bean注入歧义。本文对比了@Primary、@Resource和@Qualifier等基础手动切换方案与基于@ConditionalOnProperty的条件自动装配方案。通过配置项动态控制实现类的实例化,实现了无需修改代码即可在不同环境间灵活切换业务逻辑,提升了系统的可维护性与运维友好度。
本文介绍如何在WinForm应用程序中使用FormClosing事件,在用户尝试关闭窗体时触发确认操作。通过设置e.Cancel属性为true或false,可控制是否终止关闭流程。示例提供了完整的C#代码实现。
XML擅长数据存储但缺乏显示能力。本文详解利用XSLT(XSL Transformation)技术将原始XML数据转换为HTML页面的完整流程。通过DOM解析构建结果树,并应用格式化规则,实现数据与显示的完美分离,让杂乱的数据瞬间变得美观易读。
本文深入解析Pandas库中的query()方法,通过Titanic数据集演示如何替代传统的方括号索引进行更简洁的数据筛选。涵盖字符串匹配、变量引用、多条件组合、缺失值处理、索引查询及列间比较等核心用法,帮助开发者提升数据处理效率。