JavaScript 实现字符串与十六进制表示的相互转换
本文提供基于 JavaScript 的完整代码,演示如何在普通文本字符串与十六进制(Hex)表示形式之间进行双向转换。该方法常用于解决 SQL 注入测试或 XSS 漏洞利用中常见的 0x 前缀格式处理需求,包含字符编码解析、奇偶校验及自动清理前缀等细节逻辑。
2026-10-13
24

本文提供基于 JavaScript 的完整代码,演示如何在普通文本字符串与十六进制(Hex)表示形式之间进行双向转换。该方法常用于解决 SQL 注入测试或 XSS 漏洞利用中常见的 0x 前缀格式处理需求,包含字符编码解析、奇偶校验及自动清理前缀等细节逻辑。
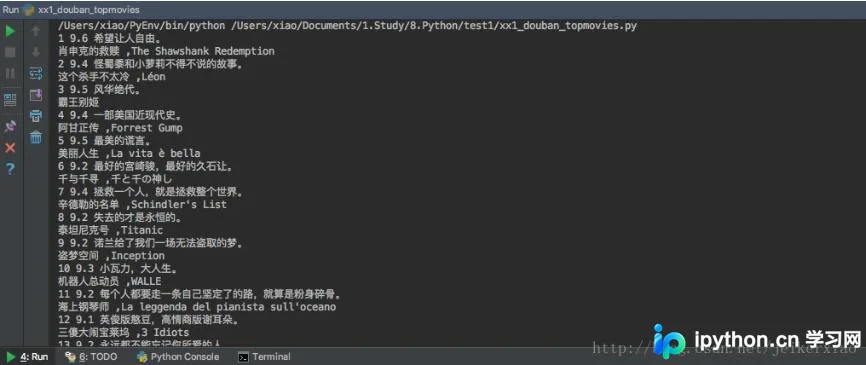
本文通过豆瓣电影Top250及新浪新闻两个实例,详细演示了Python3中requests库发送HTTP请求与lxml库etree模块进行XPath解析的完整流程。内容涵盖会话保持、编码处理、节点定位及数据清洗,帮助开发者掌握基础的网页抓取与解析技术。
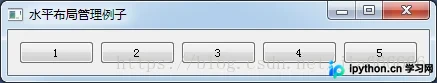
本文详细介绍 PyQt5 中 QHBoxLayout 水平布局控件的使用方法。涵盖从控件添加到间距设置,再到利用 Qt.Alignment 参数实现精确对齐的完整流程。通过具体代码实例演示如何控制按钮在水平方向的排列、伸缩量及垂直对齐位置,帮助开发者掌握 PyQt5 界面布局的核心技巧。
本文介绍如何使用Python的ElementTree库构建XML树,并重点解决etree.tostring()方法输出缺少XML头部声明的问题。通过对比tree.write()与tostring()的差异,提供了使用minidom解析或设置write参数xml_declaration=True两种解决方案,确保生成的XML文件包含标准的版本声明。
本文介绍如何使用C++标准库中的queue容器,配合指针操作,以非递归方式实现二叉树的广度优先遍历(层次遍历)。文章提供了核心算法逻辑、完整的可编译代码示例及运行结果分析,帮助开发者掌握数据结构中常用的图搜索技术。
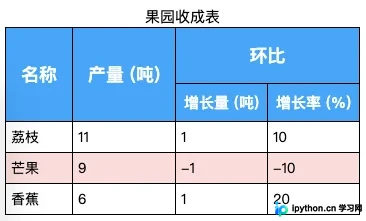
本文介绍如何利用Python的html-table库生成复杂的HTML表格。通过实例演示从安装配置到创建表格、处理合并单元格及自定义CSS样式的完整流程,重点讲解rowspan和colspan的使用,以及如何精细化控制表格边框、字体及背景颜色,适用于邮件报表等需要动态生成HTML的场景。
本文梳理 JavaScript 五大原始类型,重点解析数字类型的溢出、下溢及 NaN 判断机制,阐明 IEEE-754 标准导致的浮点数计算误差原理,并深入讲解 Unicode UTF-16 编码下的字符串特性、转义字符及不可变性质。
本文详细介绍Python3中xml.etree.ElementTree模块支持的有限XPath表达式语法。内容涵盖标签名、通配符、属性过滤、文本匹配及位置索引等核心用法,并通过具体代码示例演示如何在XML文档中精准定位子元素、孙子元素及特定属性节点,帮助开发者高效进行XML数据提取与处理。
本文详细介绍如何使用Python第三方库pygame开发经典的贪吃蛇小游戏。通过导入模块、初始化窗口、定义蛇与食物坐标类、处理游戏逻辑及渲染画面等步骤,完整展示了游戏核心代码实现。文章包含关键参数设置、碰撞检测机制及游戏循环控制,帮助开发者快速掌握pygame基础应用并实现可运行的贪吃蛇程序。
本文详解Python中XPath解析定位的六种核心方法。内容涵盖绝对路径与相对路径的区别、基于索引的定位、节点属性精确匹配、部分属性值模糊匹配(如contains、starts-with),以及多条件组合定位技巧。通过具体代码示例,帮助开发者掌握高效精准的网页数据抓取定位策略。
本文介绍如何使用原生 JavaScript 代码实现网页上的打字机特效。通过结合 setTimeout 定时器与 DOM 元素值操作,将完整字符串逐字符显示在输入框中,适用于简单的交互演示场景。
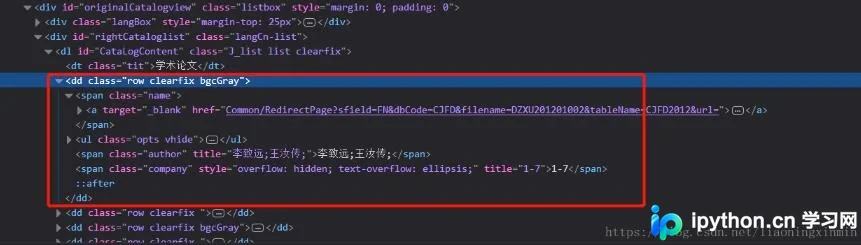
本文介绍如何使用Python的lxml库通过XPath定位HTML文档中的特定元素,并解决提取内容中出现的中文乱码问题。通过html.tostring获取字节流后,利用HTMLParser.unescape方法将HTML实体编码转换为可读字符串,从而完整保留原始文本内容。