Python多线程死锁原理与基于锁排序的解决方案
本文深入解析Python多线程中死锁的产生原理,通过哲学家就餐问题形象说明资源竞争导致的永久等待。重点介绍利用上下文管理器对锁进行统一编号和升序获取的解决方案,结合threading.local实现线程安全的锁包装,有效避免死锁并提升代码可读性。
2026-10-14
29

本文深入解析Python多线程中死锁的产生原理,通过哲学家就餐问题形象说明资源竞争导致的永久等待。重点介绍利用上下文管理器对锁进行统一编号和升序获取的解决方案,结合threading.local实现线程安全的锁包装,有效避免死锁并提升代码可读性。
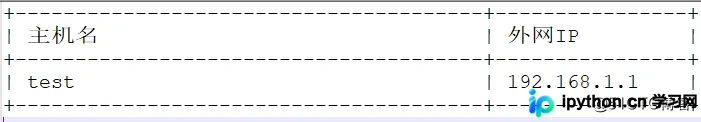
本文介绍如何使用Python3编写脚本,通过调用资产信息接口获取JSON数据,并利用prettytable库将主机名和外网IP等信息格式化为表格打印输出。脚本支持通过命令行参数指定查询名称,适用于服务器运维场景下的资产信息查询。
本文通过一个简单的代码示例,讲解 JavaScript 中 call 方法的用法及其在模拟微信 JSAPI 调用中的应用场景。通过分析 Class1 和 Class2 的对象实例,展示如何利用 call 改变函数执行上下文,以及该方法仅适用于方法而非属性的特性。
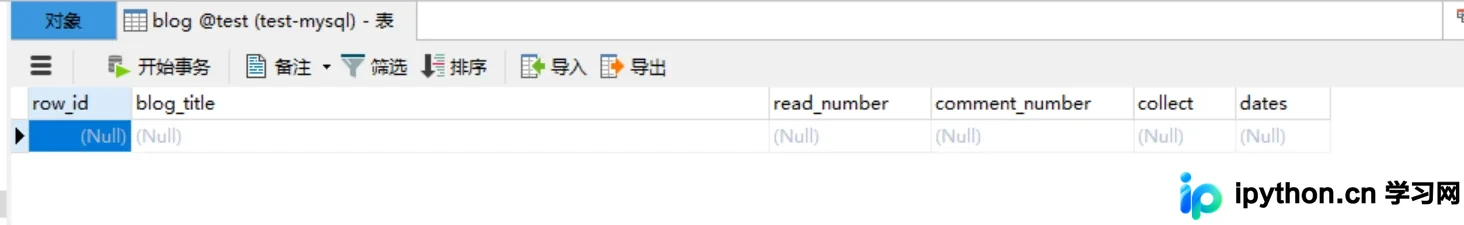
本文详解使用Python爬取51CTO博客数据并存储至MySQL数据库的完整流程。从环境配置、模块安装到代码编写,逐步展示如何解析网页结构、处理数据类型及入库操作。此外,文章进一步介绍利用PyInstaller将Python脚本打包为独立exe文件的技巧,便于非技术人员直接运行,实现数据抓取工具的便捷分发与使用。
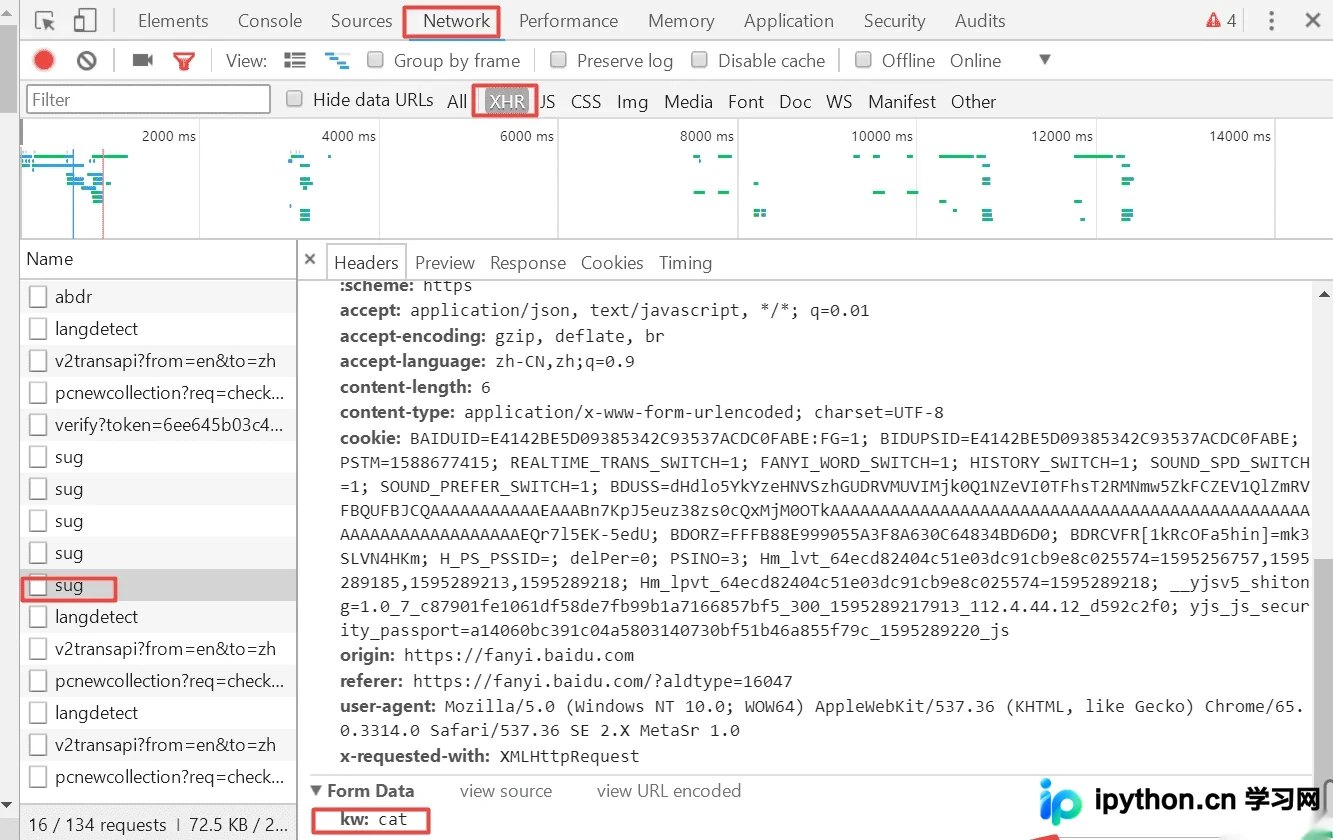
本文详细介绍Python中requests模块的安装与基础用法,涵盖指定URL、参数处理、发起请求及数据持久化存储的完整流程。通过百度翻译POST请求案例演示UA伪装技巧,并结合搜狗首页GET请求案例,讲解如何获取网页源码并保存为本地文件,帮助开发者快速掌握网络爬虫核心技能。
本文介绍使用Python和OpenCV库进行中华人民共和国公民身份证号码提取与识别的实现过程。通过图像预处理、区域分割及模板匹配技术,将提取的身份证号码与标准OCR-B 10 BT字体模板进行相似度比对,最终输出识别结果。
本文以51CTO博客为例,详细介绍如何使用Python进行网页数据爬取。通过安装Python 3.7及requests、bs4模块,结合清华镜像加速下载,编写代码抓取博客标题与阅读量,并将结果保存至本地文本文件,为初学者提供完整的实战案例。
本文详细介绍如何使用Python和pygame库开发经典贪吃蛇游戏,并进一步实现AI自动游玩功能。教程涵盖环境配置、模块安装、普通版代码结构及AI版核心算法逻辑,提供完整可运行代码,适合Python初学者与游戏开发者参考。
本文详解 JavaScript 中快速排序算法的实现。通过选取基准元素并分区,利用递归高效完成数组排序,平均时间复杂度为 O(nlogn),是不稳定排序的典型示例。适合前端开发者学习数据结构与算法。
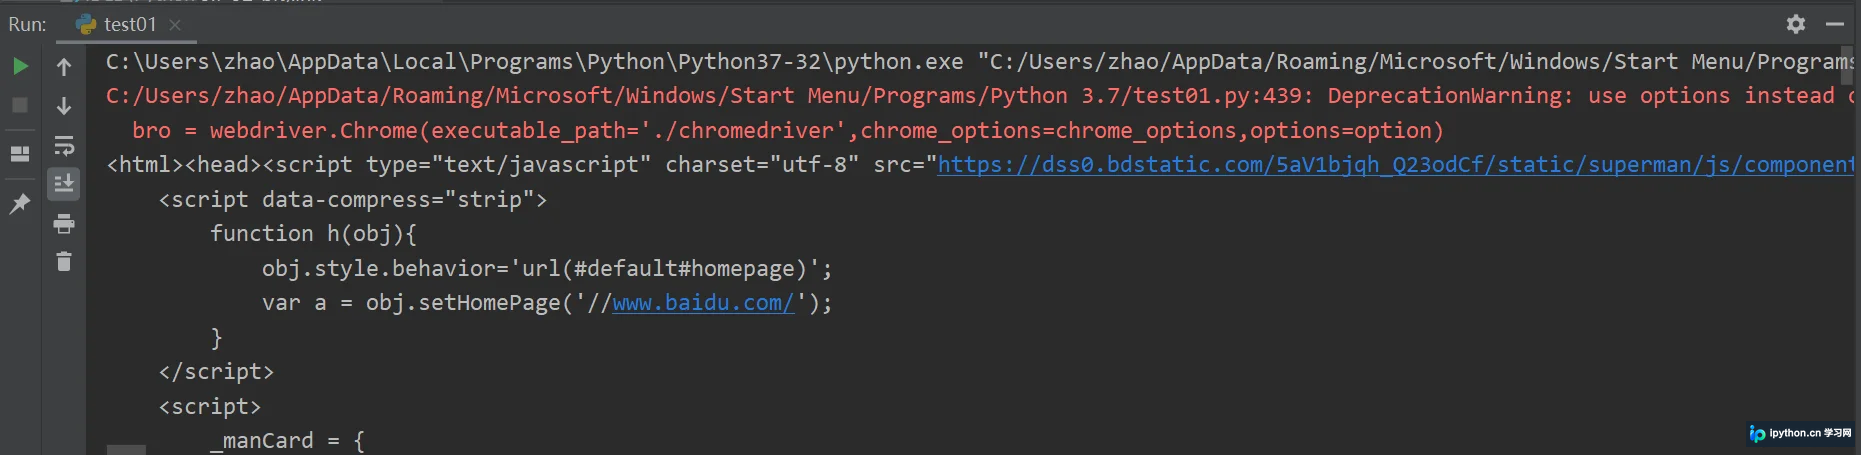
本文详解如何在 Python 中使用 Selenium 配置无头模式(Headless)以隐藏运行过程,并介绍通过 ChromeOptions 添加实验性参数来规避自动化检测的方法。包含完整代码示例及运行效果说明,帮助开发者实现高效且隐蔽的网页数据抓取。
本文介绍如何使用Python自动清理指定文件夹下的重复文件。通过结合[[wp:a0]]、[[wp:a1]]和[[wp:a2]]模块,遍历获取文件路径并两两比较内容。文章详细讲解了利用[[wp:a3]]模块判断文件是否相同的方法,包括[[wp:a4]]与[[wp:a5]]返回值及[[wp:a6]]参数对[[wp:a7]]签名比较的影响。代码实现了路径获取、列表过滤及去重删除逻辑,并处理了文件被提前删除时的[[wp:a21]]存在性检查,确保脚本稳定运行。
本文详细介绍如何利用Python获取百度首页热榜关键词,并通过构造特定URL参数生成对应的搜索链接。同时,文章扩展讲解了使用requests和lxml库抓取百度搜索结果标题、摘要及链接的完整代码实现,涵盖请求头设置、参数解析及数据提取技巧,帮助开发者掌握基础的网络数据采集方法。