pandas实现导出数据的四种方式
本文详细讲解利用pandas库将DataFrame数据导出为CSV、Excel、SQL数据库表及JSON文本文件的四种常用方式。通过具体代码示例,演示了to_csv、to_excel、to_sql及to_json函数的参数配置,包括编码处理、Sheet名指定及数据库连接等关键步骤,帮助开发者快速掌握数据持久化技巧。
2026-10-14
23

本文详细讲解利用pandas库将DataFrame数据导出为CSV、Excel、SQL数据库表及JSON文本文件的四种常用方式。通过具体代码示例,演示了to_csv、to_excel、to_sql及to_json函数的参数配置,包括编码处理、Sheet名指定及数据库连接等关键步骤,帮助开发者快速掌握数据持久化技巧。
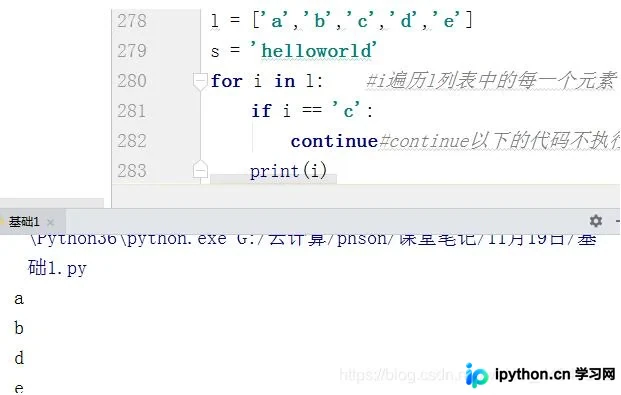
本文探讨在Python的for循环中直接调用pop方法删除元素时,为何会意外跳过某些元素。核心原因在于for循环基于迭代器机制,删除元素后索引偏移导致迭代器指向下一个元素,从而跳过原相邻项。文章提供了使用切片副本nums[:]遍历的解决方案,并简要回顾了continue、break和pass在循环中的基本用法。
本文深入解析Python中对象真假值的判定规则,涵盖空容器、None对象及整数与布尔值的等价关系。通过具体示例说明如何判断数据结构的真假,并解释None作为特殊占位对象的用法,同时探讨True/False与0/1的转换机制,帮助开发者更准确地处理条件判断。
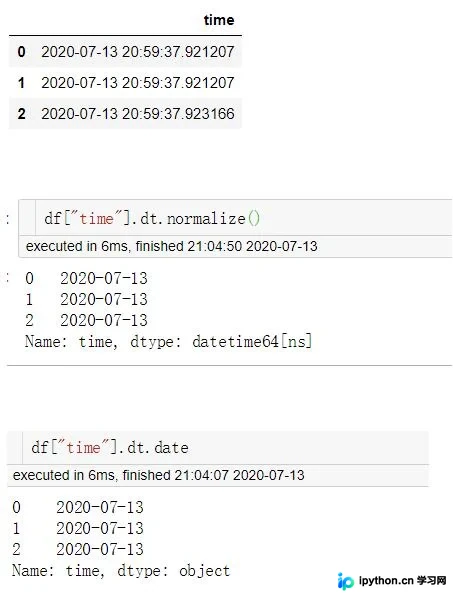
本文详解pandas中dt访问器的核心功能,涵盖日期部分提取、年月日时分秒获取、星期与季度判断、闰年检测及月份名称转换。结合str属性与apply函数,演示如何高效进行时间序列数据的筛选、比较与自定义处理,助力Python数据分析工作流。
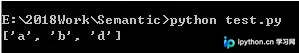
本文深入解析Python中使用remove函数在遍历列表时删除元素的常见陷阱。由于索引前移导致元素被跳过,直接遍历删除往往无法达到预期。文章详细剖析了浅拷贝与深拷贝的区别,并提供了三种有效解决方案:手动构建新列表、使用copy模块的deepcopy方法以及遍历原列表副本,帮助开发者避免此类逻辑错误。
本文详细介绍Python中glob模块的使用方法,涵盖*、?、[]等通配符在文件路径匹配中的应用。通过具体代码示例演示如何查找当前目录及子目录文件,并介绍利用os.makedirs实现递归创建目录的功能,帮助开发者高效处理文件搜索与目录管理任务。
本文介绍如何使用Python实现文件名匹配与文件复制功能。通过遍历源目录获取文件名,利用os.path模块拆分并拼接目标路径,最终使用shutil.copy将匹配的文件复制到指定目录。
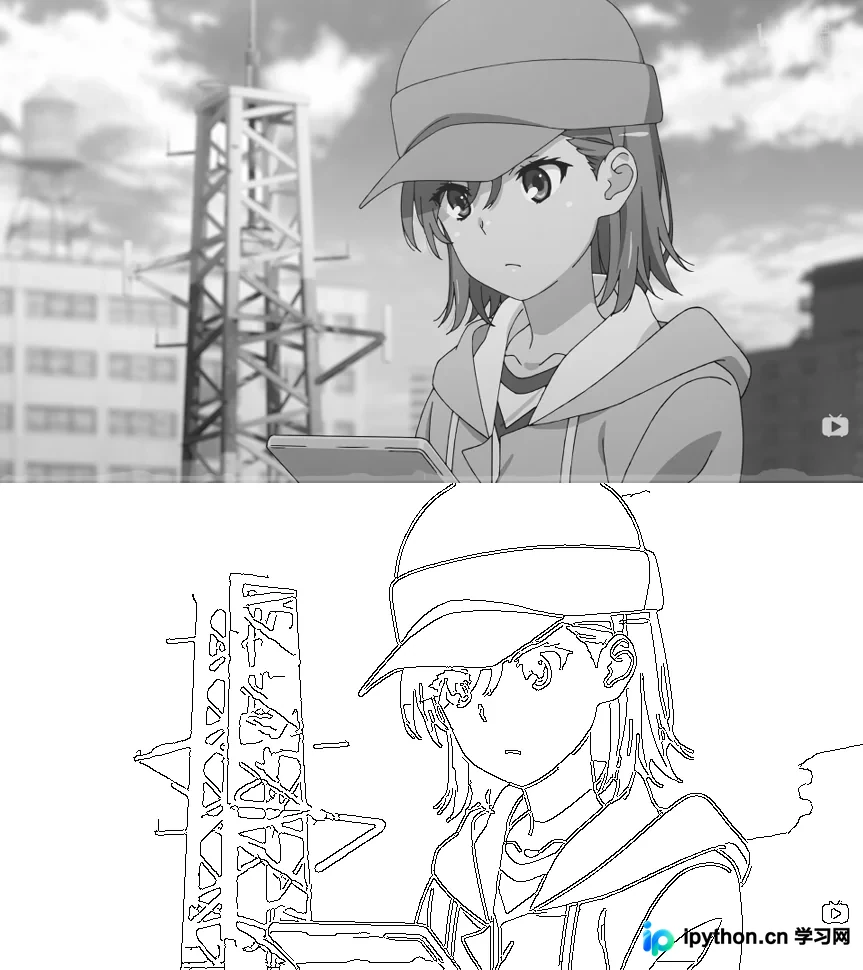
本文详细解析使用Python和OpenCV库实现五种常见图像特效的原理与代码。涵盖素描(灰度、高斯模糊、Canny边缘检测、反二进制阈值化)、怀旧(RGB分量加权混合)、光照(中心点距离计算增强)、流年(B通道开方处理)及基于颜色查找表(LUT)的滤镜转换。提供完整可运行的Python代码示例,帮助开发者快速掌握图像增强与风格化处理技术。
本文详细解析JavaScript中立即执行函数(IIFE)的三种核心写法:括号包裹法、一元运算符法和void关键字法。通过对比代码结构与执行逻辑,帮助开发者掌握创建独立作用域的最佳实践。
本文介绍如何使用Python绘制逻辑斯蒂映射(Logistic Map)的分叉图,展示混沌现象如何从简单的非线性方程中产生。通过Matplotlib和NumPy库,代码遍历不同参数mu下的迭代结果,直观呈现系统收敛值的分布特征,适合对混沌数学和Python可视化感兴趣的读者参考。
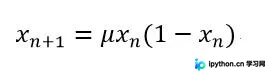
本文详解如何在Python中通过重载 __new__ 方法实现单例模式。首先解析 __new__ 与 __init__ 的执行顺序,指出仅重载 __new__ 会导致 __init__ 多次调用,并提供通过标记位解决该问题的代码示例。随后补充介绍了饿汉式与懒汉式两种经典单例模式的Python实现方式,帮助开发者理解不同场景下的最佳实践。
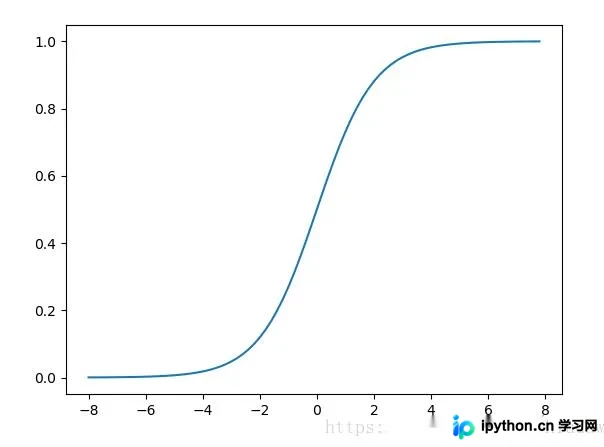
本文介绍如何在Python3中使用matplotlib库绘制Sigmoid函数曲线,并提供包含Tanh、ReLU及PReLU函数的完整可视化代码。通过调整坐标轴样式与范围,清晰展示各激活函数的数学特性,适用于深度学习入门及模型训练中的激活函数对比分析。