

pandas读取txt、csv、excel及pkl文件的方法与部署示例
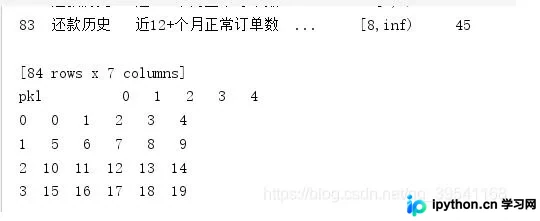
本文详解使用pandas读取txt、csv、excel及pkl文件的具体命令。重点解析read_csv与read_table在处理非标准分隔符txt文件时的差异,通过sep参数解决列解析错误。同时提供线上部署模型时读取excel和pkl文件的完整Python代码示例,涵盖路径适配与测试流程。
2026-10-14
26

本文详解使用pandas读取txt、csv、excel及pkl文件的具体命令。重点解析read_csv与read_table在处理非标准分隔符txt文件时的差异,通过sep参数解决列解析错误。同时提供线上部署模型时读取excel和pkl文件的完整Python代码示例,涵盖路径适配与测试流程。
Windows环境下MySQL启动时若出现max_open_files、max_connections和table_cache不匹配的警告,是因系统自动调整数值导致。通过修改my.ini配置文件,确保max_connections与table_cache满足特定关系式即可消除该提示,优化服务器稳定性。
本文详细介绍 Python Jinja2 模板引擎的核心用法。涵盖控制结构、变量取值与注释语法,解析 for 循环及字典迭代技巧。系统梳理 capitalize、lower 等常用过滤器功能,并深入讲解 PackageLoader 与 FileSystemLoader 两种加载方式及 Environment 类的配置方法,帮助开发者高效实现配置文件动态渲染。
本文介绍使用Python的pandas、xlrd和openpyxl库合并Excel文件中指定Sheet的方法。重点解决合并后出现的列顺序错乱及自动生成Unnamed:0列的问题,通过设置header=None、index_col=0和index=False等参数实现数据正确合并与保存。
本文介绍如何在项目中利用jquery-sortElements插件实现简洁的HTML表格点击排序功能。相比DataTables等大型框架,该插件仅3KB且兼容性良好。文章详细说明了引入jQuery和插件后的具体JS与HTML代码配置,通过点击表头即可实现正序/倒序排列。
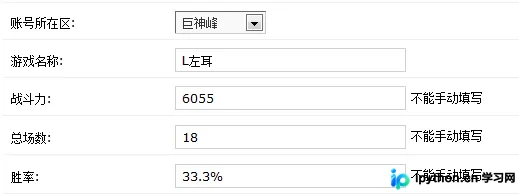
本文介绍如何使用PHP配合Simple_html_dom类库,通过服务器端发起HTTP请求解决JS跨域限制,从而远程抓取多玩游戏盒子中的LOL玩家战斗力、排位场次等数据。文章包含完整的代码示例及DOM解析逻辑说明。
本文整理了MySQL数据库中字符集与排序规则的常用管理命令。涵盖如何通过status、SHOW VARIABLES查看当前字符集设置,创建数据库或表时指定Character Set的方法,以及修改现有库、表或列字符集的具体ALTER语句。内容基于MySQL 5.5+版本测试,帮助开发者解决乱码问题及优化存储配置。
本文介绍了Python中处理字符串时去除空格的五种常用方法。包括使用strip()、lstrip()、rstrip()分别处理首尾及两侧空格,以及利用replace()和join()结合split()实现全量空格清除。通过具体代码示例与输出结果,帮助开发者快速掌握不同场景下的最佳实践。
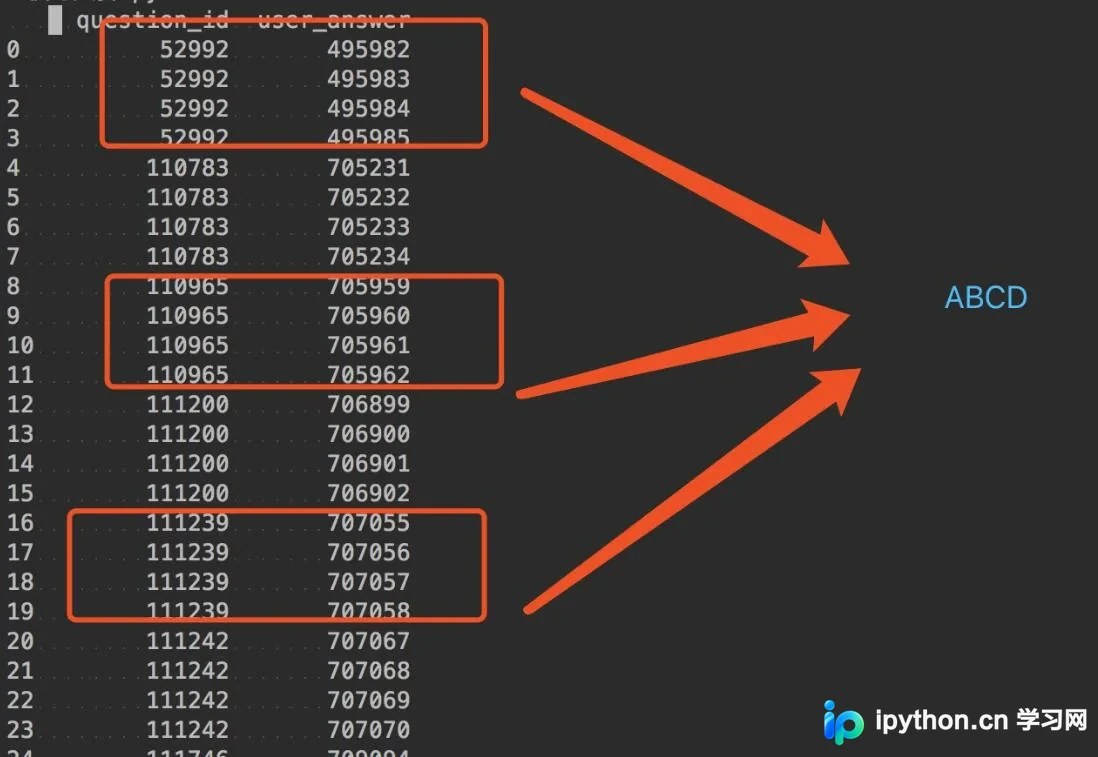
本文介绍如何利用pandas实现分组后提取第N行数据,并通过示例将question_id对应的user_answer转换为ABCD选项。同时详细解析nlargest()函数的用法,包括获取最大前几行、处理重复值及分组求和等场景,帮助读者掌握高效的数据筛选技巧。
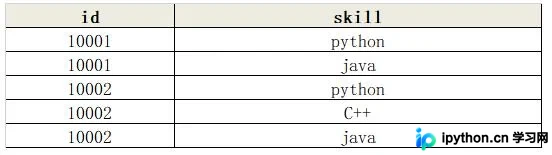
本文介绍在pandas中如何利用groupby对数据进行分组,并将其他列的值合并为列表或字典。通过apply结合list或lambda表达式,可实现单列或多列的聚合处理。同时补充字符串字段的拼接方法及常见字符串处理函数,帮助高效完成数据清洗与转换任务。
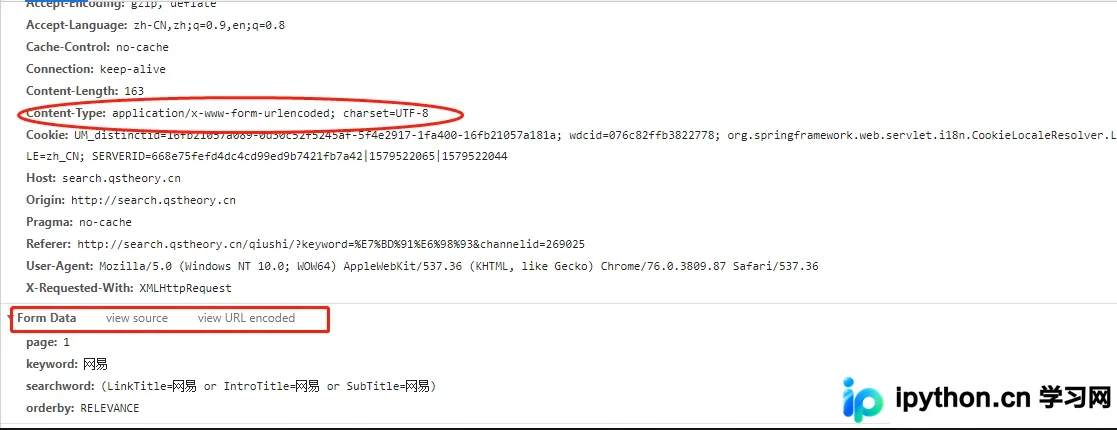
本文深入解析Python requests库中Post请求的两种主要参数形式:Form Data与Request Payload。通过Chrome开发者工具示例,详细对比了application/x-www-form-urlencoded与application/json两种Content-Type下的数据提交方式,并提供了对应的requests.get与requests.post代码实现,帮助开发者解决因参数格式错误导致的数据获取失败问题。
本文介绍如何使用Python pandas库进行分组排序并获取组内第二大或最大的数据。通过groupby结合apply函数,可自定义逻辑提取特定排名数值;对于按列排序后取最大行的需求,可利用sort_values配合groupby的first或head方法实现高效数据筛选。