AI写作检测能准确识别中文吗?多语言支持能力与局限性分析
本文分析了主流AI写作检测工具在中文语境下的表现,指出其准确率普遍低于英文的原因在于训练数据偏差和语言结构差异。文章探讨了技术瓶颈,并提供了提高检测可靠性的实用建议,帮助用户理性看待检测结果。
2026-10-23
18

本文分析了主流AI写作检测工具在中文语境下的表现,指出其准确率普遍低于英文的原因在于训练数据偏差和语言结构差异。文章探讨了技术瓶颈,并提供了提高检测可靠性的实用建议,帮助用户理性看待检测结果。
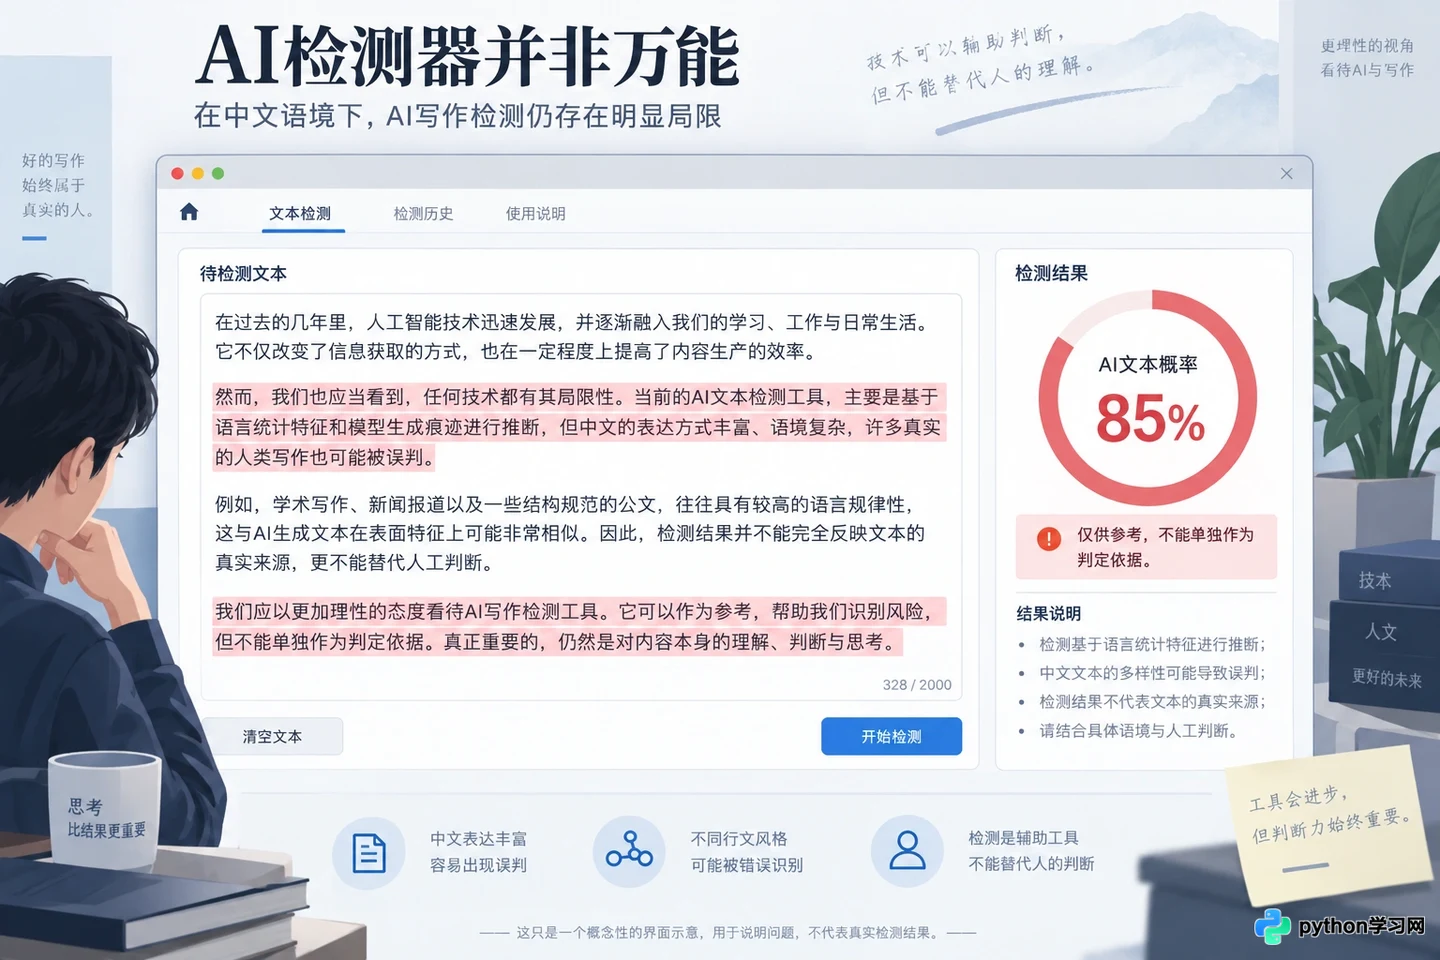
本文提供实用的文本优化策略,通过调整句式节奏、注入个人经验及重构逻辑结构,帮助创作者降低内容被误判为AI生成的概率,提升文本的自然度与可读性。
当AI检测工具将原创内容误判为机器生成时,盲目修改往往适得其反。本文从证据链构建、申诉沟通策略及人工复核要点出发,提供一套理性的应对方案,帮助创作者在算法偏见中维护权益。
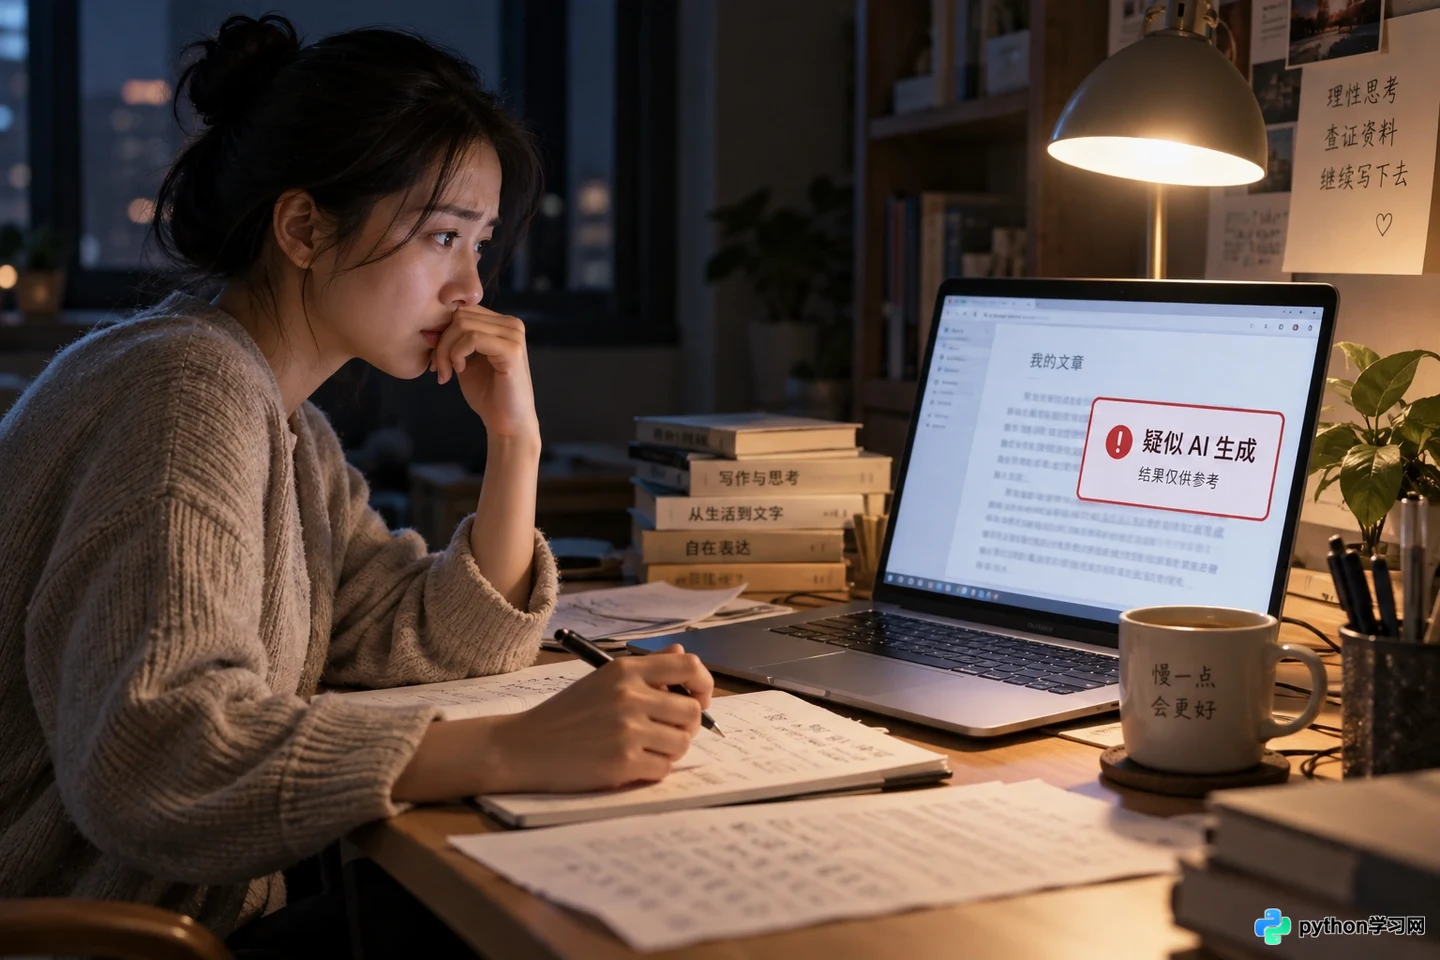
本文分析人工创作内容被AI检测工具误判的常见原因,包括行文过于规整、高频使用连接词、缺乏个性化细节等。通过对比典型误判文本特征,提供具体的自查与修改建议,帮助创作者降低误报风险,保留个人写作风格。
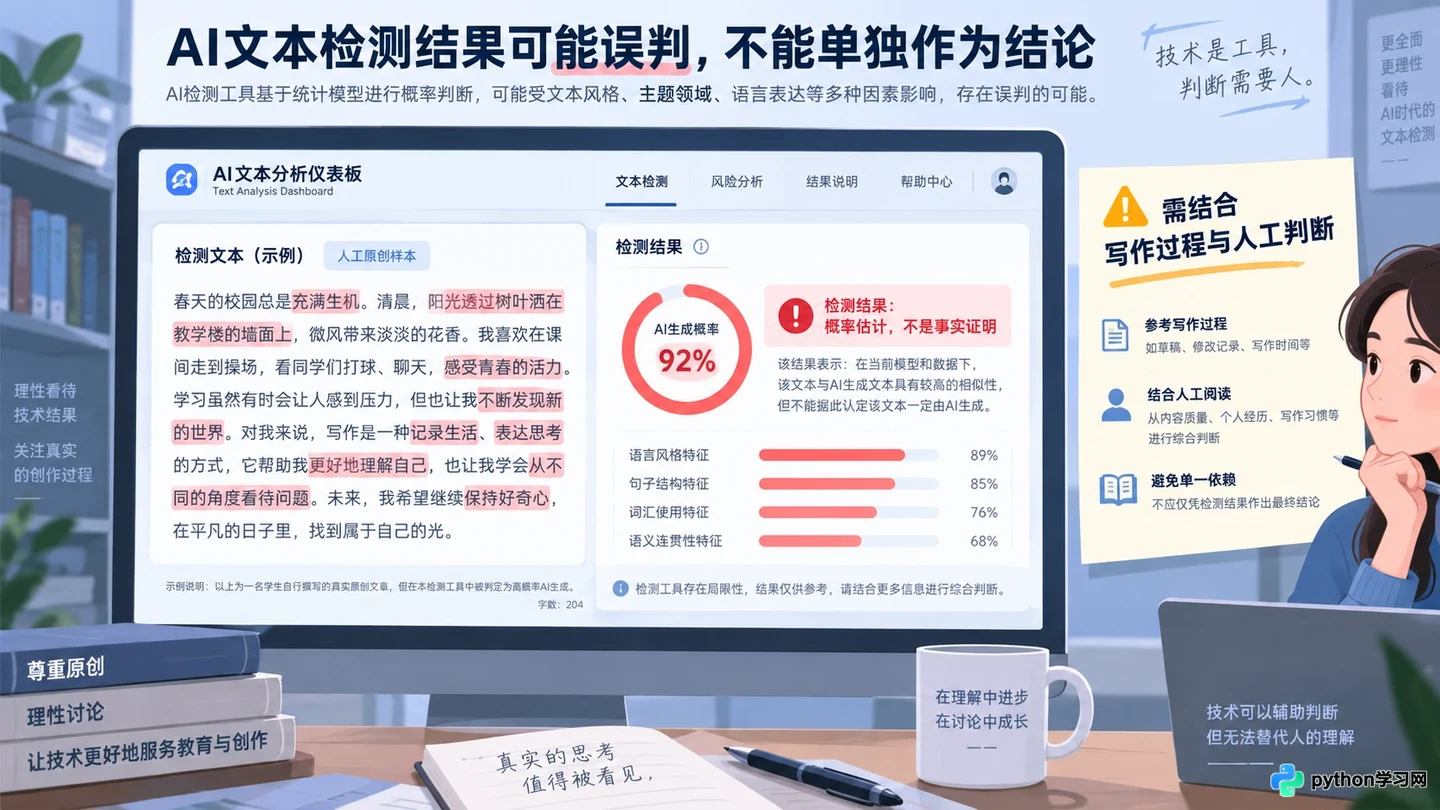
本文深入剖析高校与学术期刊在AIGC内容治理上的实际执行逻辑。从“零容忍”到“透明化披露”,不同机构对AI辅助写作的接受度存在显著差异。文章详细解读了主流检测工具的判定阈值、人工复核的关键维度以及违规后的具体后果,旨在帮助作者厘清合规边界,避免因技术误判或政策盲区导致学术风险。
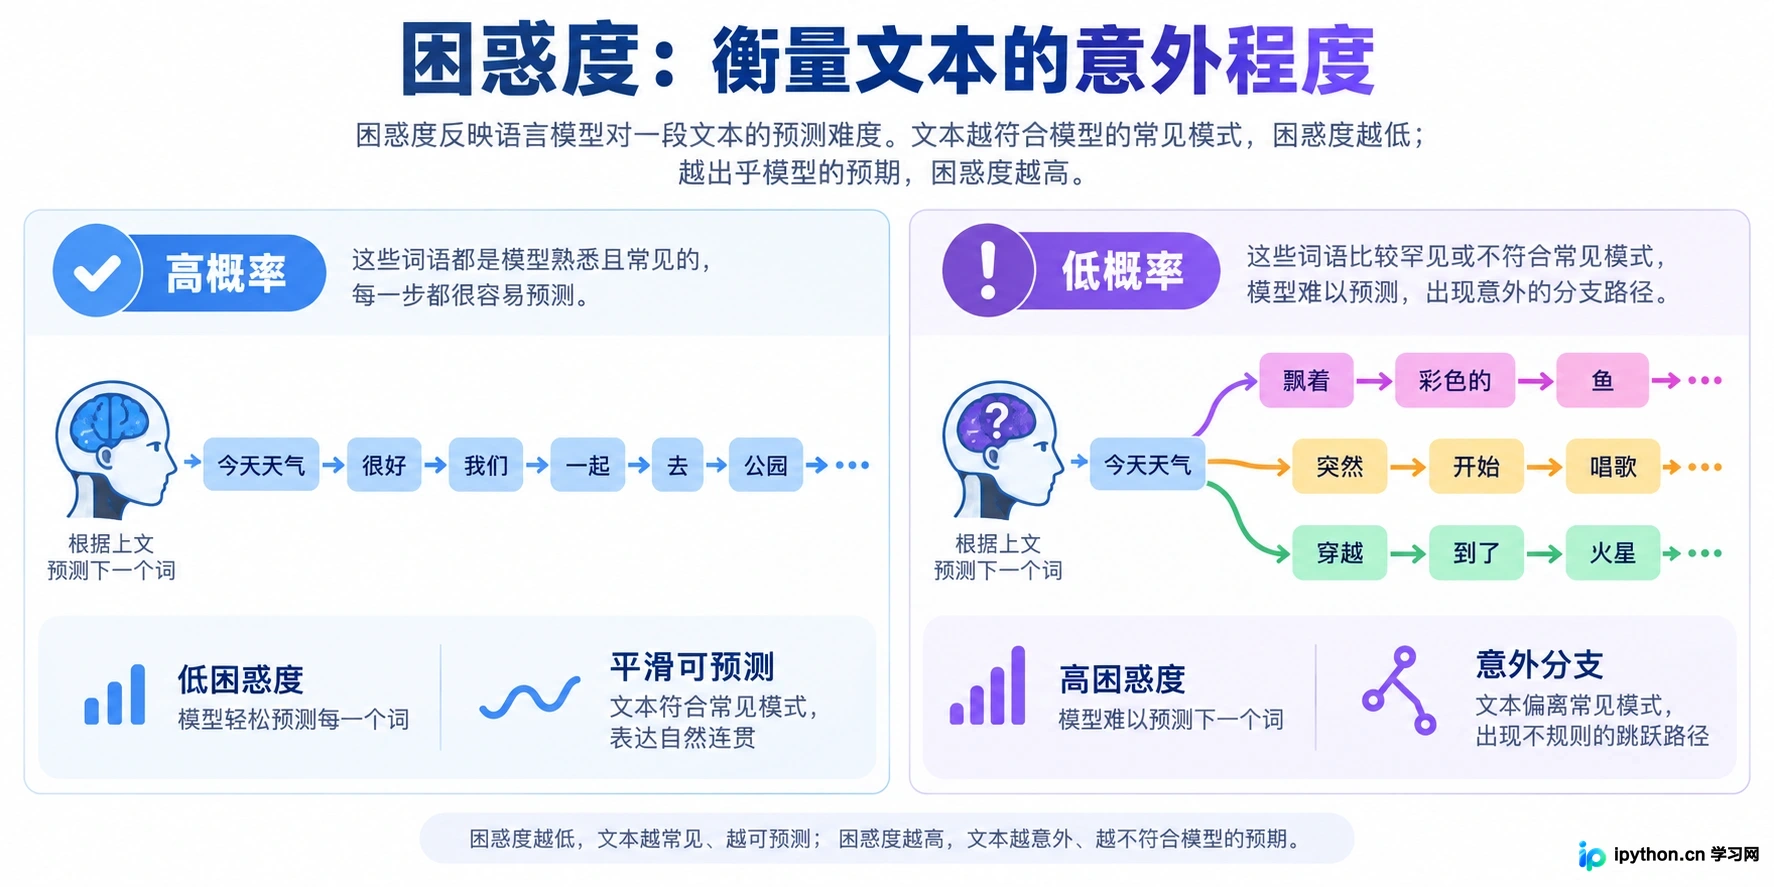
本文深入解析AI写作检测背后的核心逻辑,重点阐述困惑度(Perplexity)与突发性(Burstiness)两大指标如何区分人类与机器文本。通过场景化分析,揭示AI生成内容在概率预测和句式节奏上的特征,帮助用户理解检测工具的原理及其局限性,从而更理性地看待检测结果。
面对AI生成内容的泛滥,学生和独立创作者急需低成本的内容自查方案。本文盘点了几款真正可用的免费在线AI检测工具,分析其检测逻辑、适用场景及局限性,帮助用户在零预算下建立基础的内容合规防线,避免盲目依赖单一结果。