

怎么降低AI写作检测率:人工润色与文本结构优化技巧

刚写完一篇自认为干货满满的文章,随手扔进检测工具,结果红灯亮起:“疑似AI生成概率90%”。这种时刻最让人挫败,明明每个字都是你敲出来的,或者至少是你精心挑选并重组的,为什么机器觉得它冷冰冰?
其实,AI检测器抓的不是“错误”,而是“过于完美”和“缺乏个性”。它们寻找的是高频出现的连接词、均匀分布的句子长度以及缺乏情感波动的陈述语气。要绕过这些算法陷阱,不需要复杂的黑科技,只需要找回写作中那些粗糙但真实的“人味”。
打碎整齐划一的句子节奏
AI生成的文本往往有一种奇怪的韵律感:句子长度差不多,主谓宾结构完整,很少出现倒装或省略。读起来顺畅,但看久了会累,因为大脑预测不到惊喜。
人工润色的第一步,就是故意制造“不协调”。试着把长句拆短,或者把几个短句合并成一个带有插入语的长句。更重要的是,多用口语化的断句。比如,不要写“因此,我们需要考虑到多种因素”,试试“所以,咱们得想想,这里头有哪些坑”。
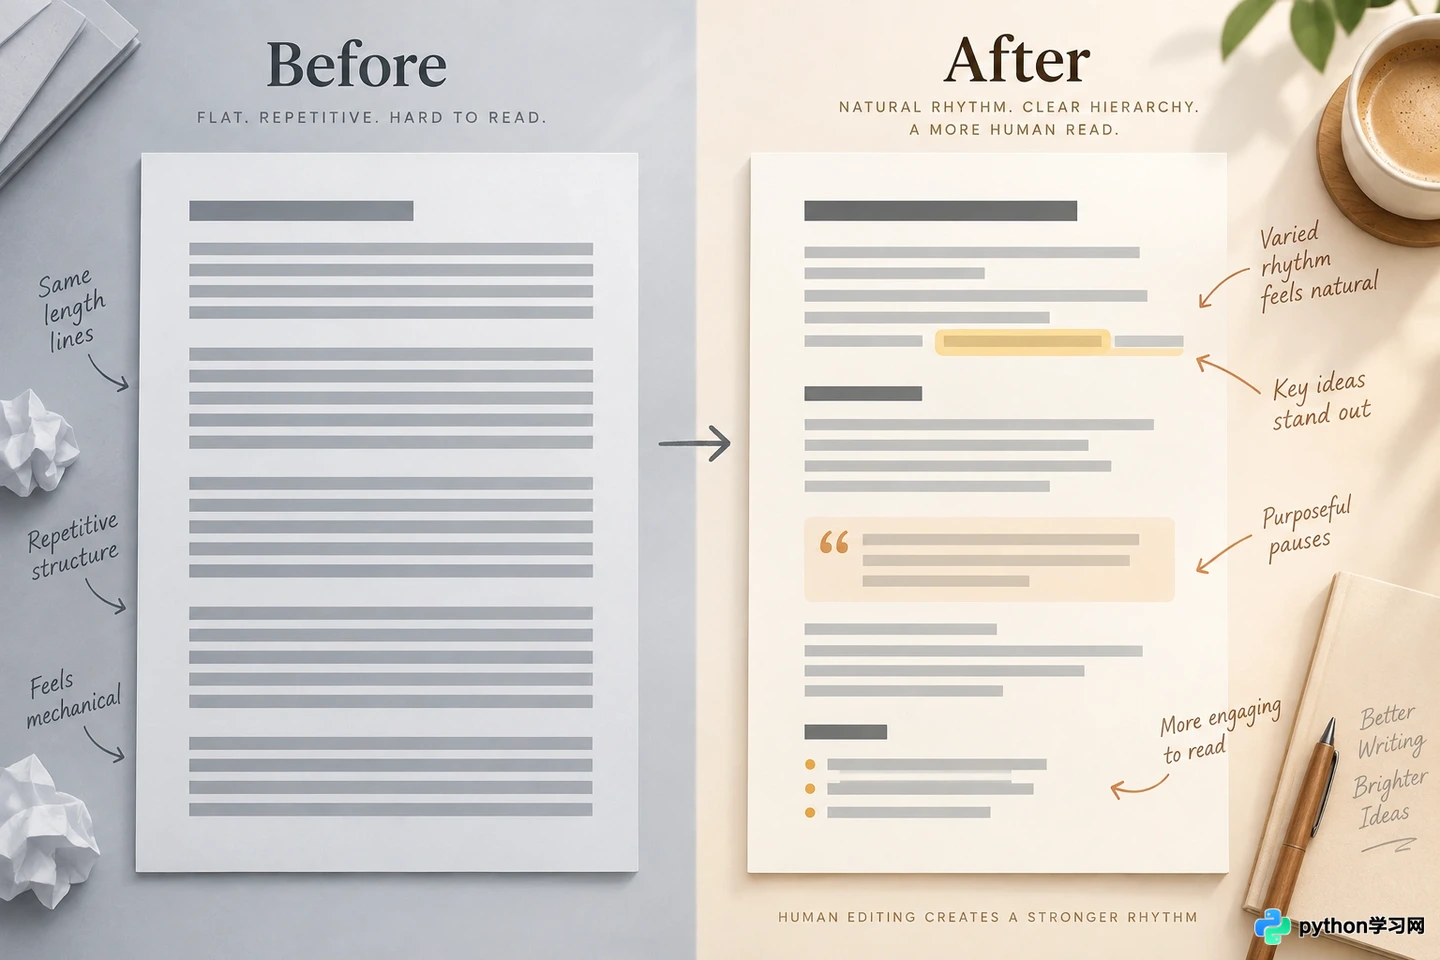
左侧为整齐划一的AI句式,右侧为长短错落的人工润色效果
在修改时,重点关注段落的开头和结尾。AI喜欢用“首先、其次、最后”或“综上所述”来标记结构。人类写作更随意,可能用一个反问句开头,或者用一个具体的场景描写结束。打破这种模板化的起承转合,能显著降低检测评分。
注入无法被预测的个人经验
大语言模型的知识截止于训练数据,它没有身体,没有痛觉,也没有在周五下午等外卖的焦虑。它只能模拟普遍共识,无法提供独特的微观体验。
要在文本中留下“指纹”,最直接的方法是加入第一人称的观察。不是泛泛而谈的“很多人认为”,而是“我上次在项目里遇到这个问题时,第一反应是……”。具体的日期、地点、品牌名,甚至是当时的心理活动,都是AI难以凭空捏造且容易露馅的细节。
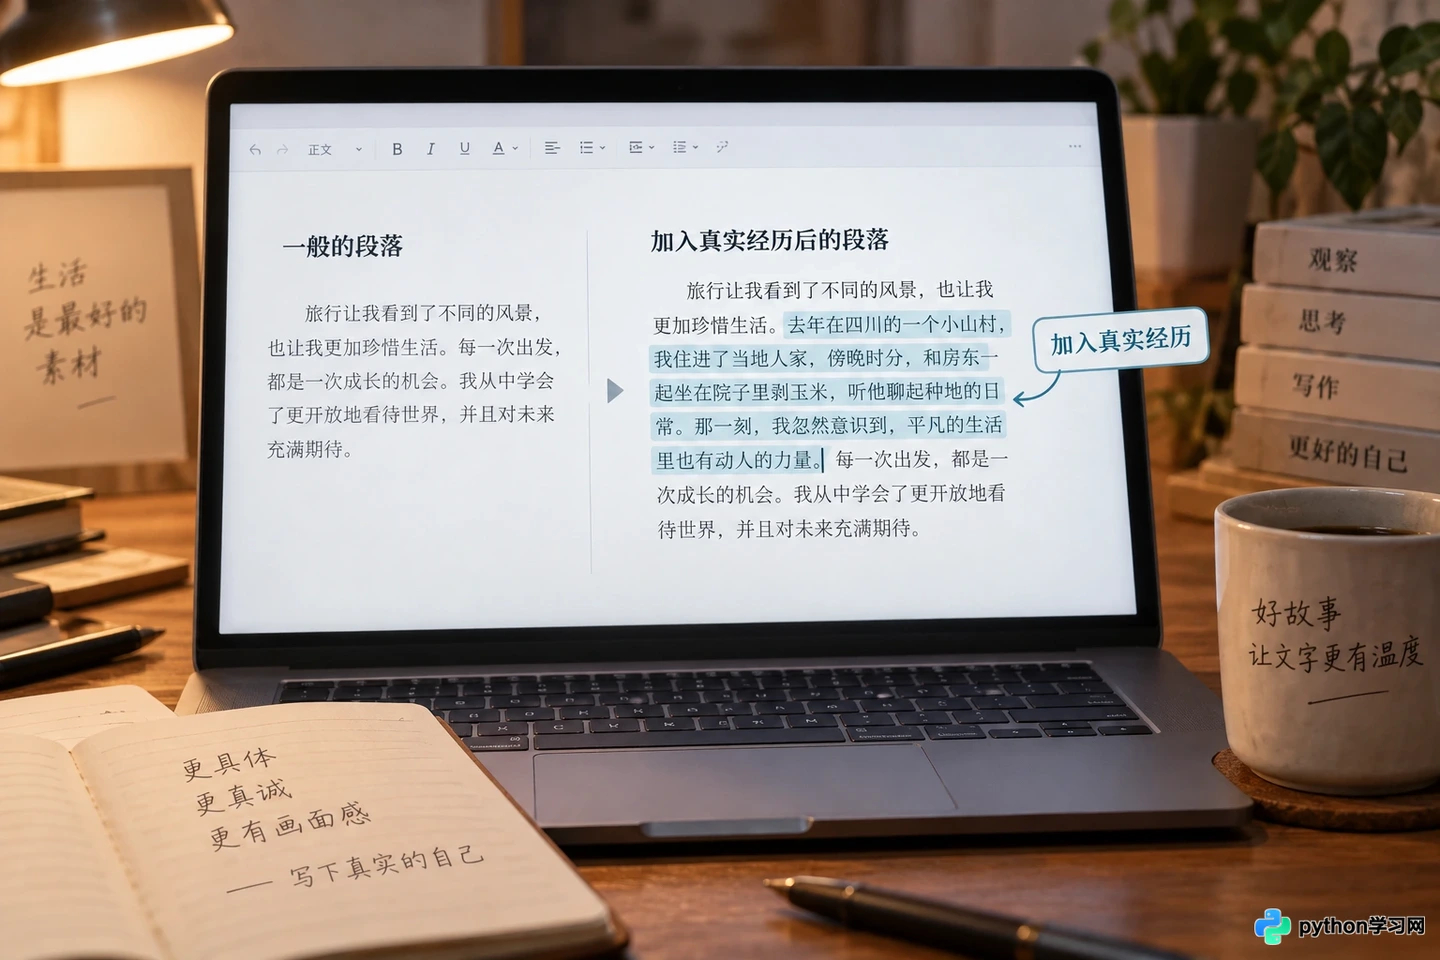
在通用描述中加入具体案例和心理活动
即使是在写客观的技术教程,也可以穿插一些踩坑记录。比如,“官方文档说这一步很简单,但我试了三次才跑通,原因是……”这种带有情绪色彩和具体挫折感的描述,是区分人机写作的关键分水岭。检测算法很难给这种非标准化的叙事打上高分。
重构逻辑而非简单替换同义词
很多人以为降低检测率就是搞“洗稿”,把“高兴”换成“愉悦”,把“快速”换成“迅捷”。这招早就过时了,现在的检测器能识别语义向量,简单的同义替换反而会让语句变得生硬怪异,更容易被标记。
真正的优化在于逻辑重组。AI倾向于线性推导:因为A,所以B,导致C。人类思维则是跳跃的,可能会先说结果C,再回头解释A,中间还插播一个无关的比喻。
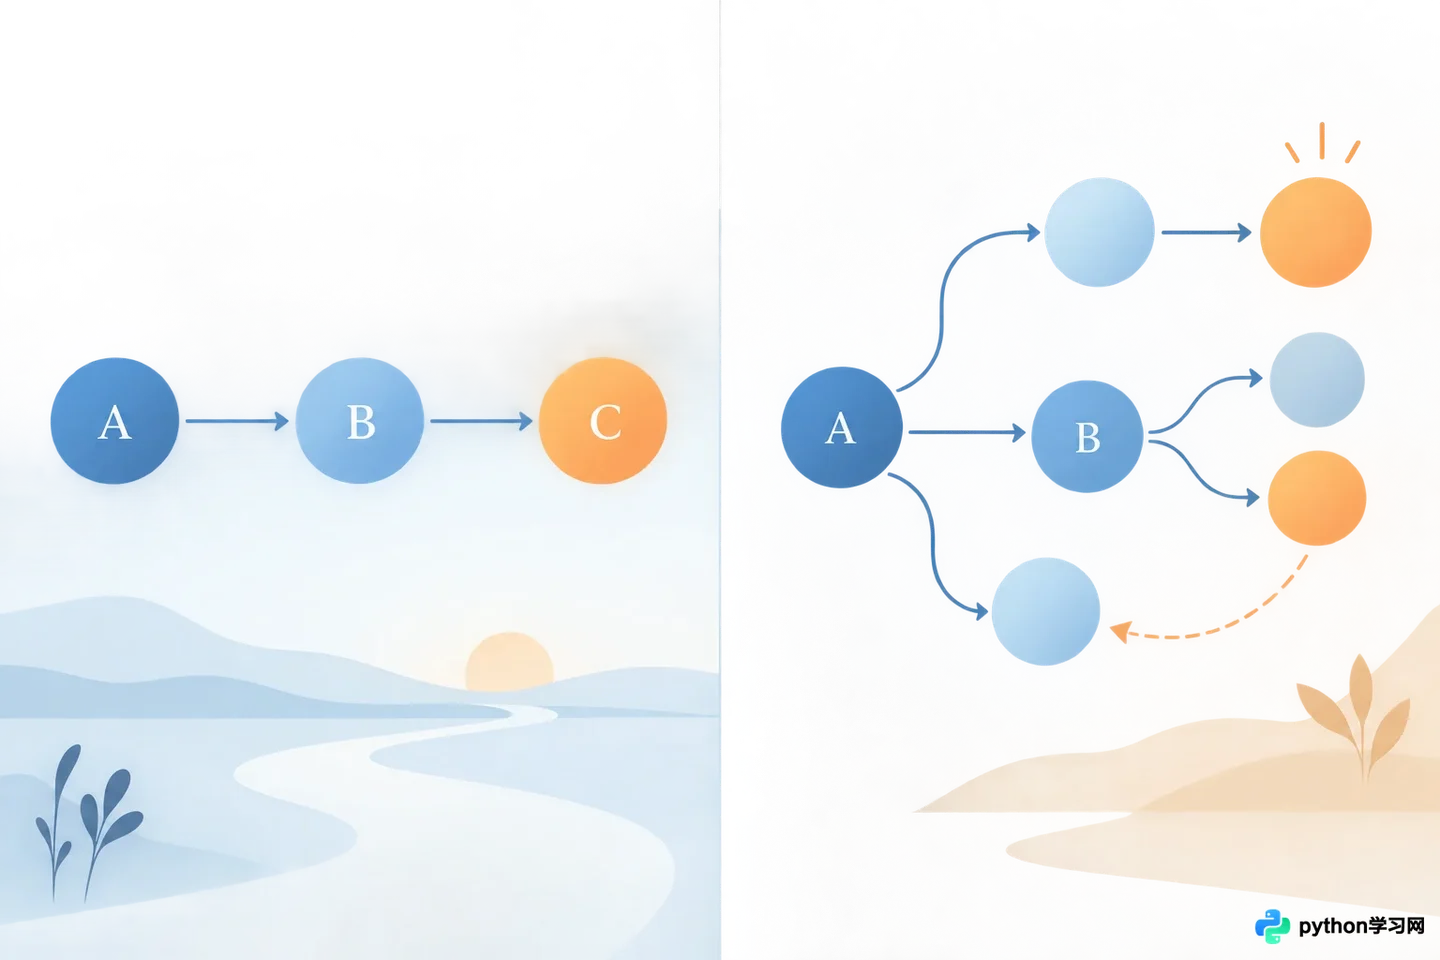
打破线性推导,采用跳跃式逻辑重组内容
尝试打乱原有的段落顺序。如果原文是先定义后举例,你可以先抛出一个反常识的案例,引发读者好奇,然后再引出定义。或者,在两个紧密相关的论点之间,插入一段背景补充或横向对比。这种非线性的信息密度变化,会让文本看起来更像是经过深思熟虑的构思,而非概率预测的产物。
保留适度的模糊与主观判断
AI追求准确和安全,所以它喜欢用“可能”、“通常”、“在某些情况下”这类免责词汇,或者给出绝对正确的废话。人类专家则敢于下判断,甚至敢于表达偏见。
在润色时,删掉那些毫无信息量的铺垫。把“这是一个非常重要的问题”改成“这个问题直接决定了项目的生死”。使用更具象的动词和形容词,少用抽象名词。同时,不要害怕表达不确定性,比如“我个人推测”、“目前看来”,这种带有主观局限性的表述,反而增加了真实感。
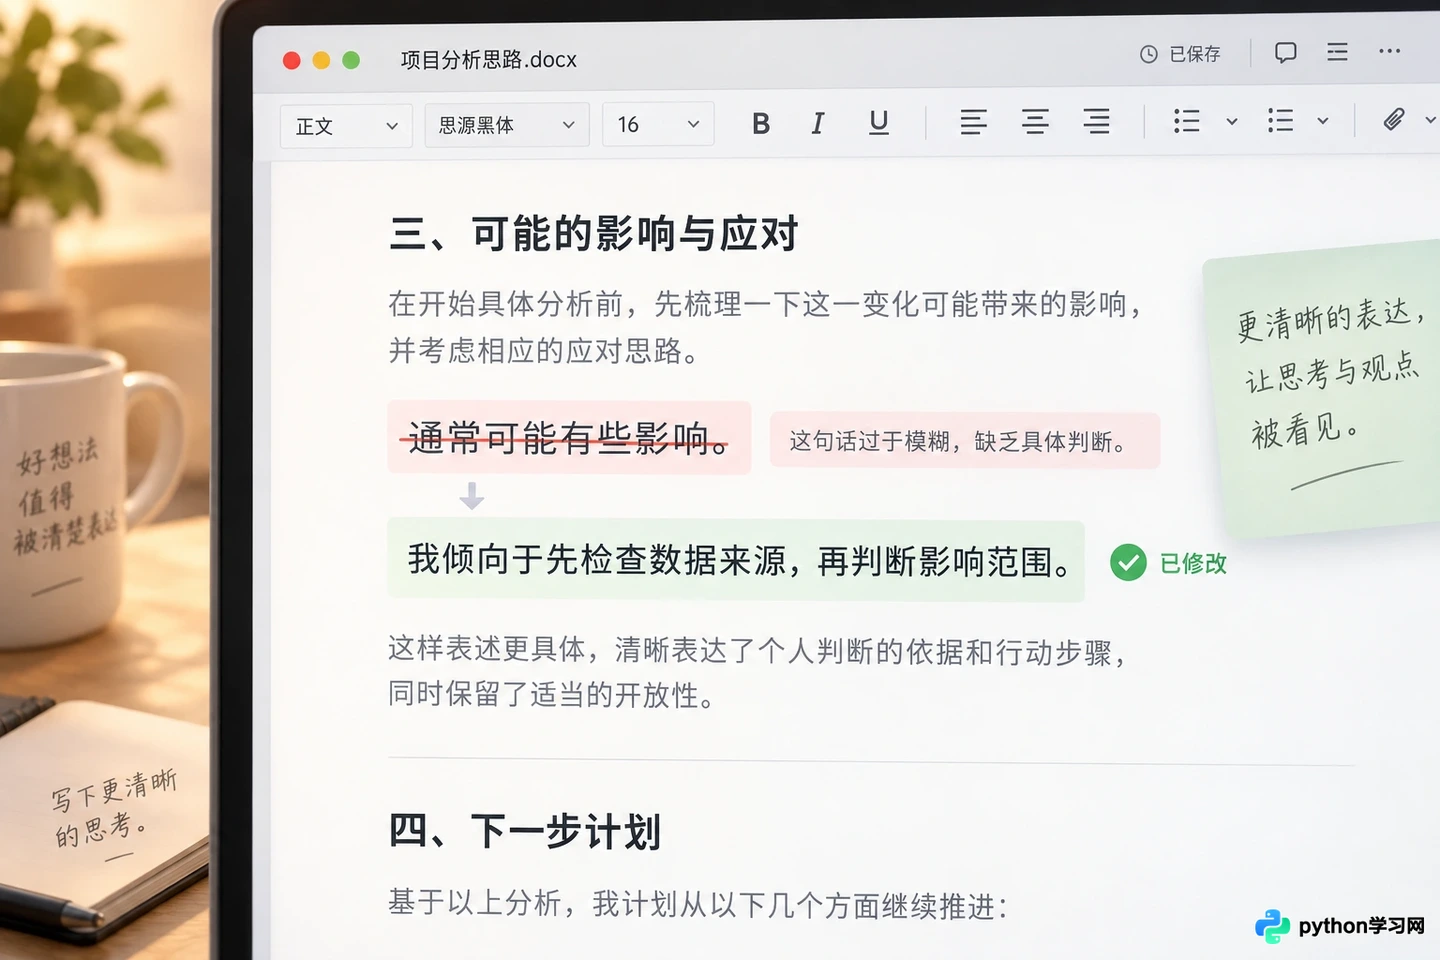
将模棱两可的表述改为具有主观判断力的观点
最后,记得大声朗读你的文章。如果哪里读起来拗口,或者让你觉得“这话不像我会说的”,那就改掉它。AI检测的本质是图灵测试的变体,只要你的文字能让另一个真人读得下去、听得进去,大概率也能骗过那些基于统计规律的算法。毕竟,写作的初衷是与人交流,而不是与机器博弈。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









