

Java基于Socket实现HTTP多次请求复用连接

了解HTTP/1.1长连接的原理后,本文将深入底层,探讨如何在Java中利用原生Socket建立连接,并手动拼接HTTP协议头部,实现“一次握手,多次请求”的高效通信模式。
核心逻辑:从TCP到HTTP
在传统的HTTP/1.0时代,每次请求都需要经历创建TCP连接、传输数据、断开连接的完整过程,这种短连接方式资源消耗大且效率低下。到了HTTP/1.1标准,引入了Connection: keep-alive机制,允许客户端在完成一个请求后保持连接不立即关闭,从而复用同一个TCP连接发送后续请求。
理论基础与层级关系
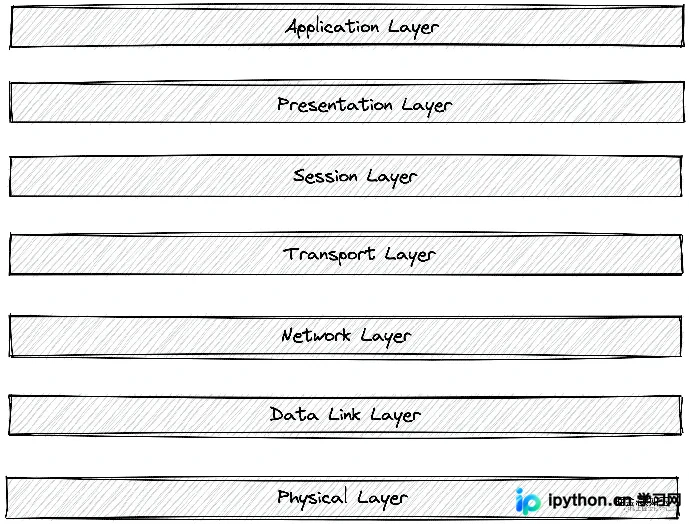
理解长连接的前提是厘清OSI七层模型或五层模型中的层级关系:
- 传输层:负责端到端的连接,如TCP协议通过“三次握手”建立稳定连接,这是所有应用层长连接的基础。
- 应用层:定义数据的格式和语义。是否支持长连接完全取决于应用层协议如何处理这条已建立的TCP通道。
如果应用层规定每发一条指令就断开TCP(如早期HTTP),则是短连接;如果服务器处理完响应后仍保持TCP链路等待下一条指令(如MySQL协议或开启Keep-Alive的HTTP),则是长连接。简而言之,HTTP的长连接本质是在同一个TCP Socket之上,按照HTTP报文规范反复进行读写操作。
现实条件:客户端与服务端的支持
要实现连接复用,必须是双向奔赴:浏览器或客户端必须发出keep-alive指令,而服务器(如OSS、Nginx)也必须配置为接受并保持该连接。若其中一方强制断开,复用即失效。
原始HTTP获取资源的局限
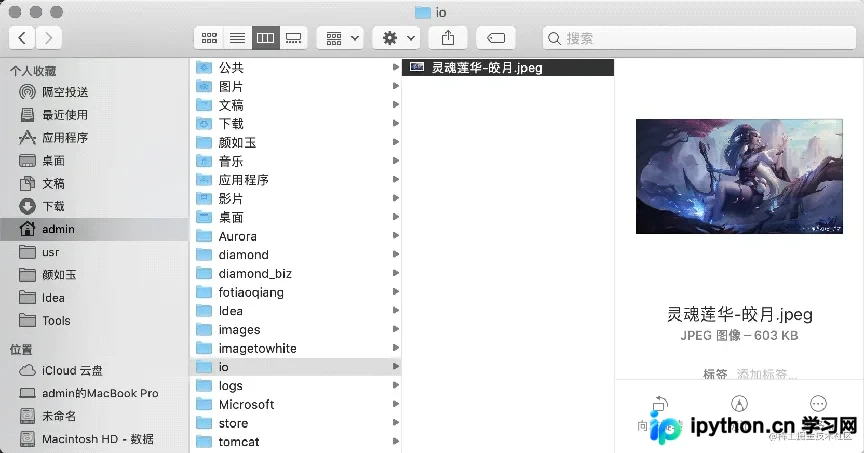
在Java中,通常使用java.net.URL类快速获取网络资源,其底层代码结构相对简洁:
@Slf4j
public class SinaPicDownload {
    static final String HTTP_URL = "https://wx3.sinaimg.cn/mw2000/006jQ3i8ly1h5k50zujydj35k0334kjo.jpg";
    static final String LOCAL = "/Users/admin/io/灵魂莲华-皎月.jpeg";

    public static void main(String[] args) {
        try (
            InputStream in = new URL(HTTP_URL).openStream();
            FileOutputStream out = new FileOutputStream(LOCAL)
        ) {
            byte[] buffer = new byte[1024 << 2];
            int read;
            while ((read = in.read(buffer)) > -1) {
                out.write(buffer, 0, read);
            }
            out.flush();
        } catch (Throwable e) {
            log.error("获取HTTP资源失败:", e);
        }
    }
}虽然利用try-with-resources语法糖可以极快地写出下载功能,但这种方式每次调用都会隐式地创建新的连接并在结束后关闭。对于需要频繁轮询或下载大量小文件的场景,这会导致巨大的性能开销。
掌握“语言”:Transfer-Encoding
既然要复用底层Socket,就必须自己构建符合HTTP/1.1规范的请求报文。这就好比两个人通话,除了线路连通(TCP建立),还得用同一种语言说出具体的业务诉求(HTTP报文)。
HTTP报文的核心在于请求行和请求头的格式编码(Encoding),它规定了双方如何解析数据。我们可以将这一过程拆解为:方法 + URL + 版本号 作为起始,随后紧跟各个键值对形式的Header,最后以空行结尾。
以下是标准的HTTP请求报文结构示意:
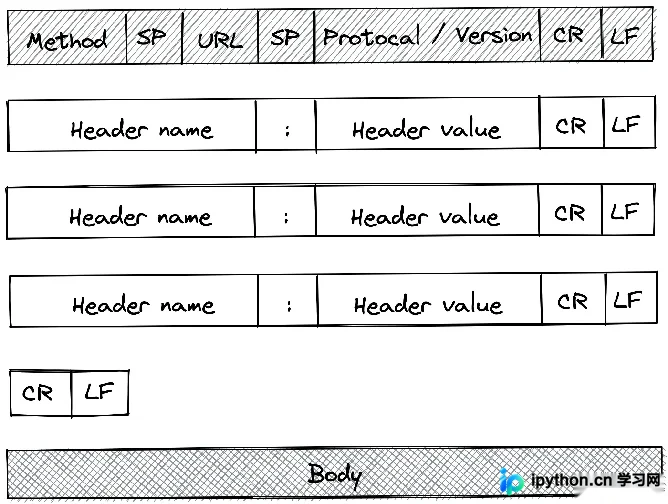
当我们要下载上述图片时,实际上发送给服务器的指令是这样的:
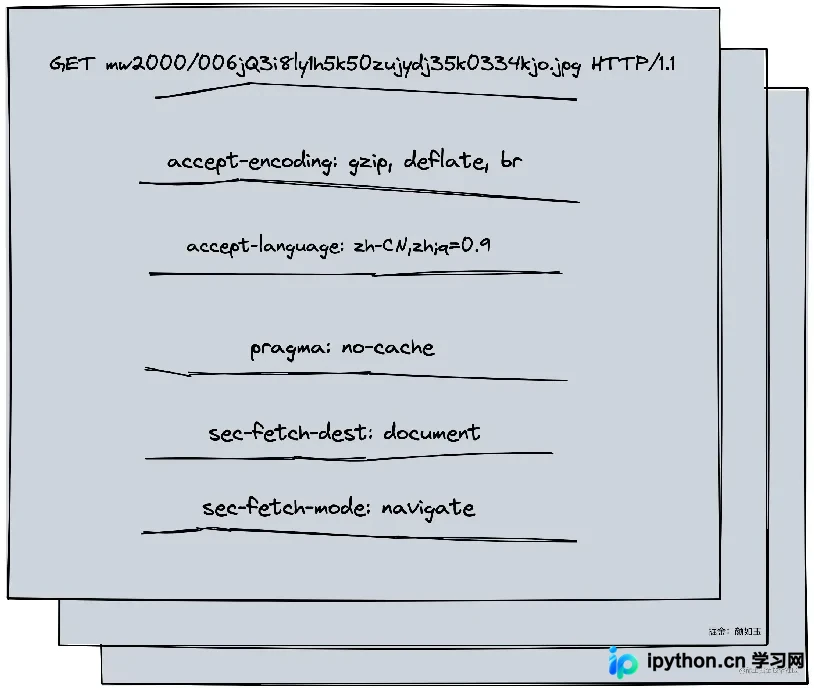
- 真实的Request Line与图示一致。
- Header部分非常复杂,图中仅为简化展示。
- GET请求无Body,故省略实体内容部分。
实战:Java底层构建与多请求复用
下面将通过原生Socket编程,演示如何在一个TCP连接内连续完成四次不同的HTTP请求。
第1步:初始化常量与资源列表
定义目标主机、端口及待访问的路径数组。注意这里使用了纯文本路径,旨在直观展示多次复用的过程。
@Slf4j
public class ReusableHttp {
    /* OSS服务域名 */
    static final String HOST = "****.oss-cn-zhangjiakou.aliyuncs.com";
    static final int PORT = 80;
    /* 待获取的资源路径 */
    static final String[] URLS = new String[]{
        "/context/reusable/gtyj.text",
        "/context/reusable/tlyxqch.text",
        "/context/reusable/yj.text",
        "/context/reusable/ls.text"
    };
    /* CR = '\r'; LF = '\n' */
    static final byte[] CRLF = new byte[]{Chars.CR, Chars.LF};
    static final String LOCAL_PATH = "/Users/admin/io/";
}
第2步:建立长连接与流对象
创建一个Socket对象连接到指定Host和Port,并获取输入输出流。这里的try-with-resources仅用于确保Socket在最终退出时被正确关闭,而在循环内部我们会重复使用该流。
public static void main(String[] args) {
    try {
        // 建立一次TCP连接
        try (Socket socket = new Socket(HOST, PORT);
             OutputStream out = socket.getOutputStream();
             InputStream in = socket.getInputStream()) {
            reusable(out, in); // 复用此连接进行多次通信
        }
    } catch (IOException e) {
        log.error("请求出现异常", e);
    }
}
第3步:规范写入Request Line与Header
为了复用连接,我们需要严格按照HTTP/1.1规则拼装字符串。特别注意每一行末尾都必须包含回车换行符(CRLF),且所有Header完毕后必须以双重CRLF结束。
/**
 * 格式化写出Request Line
 * 格式: Method SP Request-URI SP HTTP-Version CRLF
 */
static void writeRequestLine(OutputStream out, String url) throws IOException {
    out.write(("GET " + url + " HTTP/1.1").getBytes());
    out.write(CRLF);
}

/**
 * 格式化写出Request Header
 * 每个Header字段名后跟冒号和空格,以CRLF结尾
 */
static void writeHeaderLine(OutputStream out) throws IOException {
    out.write("Accept: text/html,application/xhtml+xml,application/xml;q=0.9...".getBytes());
    out.write(CRLF);
    out.write("Accept-Encoding: gzip, deflate".getBytes());
    out.write(CRLF);
    out.write("Accept-Language: zh-CN,zh;q=0.9".getBytes());
    out.write(CRLF);
    // 关键:显式声明保持连接,告知服务端不要主动断开
    out.write("Connection: keep-alive".getBytes());
    out.write(CRLF);
    // Host是HTTP/1.1必须的Header
    out.write("Host: kuaimai-sheji.oss-cn-zhangjiakou.aliyuncs.com".getBytes());
    out.write(CRLF);
    // 空一行,代表Header结束
    out.write(CRLF);
}
第4步:循环发送与接收
在主逻辑中,我们遍历URL数组。每次循环重新组装请求行(因为路径不同),然后直接复用已经写好的Header模板。关键在于:请求之间不进行Socket的断开与重连,而是直接发送下一个Request Line。
/**
 * 核心复用逻辑:在一个循环内通过同一Socket发送多个请求
 */
static void reusable(OutputStream out, InputStream in) throws IOException {
    for (int i = 0, s = URLS.length; i < s; i++) {
        // 1. 构建针对当前特定URL的请求线
        writeRequestLine(out, URLS[i]);
        // 2. 补充公共Header
        writeHeaderLine(out);
        // 3. 发送数据至网络缓冲
        out.flush();

        // 4. 接收服务端返回的数据
        // 注意:实际生产中应解析状态码和内容长度(CLR),此处做简化处理
        byte[] bytes = new byte[512];
        // 阻塞读取,直到收到数据
        in.read(bytes);

        // 5. 保存结果
        String file = LOCAL_PATH + i + ".text";
        try (FileOutputStream fo = new FileOutputStream(file)) {
            fo.write(bytes);
            fo.flush();
        } catch (Throwable e) {
            log.error("文件写入出现异常", e);
        }
        // 循环继续,此时out/in依然是同一个Socket流
    }
}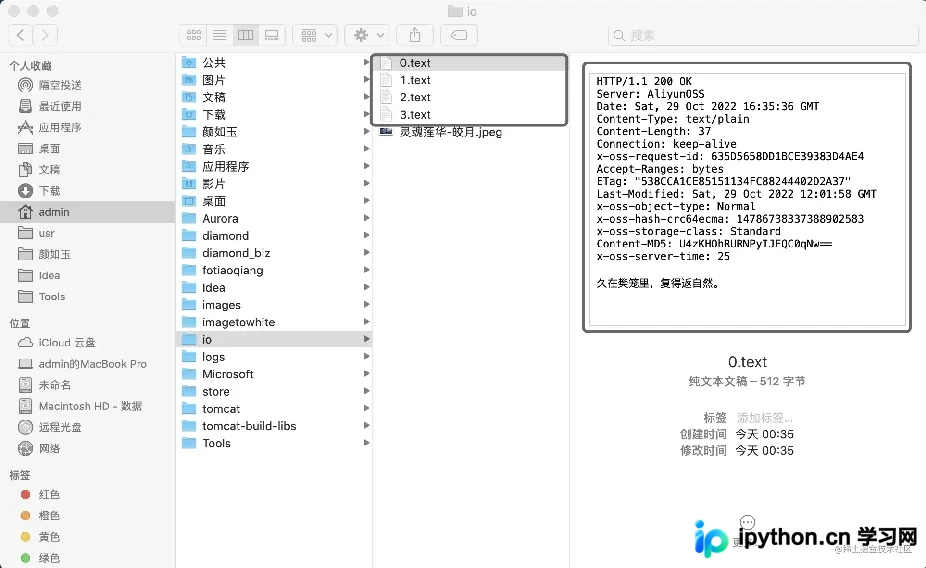
通过上述逻辑,程序成功在同一TCP连接上发起了四次独立的HTTP GET请求。这便是HTTP长连接复用的最底层实现形式,理解了这一过程,就能更好地把握连接池、负载均衡以及现代高性能框架的运作原理。
以上就是Java基于Socket实现HTTP多次请求复用连接的详细内容,更多关于Java Http多请求复用的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









