

Python数据分析中常用的数据聚合与分组操作技巧
深入解析Python数据分析中常用的数据聚合与分组操作技巧,涵盖groupby核心机制、命名聚合、transform组内广播、agg与apply辨析及性能优化实践。
假设你正在处理一份包含数十万行交易记录的电商数据表,字段包括订单日期、销售大区、商品品类、订单金额以及客户评分。业务方通常不会关注某一行孤立的流水,而是迫切需要回答一系列汇总层面的问题:各个大区每月的总销售额是多少?哪个品类的客单价最高?高价值客户在各自所属组内的消费占比如何?
在 Python 数据分析体系(以 Pandas 为核心)中,解决这类问题的核心技术就是数据分组(Grouping)与数据聚合(Aggregation)。本文将系统梳理日常工作中最实用的分组聚合操作、语法演进技巧与性能陷阱,帮助你写出结构简洁、运行高效的数据处理代码。
一、核心范式:理解“拆分 - 应用 - 合并”机制
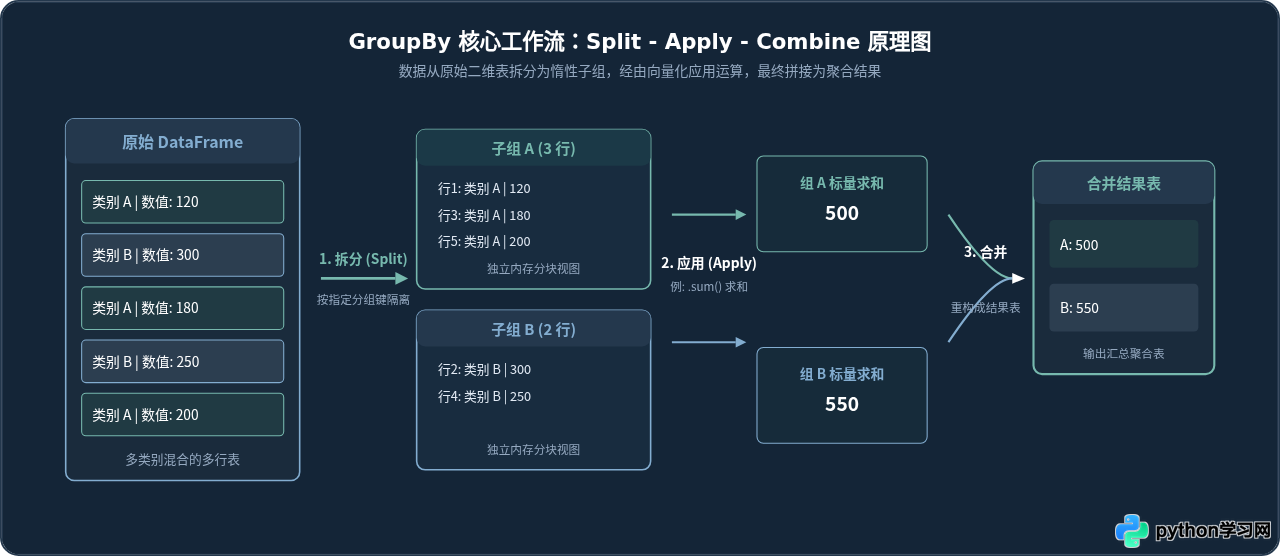
Pandas 中的分组聚合操作建立在经典的 Split-Apply-Combine(拆分 - 应用 - 合并) 哲学之上。许多初学者直接调用 df.groupby(),却容易混淆其阶段产物与执行过程:
- 拆分(Split):根据一个或多个键(列名、Series 或函数),将原始 DataFrame 划分为若干个互不重叠的数据子集。这一步并不立即在内存中复制全部数据,而是生成一个惰性求值的
DataFrameGroupBy对象。 - 应用(Apply):对拆分出的每一个子组独立施加计算逻辑。这一步可以是计算标量汇总值的聚合操作(如求和、求平均),也可以是保持维度不变的组内转换,或者是自定义过滤。
- 合并(Combine):将所有子组的计算结果按照原始分组键有序拼装成一个新的单结构对象(通常是拥有新行索引或规整列名的 DataFrame)。
二、基础操作:单列聚合与多键分组
最简单的分组操作是指定单个字段并统计数值列。例如按销售区域统计销售总额:
import pandas as pd

# 示例数据构造
df = pd.DataFrame({
    'region': ['华东', '华北', '华东', '华南', '华北', '华东'],
    'category': ['数码', '家电', '家电', '数码', '数码', '食品'],
    'sales': [4500, 3200, 2100, 5800, 1900, 600],
    'quantity': [3, 2, 1, 4, 2, 5]
})

# 单列单聚合统计
region_sales = df.groupby('region')['sales'].sum()
print(region_sales)在实际业务中,我们通常需要按照多层级维度进行交叉切分,例如“各大区下不同品类”的销售额表现。此时只需在 groupby 中传入列表即可:
# 多键分组并聚合
multi_group = df.groupby(['region', 'category'])['sales'].sum()
print(multi_group)as_index=False 的妙用默认情况下,Pandas 会将分组列转变为返回结果的行索引(Index 或 MultiIndex)。在后续数据加工中,通常还需要执行
.reset_index() 将其还原为普通列。如果直接在分组时声明 df.groupby(['region', 'category'], as_index=False)['sales'].sum(),则直接产出规整的二维 DataFrame,代码更加简洁。
三、现代实践:命名聚合(Named Aggregation)的优势
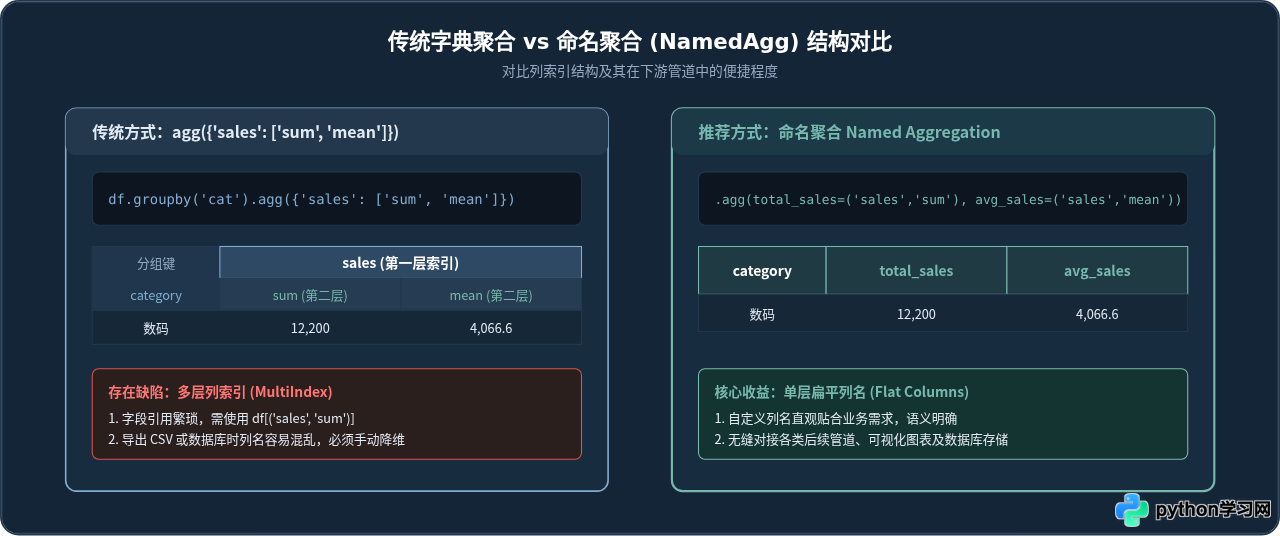
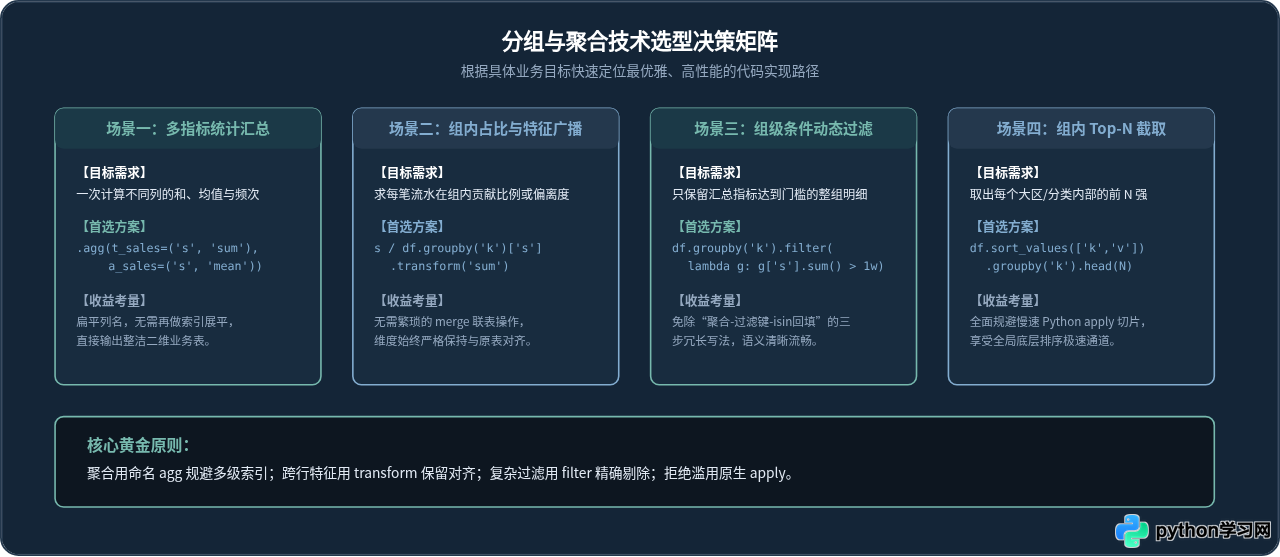
当需要同时对多个列计算不同统计量(例如同时计算销售额总和、销售额均值以及订单总数)时,传统的 agg() 常传入字典形式:
# 传统字典聚合方式
old_agg = df.groupby('category').agg({
    'sales': ['sum', 'mean'],
    'quantity': 'count'
})这种写法会产生令人头疼的双层复合列名(MultiIndex columns),如 ('sales', 'sum') 和 ('sales', 'mean')。后续在绘图、导出或查询时往往需要额外编写列表推导式来拼接或平铺列名。
从 Pandas 0.25 开始官方引入了命名聚合(Named Aggregation)语法。它允许用户在 agg() 中直接以关键字参数的形式定义结果列名与统计逻辑:
# 推荐:现代命名聚合写法
clean_agg = df.groupby('category', as_index=False).agg(
    total_sales=('sales', 'sum'),
    avg_sales=('sales', 'mean'),
    order_count=('quantity', 'count')
)
print(clean_agg)
通过使用 pd.NamedAgg(column='列名', aggfunc='函数名') 或直接传递元组 (列名, 函数名),不仅列名一目了然,而且生成的表结构天然扁平,完全免除了列索引重排的麻烦。
四、维度保持技巧:巧用 transform 进行组内广播
许多刚接触数据分析的开发者存在一个思维惯性:认为 groupby 最终产出的行数必然等于分组的类别总数。但在很多特征工程和业务场景中,我们需要的是保留原始数据的所有行,并将分组汇总结果广播(Broadcast)回对应的每一行。
典型场景包括:
- 计算每笔订单占该品类总销售额的百分比贡献。
- 计算每条记录相对于其所属大区均值的偏差(去均值中心化)。
- 用组内均值或中位数填补缺失值。
如果使用聚合再手动 merge 回原表,不仅代码冗长而且性能低下。此时 transform() 是最优雅的解决方案:
# 1. 组内求和并广播回原始行数
df['category_total'] = df.groupby('category')['sales'].transform('sum')

# 2. 计算当前订单在同品类中的占比
df['sales_ratio'] = df['sales'] / df['category_total']

# 3. 组内标准化 (Z-score)
df['z_score'] = df.groupby('category')['sales'].transform(
    lambda x: (x - x.mean()) / x.std()
)
transform 的关键特性在于:传入子组的 Series 长度为 $N$,其计算后返回的对象长度也必须为 $N$(或者返回单个标量由 Pandas 自动扩展为长度 $N$)。因此,它的输出形状始终与原 DataFrame 对齐。
五、深度辨析:agg vs transform vs apply
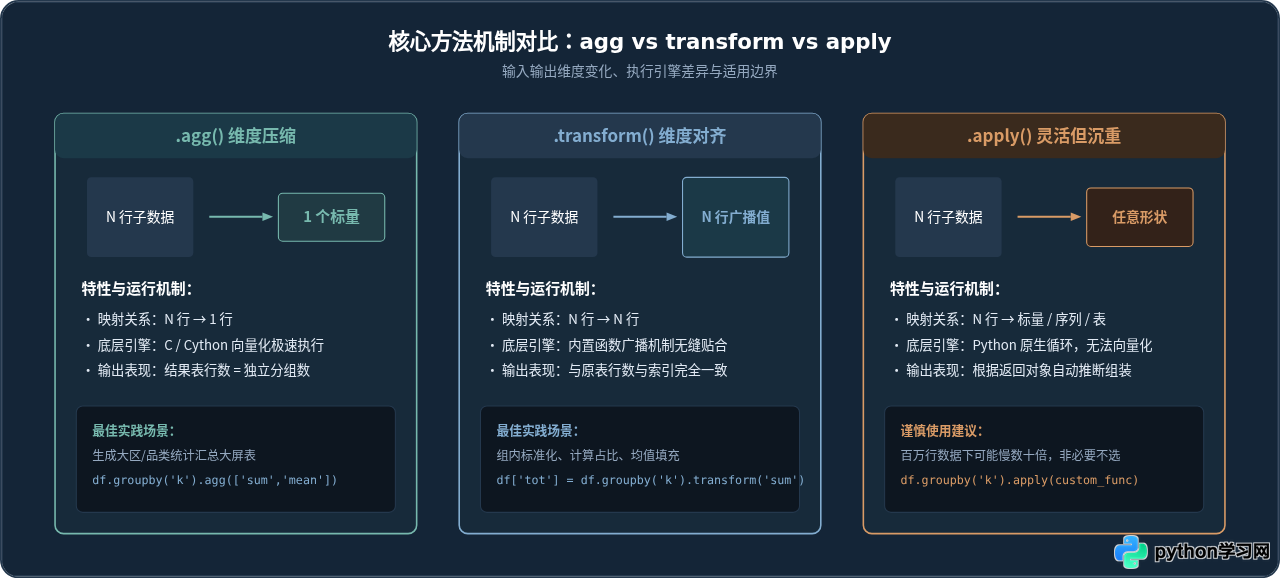
很多开发者在面对复杂分组逻辑时,习惯无脑使用 .apply()。然而在生产环境中,这常常是性能崩溃的根源。理解这三个方法的适用边界至关重要:
| 方法 | 输入形状 | 输出形状 | 底层实现机制 | 最佳适用场景 |
|---|---|---|---|---|
agg() |
$N$ 行子组数据 | 1 行标量聚合值 | Cython / C 级向量化高度优化 | 求和、均值、极值、分位数等纯汇总统计 |
transform() |
$N$ 行子组数据 | $N$ 行与原表对齐 | 内置函数具备 Cython 广播优化 | 组内占比、去均值、累计求和、缺失值填补 |
apply() |
$N$ 行的 DataFrame/Series | 任意维度(标量、Series 或 DF) | 纯 Python 级别遍历循环 | 必须跨多列依赖或结构不可预知的极端复杂逻辑 |
六、进阶技巧:组内筛选与 Top-N 提取
1. 组级过滤:filter()
有时我们需要排除整个不满足条件的组。例如:只保留总订单金额超过 10,000 元的品类,且保留这些品类下的原始所有订单明细。如果先 agg 筛选再 isin 过滤,步骤非常琐碎。使用 filter() 只需一行:
# 过滤出销售总额达标的整个类别所有订单
high_val_categories = df.groupby('category').filter(
    lambda group: group['sales'].sum() > 10000
)
2. 高效获取组内 Top-N
一个经典的高频业务问题是“取每个大区销售额前两名的订单”。常见误区是在 apply 中写循环切片:
# 低效写法(不推荐)
bad_top = df.groupby('region').apply(
    lambda g: g.sort_values('sales', ascending=False).iloc[:2]
)

# 高效原生推荐写法
# 先全局排序,再利用 groupby().head()
good_top = df.sort_values(['region', 'sales'], ascending=[True, False]).groupby('region').head(2)
由于 sort_values 和 head() 均在底层 C 引擎中优化,其执行效率相较于在 Python 解释器中逐个子组执行切片快一个数量级。
七、性能优化与生产避坑清单
- 传递字符串函数名而非原生 Python 函数:使用
.agg('mean')或.agg(avg=('col', 'mean')),不要写.agg(np.mean)或.agg(lambda x: x.mean())。字符串别名能够触发 Pandas 内部针对 NumPy 连续数组的快速 Cython 聚合路径。 - 高基数或重复文本列转为 Category 类型:如果分组键是包含较多重复值的字符串列,在
groupby之前将其转换为df['col'] = df['col'].astype('category')。不仅内存减少 70% 以上,哈希聚合速度还会成倍提升。 - 留意
observed参数:在对 Categorical 类型列进行分组时,Pandas 2.0+ 推荐显式声明df.groupby('cat_col', observed=False)或True,明确是否包含在数据中未实际出现的类别,避免潜在的空行开销与弃用告警。 - 避免在聚合后频繁 chained assignment:使用
assign()链式调用或者直接生成新表,防止产生SettingWithCopyWarning警告。
总结
掌握 Pandas 的数据分组与聚合不仅是记住 .groupby() 的调用形式,更在于根据数据规模与业务目标选择恰当的技术路线:
- 使用 命名聚合(Named Aggregation) 替代传统字典聚合,彻底告别难以维护的复合列索引;
- 善用
transform完成组内广播与标准化,避免不必要的表连接开销; - 用 全局排序结合
groupby().head()代替慢速的apply切片,实现高效组内 Top-N; - 优先利用 Pandas 内置的字符串函数名激活 Cython 向量化加速,并配合
category类型的合理转换,让大数据量统计既轻盈又稳健。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









