

Python logging模块核心机制与树形结构解析

本文深入解析Python logging模块的底层机制,重点阐述Logger对象的树形结构设计、日志消息的父子传递逻辑以及Handler的配置策略。通过具体代码示例,说明如何避免重复输出并正确配置根Logger与子Logger的关系,帮助开发者掌握日志系统的核心用法。
Logger的树形结构设计
Python 的 logging 模块采用树形结构来组织 Logger 对象。每个 Logger 实例都拥有一个 parent 属性,用于指向其父级 Logger。当调用 logging.getLogger(name=None) 且未指定名称时,系统会返回全局的根 Logger(root logger)。根 Logger 的 parent 属性为 None,标志着树的顶端。
当 Logger 的名称包含点号(如 'a.b')时,系统会尝试寻找其父节点。如果父节点已存在,则新创建的 Logger 作为该父节点的子节点;如果父节点不存在,系统会自动创建父节点,并将新 Logger 作为根 Logger 的子节点。这种设计使得 Logger 之间形成了清晰的层级关系。
日志消息的传递机制
在树形结构中,子 Logger 默认会将日志消息传递给其父 Logger。这意味着,如果父 Logger 配置了 Handler,子 Logger 产生的日志也会通过父 Logger 的 Handler 输出。这种机制允许开发者只需为顶层 Logger 配置 Handler,即可统一管理整个日志树的输出。
然而,这种传递机制也可能导致日志重复输出。例如,如果子 Logger 和父 Logger 都配置了 Handler,那么同一条日志消息可能会被输出两次。为了避免这种情况,可以通过设置子 Logger 的 propagate 属性为 False 来关闭传递机制。或者,更常见的做法是,只保留顶层 Logger 的 Handler,而不在子 Logger 中重复配置 Handler。
代码示例与操作
以下代码展示了如何创建 Logger 并配置 Handler,以及如何处理日志重复输出的问题:
import logging

# 创建 Logger A 并配置 Handler
logA = logging.getLogger('a')
logA.setLevel(logging.DEBUG)
logA.addHandler(logging.StreamHandler())

# 创建 Logger B(a.b)并配置 Handler
logB = logging.getLogger('a.b')
logB.addHandler(logging.StreamHandler())

# 记录日志
logB.info('Test message')
在上述示例中,Logger B 是 Logger A 的子节点。由于 Logger B 和 Logger A 都配置了 StreamHandler,因此调用 logB.info() 时,日志消息会被输出两次:一次通过 Logger B 的 Handler,另一次通过 Logger A 的 Handler(因为消息会传递给父节点)。
为了避免重复输出,可以移除 Logger B 的 Handler,或者设置 logB.propagate = False。推荐的做法是只保留顶层 Logger 的 Handler,这样既能统一管理日志输出,又能避免重复。
实际应用中的注意事项
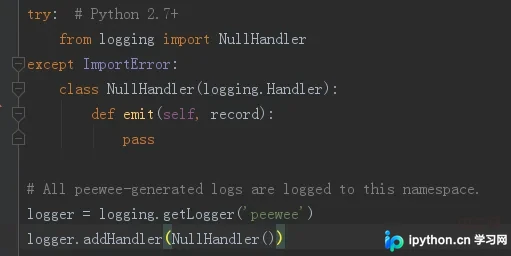
在实际项目中,合理使用 Logger 的树形结构和传递机制可以显著提高日志管理的效率。例如,在使用 peewee 框架时,可以为 peewee 定义一个名为 'peewee' 的 Logger,并通过设置其 parent 属性为主程序的 Logger,使得 peewee 的日志能够与主程序的日志统一管理。此外,peewee 还提供了一个 NullHandler,供调用者使用,以避免在没有配置 Handler 时产生警告信息。
总之,理解 Python logging 模块的树形结构和日志传递机制,对于编写高质量、易维护的日志系统至关重要。通过合理配置 Logger 和 Handler,可以有效避免日志重复输出,提高日志管理的灵活性和效率。
以上就是Python logging模块核心机制与树形结构解析的详细内容,更多关于Python日志处理的技术资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









