

Python内置库vs第三方库:这10个标准库其实足够强大
深入对比Python内置标准库与第三方库的选型权衡,系统讲解pathlib、dataclasses、sqlite3、collections等10个强大标准库的核心功能、代码示例与替代场景。
许多 Python 开发者在遇到新需求时,第一反应往往是打开终端执行 pip install。虽然开源生态拥有海量现成工具,但过度依赖第三方包会直接增加部署体积、加重安全审计负担,并可能在版本迭代时引发连锁兼容问题。实际上,Python 随身附带的“自带电池”(Batteries Included)标准库经过数十年打磨,在性能、健壮性与易用性上已经达到了极高水准。本文将给出明确的选型决策标准,并逐一剖析 10 个足够强大、在绝大多数日常场景下完全可以替代第三方依赖的内置标准库。
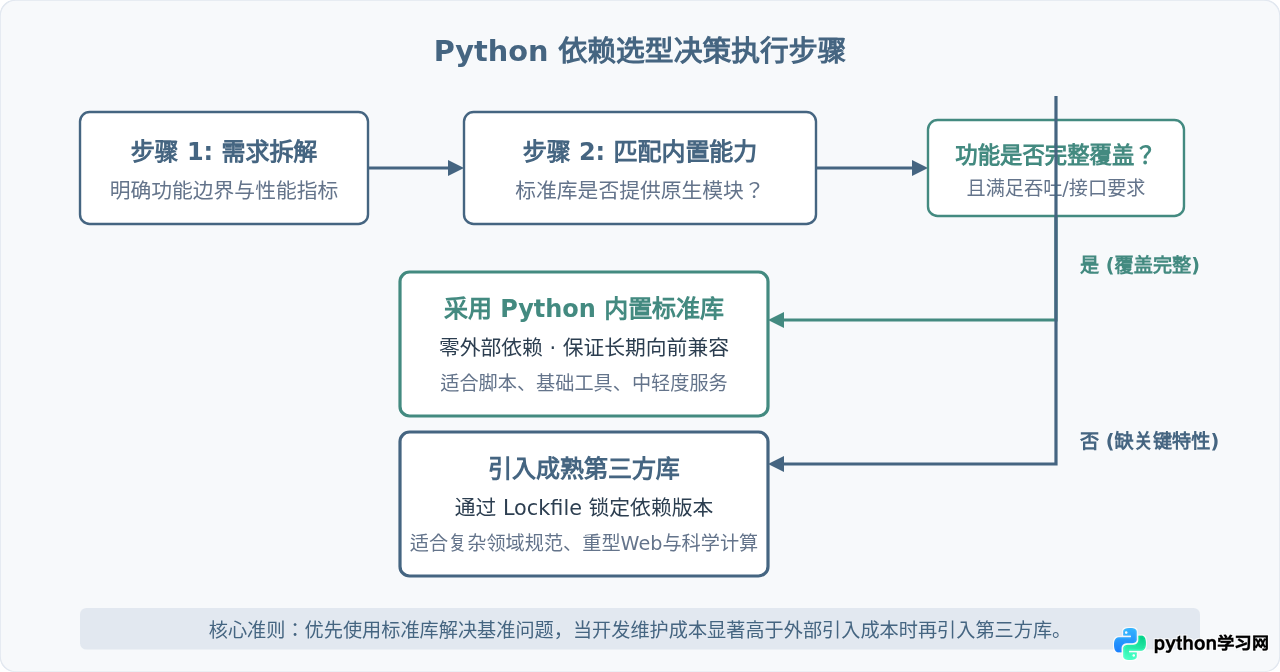
一、内置库与第三方库的核心抉择依据
选择内置库还是第三方库,本质上是在“开发便捷性”、“分发维护成本”与“专业极限性能”之间做平衡。评估一个需求是否应引入第三方库,可以从以下三个维度考量:
- 分发与部署约束:若是编写自动化运维脚本、跨团队命令行工具或嵌入式设备程序,零外部依赖意味着单文件或极简环境即可执行,省去了网络下载 wheel 包、wheel 编译环境缺失或内网镜像源配置失败的麻烦。
- 长期维护与依赖漂移:标准库严格遵守 Python 官方的弃用策略,API 极具向后兼容性;而第三方库可能因作者停更、非向后兼容大版本升级(如破坏性重构)导致代码年久失效。
- 功能覆盖度真实评估:当项目仅需要用到一个大型第三方库 10% 的基础功能时(例如仅需要发送一个简单的 GET 请求却引入了包含完整证书链管理与连接池的重量级依赖),标准库通常是更优解。
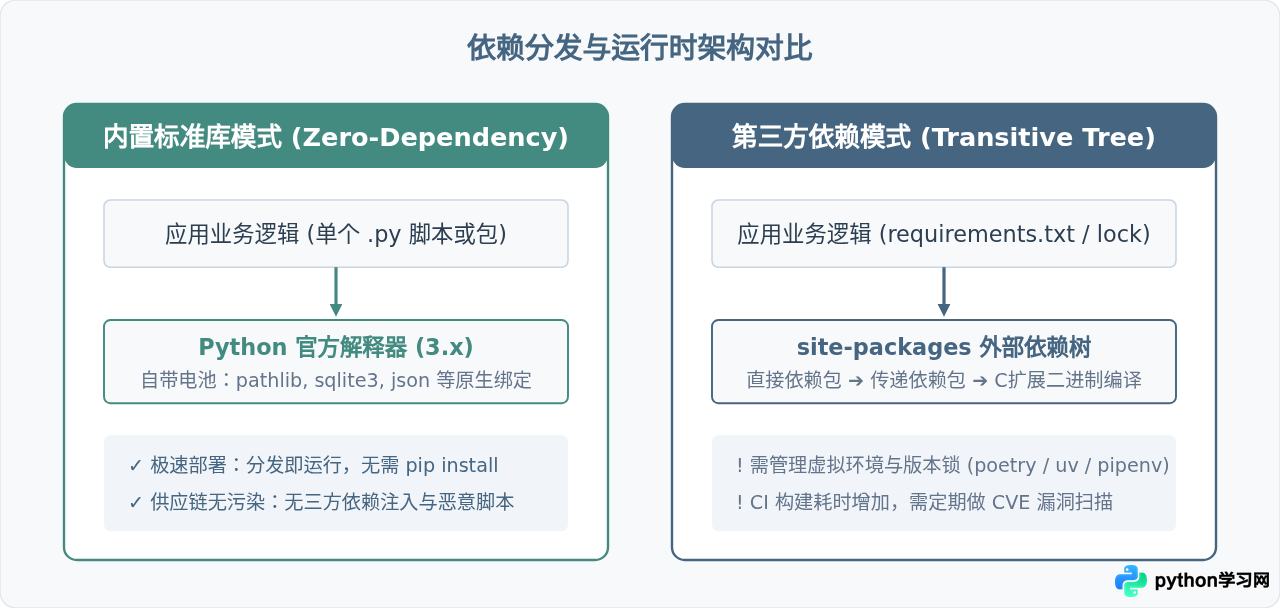
二、依赖链复杂度与系统分发:底层架构对比
很多工程隐患并非来自于第一层直接依赖,而是隐藏在“依赖的依赖”(传递性依赖)之中。使用标准库的程序,其调用链始终收敛在 Python 解释器内;而依赖第三方库时,构建、分发与安全审计的链路会成倍拉长。
三、这 10 个标准库足以替代常见第三方依赖
下面介绍的 10 个标准库均内置于 Python 中,无需任何额外安装命令即可直接导入。我们将结合具体应用场景和代码对比,展示它们的实际威力。
1. pathlib —— 终结繁琐的字符串路径拼接
在 Python 3.4 之前,路径处理依赖 os.path 和 glob,代码充斥着嵌套的 os.path.join()、os.path.dirname() 与字符串切片。不少人为此引入了第三方路径库。现代标准库中的 pathlib 提供了面向对象的直观路径操作体验。
from pathlib import Path

# 获取当前工作目录下的配置路径并直接读取文本
base_dir = Path.cwd()
config_file = base_dir / "config" / "settings.json"

# 判断是否存在并快速写入内容(无需显式 open/close)
if not config_file.exists():
    config_file.parent.mkdir(parents=True, exist_ok=True)
    config_file.write_text('{"env": "production"}', encoding="utf-8")

# 递归匹配所有的 .log 文件
for log_path in base_dir.rglob("*.log"):
    print(f"日志文件: {log_path.name}, 大小: {log_path.stat().st_size} 字节")
2. dataclasses —— 轻量级结构化数据建模
很多开发者为了给对象提供优雅的 __repr__、__eq__ 或类型注解,会直接安装 attrs 甚至引入沉重的 pydantic。如果只是在内部流转结构化数据而不需要复杂的外部请求验证,Python 3.7+ 的 dataclasses 是极佳的选择。
from dataclasses import dataclass, field
from typing import List

@dataclass(frozen=True)
class ServiceNode:
    host: str
    port: int = 8080
    tags: List[str] = field(default_factory=list)

    @property
    def endpoint(self) -> str:
        return f"http://{self.host}:{self.port}"

node = ServiceNode(host="10.0.0.1", tags=["web", "primary"])
print(node)  # 输出格式化对象: ServiceNode(host='10.0.0.1', port=8080, tags=['web', 'primary'])
# frozen=True 保证了不可变性,甚至可以直接作为字典的 key 或 set 的元素
3. sqlite3 —— 零配置的完整内嵌关系型数据库
对于单机应用、测试装置、配置缓存或中小型本地分析任务,部署外部 MySQL/PostgreSQL 或额外安装 TinyDB 等轻量库常常徒增复杂度。标准库自带的 sqlite3 支持完整的 SQL 语法、事务与内存库模式。
import sqlite3

# 使用内存数据库进行高效数据隔离与测试
conn = sqlite3.connect(":memory:")
cursor = conn.cursor()

cursor.execute("""
    CREATE TABLE metrics (
        id INTEGER PRIMARY KEY AUTOINCREMENT,
        metric_name TEXT NOT NULL,
        val REAL NOT NULL
    )
""")

# 批量安全参数化插入,杜绝 SQL 注入
data = [("cpu_percent", 42.5), ("memory_used_mb", 1024.0)]
cursor.executemany("INSERT INTO metrics (metric_name, val) VALUES (?, ?)", data)
conn.commit()

# 查询并映射
for row in cursor.execute("SELECT metric_name, val FROM metrics WHERE val > 50"):
    print(f"告警指标: {row[0]} = {row[1]}")

conn.close()
4. collections —— 解决复杂数据聚合与容器扩展
编写计数逻辑或字典分组时,手动判断 key 是否存在会产生大量冗余代码。collections 提供了 Counter、defaultdict、deque 等高效容器,直接超越手写循环与额外工具库。
from collections import Counter, defaultdict, deque

# 1. 词频统计与最常见项提取
words = ["python", "standard", "library", "python", "fast", "standard", "python"]
counter = Counter(words)
print(counter.most_common(2))  # [('python', 3), ('standard', 2)]

# 2. 避免键缺失异常的分组映射
grouped = defaultdict(list)
items = [("fruit", "apple"), ("vegetable", "carrot"), ("fruit", "banana")]
for category, item in items:
    grouped[category].append(item)

# 3. 高性能双端队列(O(1) 两端存取,适合滑动窗口)
sliding_window = deque(maxlen=3)
for i in range(5):
    sliding_window.append(i)
print(list(sliding_window))  # 输出最后 3 项: [2, 3, 4]
5. itertools —— 内存友好的高效管道迭代
当处理大规模序列或组合排列时,第三方库(如 toolz、more-itertools)确实好用,但标准库 itertools 纯 C 实现的高性能迭代器已经能够胜任大多数聚合、切片与笛卡尔积运算,且占用极低内存。
import itertools

# 批量切片与按条件分组
data = [1, 2, 3, 4, 5, 6, 7, 8, 9]

# 累加运算: [1, 3, 6, 10, ...]
accumulated = list(itertools.accumulate(data))

# 多个集合的笛卡尔乘积(替代多重嵌套 for 循环)
colors = ["red", "blue"]
sizes = ["S", "M"]
combinations = list(itertools.product(colors, sizes))
# 结果: [('red', 'S'), ('red', 'M'), ('blue', 'S'), ('blue', 'M')]

# 连续链合并
chained = list(itertools.chain(["a", "b"], [1, 2]))
# 结果: ['a', 'b', 1, 2]
6. functools —— 缓存与函数式编程利器
无需引入诸如 cachetools 之类的第三方库,functools.lru_cache 就能为任意纯函数提供工业级的内存最近最少使用(LRU)缓存,显著降低高开销调用的计算时间。
from functools import lru_cache, partial

# 带有最大容量限制的函数级结果缓存
@lru_cache(maxsize=128)
def fetch_database_meta(table_id: int):
    # 模拟耗时较长的数据提取或转换
    return {"table_id": table_id, "schema": "public"}

# 偏函数:冻结部分参数,快速构建专用接口
def power(base: int, exponent: int) -> int:
    return base ** exponent

square = partial(power, exponent=2)
cube = partial(power, exponent=3)

print(square(5))  # 25
print(cube(3))    # 27
7. concurrent.futures —— 极简统一的异步执行池
许多开发者在面对并发任务时,会直接研究复杂的多线程或进程锁,甚至额外安装异步运行器。concurrent.futures 将多线程与多进程统一为同一套 Executor 抽象,代码切换成本极低。
from concurrent.futures import ThreadPoolExecutor, as_completed
import time

def check_service(service_name: str) -> str:
    time.sleep(0.1)  # 模拟网络延迟
    return f"{service_name}: OK"

services = ["auth-srv", "order-srv", "payment-srv", "notify-srv"]

# 线程池并发执行 I/O 密集型任务
with ThreadPoolExecutor(max_workers=4) as executor:
    future_to_service = {executor.submit(check_service, s): s for s in services}
    for future in as_completed(future_to_service):
        svc = future_to_service[future]
        try:
            status = future.result()
            print(f"检查完成: {status}")
        except Exception as exc:
            print(f"服务 {svc} 异常: {exc}")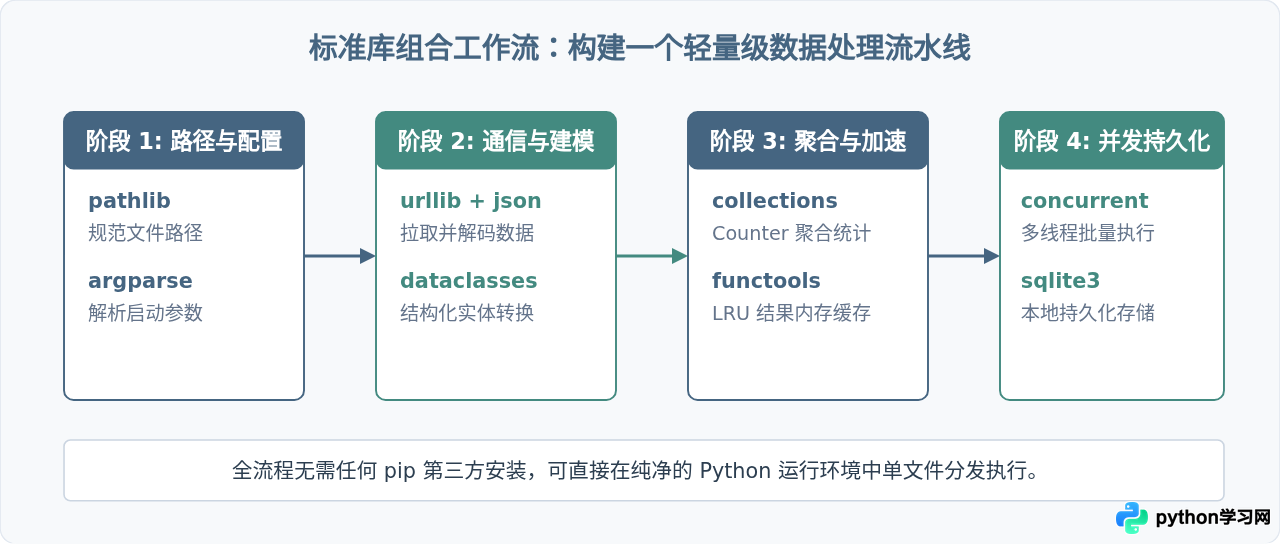
8. urllib.request 与 json —— 极简环境下的 HTTP API 调用
requests 和 httpx 是 Python 事实上的 HTTP 标杆,但在只需要请求内部只读 API 或单次 Webhook 推送时,引入庞大的外部包并不经济。标准库的 urllib.request 配合 json 可以无障碍完成基本的 GET/POST 交互。
import urllib.request
import json

url = "https://api.github.com/zen"
req = urllib.request.Request(
    url,
    headers={"User-Agent": "Python-Standard-Lib-Client", "Accept": "application/json"}
)

# 纯标准库完成网络拉取与超时控制
try:
    with urllib.request.urlopen(req, timeout=5) as response:
        if response.status == 200:
            content = response.read().decode("utf-8")
            print(f"响应成功: {content}")
except urllib.error.URLError as err:
    print(f"请求失败: {err.reason}")
9. argparse —— 强大而工业级的 CLI 界面解析
虽然第三方库如 click 或 typer 提供了基于装饰器或类型提示的甜味语法,但标准库内置的 argparse 功能完全覆盖了子命令(subparsers)、互斥参数组、自动帮助生成(--help)以及类型自动校验。
import argparse

parser = argparse.ArgumentParser(description="运维分析与执行工具")
parser.add_argument("--host", required=True, help="远程服务器地址")
parser.add_argument("--port", type=int, default=22, help="SSH 端口 (默认: 22)")
parser.add_argument("--dry-run", action="store_true", help="演练模式,不实际变更")

args = parser.parse_args()
print(f"连接至 {args.host}:{args.port}, 演练模式: {args.dry_run}")
10. secrets 与 hashlib —— 安全合规的随机与数据摘要
很多开发者在生成随机 Token 或密码时习惯调用 random.choice(),这是严重的安全隐患(random 基于梅森旋转算法,是可预测的伪随机)。Python 3.6+ 内置的 secrets 专门利用操作系统底层熵池生成加密学安全随机数;配合 hashlib 即可完成行业标准级的数据防篡改与身份核对。
import secrets
import hashlib

# 1. 生成安全的一次性访问令牌(适用于密码重置、OAuth Token)
token = secrets.token_urlsafe(32)
print(f"安全随机 Token: {token}")

# 2. 数据安全摘要核算
data_bytes = "system_sensitive_payload".encode("utf-8")
sha256_hash = hashlib.sha256(data_bytes).hexdigest()
print(f"SHA-256 摘要: {sha256_hash}")

# 3. 常量时间字符串比对(防时序攻击)
is_valid = secrets.compare_digest(sha256_hash, sha256_hash)
四、10 个强大标准库功能全景与替代对照矩阵
为了帮助读者在日常开发中形成快速对照,下表和全景图总结了这 10 个标准库的典型定位、替代目标及推荐场景:
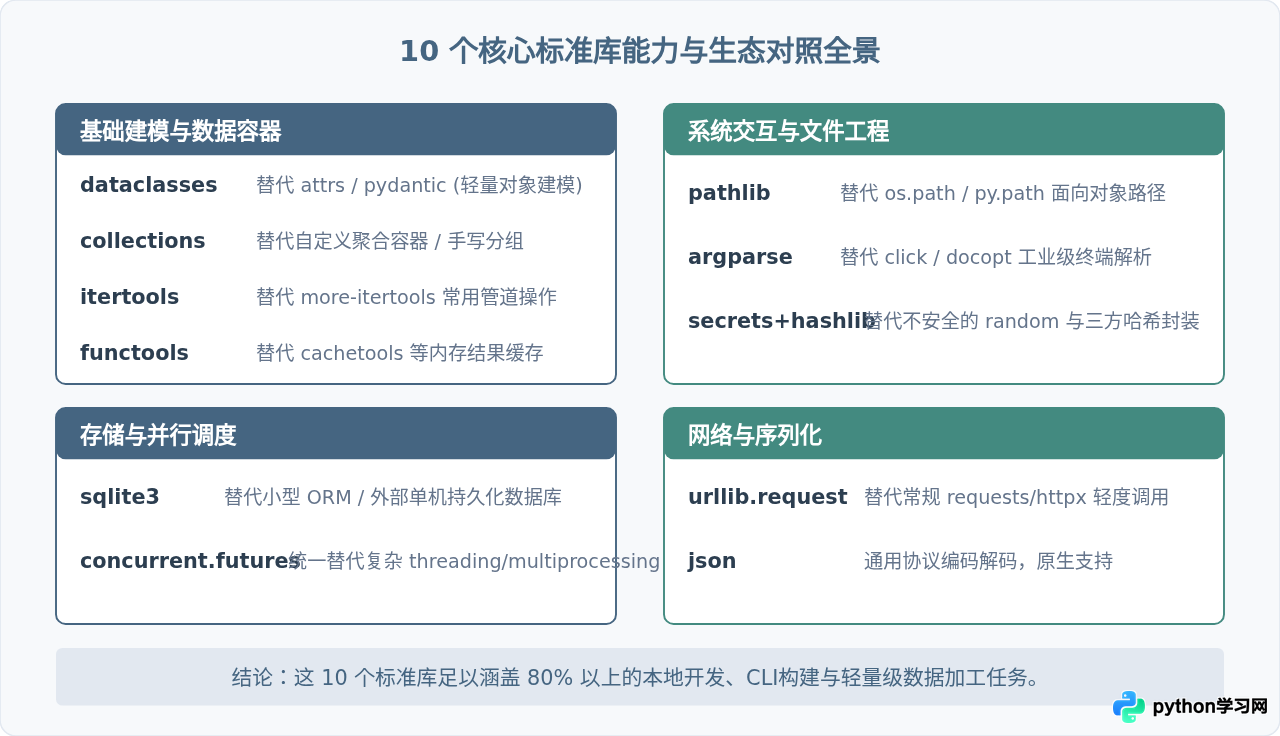
| 标准库模块 | 核心替代对象 | 首选推荐场景 | 何时必须选用第三方库 |
|---|---|---|---|
pathlib |
os.path, py.path |
任何跨平台文件查找、读写、遍历与路径计算 | 涉及云对象存储统一抽象(如 fsspec) |
dataclasses |
attrs, 轻量 pydantic |
内部对象属性封装、DTO、状态传输 | 外部 HTTP 请求输入自动校验与反序列化约束 |
sqlite3 |
外部轻量 DB, 简单文件存储 | 本地缓存、单机报表、单元测试数据暂存 | 高并发多客户端写入、分布式数据节点 |
collections |
手写聚合循环、工具类 | 频次统计、缺失键处理、定长滑动窗口 | 需持久化或内存压缩的超大规模专用结构 |
itertools |
more-itertools, toolz |
惰性数据流切片、累加、全组合笛卡尔积 | 复杂窗口运算与分布式流计算 |
functools |
cachetools |
确定性函数计算结果缓存、偏函数固定参数 | 多节点分布式缓存(如 Redis)或带过期淘汰机制 |
concurrent.futures |
直接调用 threading / multiprocessing |
批处理 I/O 等待、多核 CPU 计算任务拆分 | 分布式任务队列(如 Celery、Ray) |
urllib.request |
requests, httpx |
运维单脚本抓取、单次 Webhook、基础健康检查 | 复杂连接池、OAuth 流、HTTP/2 或高并发异步抓取 |
argparse |
click, typer |
标准 CLI 运维指令、CI 脚本参数入口 | 拥有富文本终端交互、进度条、复杂自动补全工具 |
secrets / hashlib |
random, 外部哈希工具 |
安全密码生成、访问令牌发放、文件内容指纹 | 非对称密钥对管理与硬件安全模块(HSM)集成 |
五、何时应该果断转向第三方库?
坚持“优先使用标准库”并不等于排斥第三方生态。在以下场景中,执着于纯标准库反而属于重复造轮子:
- 高性能密集型计算:当需要处理矩阵运算、海量表格数据清洗时,使用原生列表与循环在性能上完全无法与基于 C/Fortran/Rust 底层优化的
numpy、polars相抗衡。 - 复杂工业级网络通信:若系统需要长连接复用、细粒度重试重定向、HTTP/2 支持或复杂的 SSL/TLS 证书深度绑定,
httpx或requests无论在健壮性还是 API 友好度上都显著优于urllib。 - 大型现代 Web 框架:构建生产级 API 服务时,标准库的
http.server仅供教学或快速静态文件共享使用;生产环境应直接选择FastAPI、Django或Flask。
node_modules 式依赖地狱,还能使分发更加干脆、执行更加稳健。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









