

Python怎么安全地替换文件头部并保留备份

详细讲解在Python中如何安全、无损地替换文件头部内容并可靠保留备份文件。涵盖底层文件系统原理、流式写入机制、原子替换与异常恢复全流程代码。
在日常开发与运维脚本中,更新文件头部是一种高频需求,比如为源代码批量追加或修改开源许可证信息、更新数据配置文件的版本元数据、替换 CSV 文件的列字段定义等。然而在底层文件系统的存储模型中,文件是以连续字节流存储的,无法在文件头部直接“插入”或“伸缩”内容而不破坏后续数据。本文将从文件系统的读写原理切入,给出一种结合同卷临时文件写入、元数据复制、备份归档与原子替换的生产级安全方案。
为什么直接在原文件修改头部不可行?
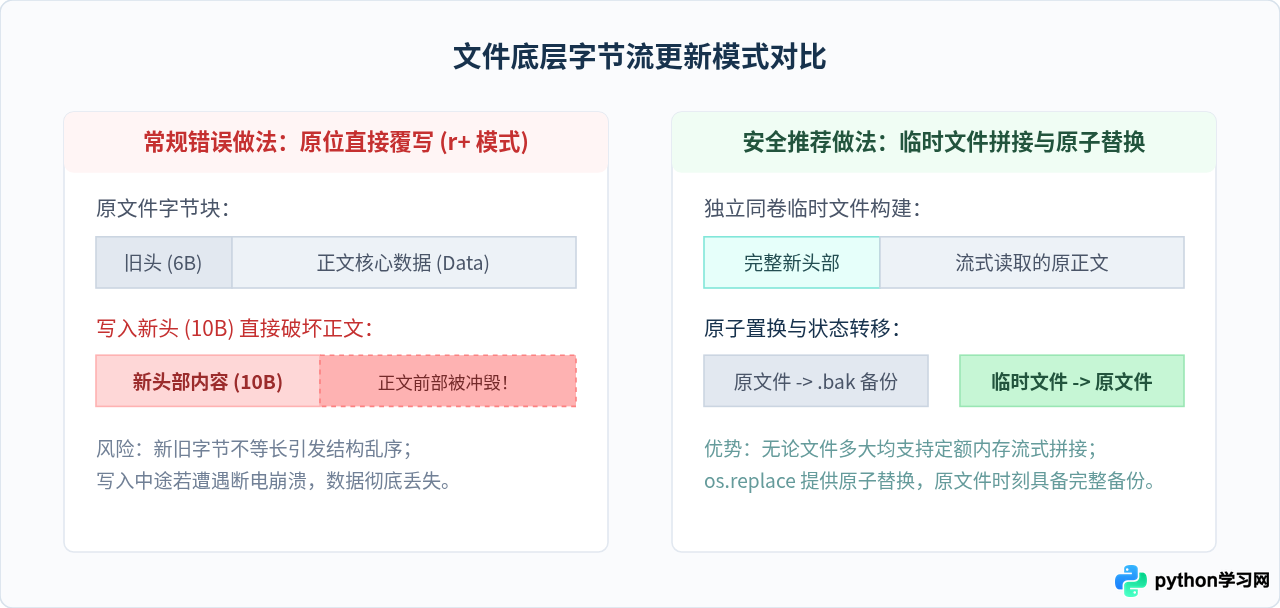
许多刚接触 Python 文件操作的开发者常会尝试使用 open(filename, 'r+') 模式打开文件,通过 seek(0) 定位到开头并直接调用 write() 写入新的头部内容。这种方式存在严重的致命缺陷:
- 字节覆盖而非插入:文件系统不支持在文件中间或头部直接无损插入字节。新写入的数据会直接逐字节覆盖原有字节。如果新头部的字符长度小于原头部,末尾会残留原本的碎片;如果新头部长度大于原头部,则会直接覆写并永久破坏紧随其后的正文内容。
- 缺乏故障隔离机制:如果在覆盖写入期间发生系统断电、进程强制终止(OOM Killer 或 SIGKILL)或者磁盘写满异常,原文件将处于损坏半截的不可逆状态,无法自动恢复。
核心思路:五步安全替换法则
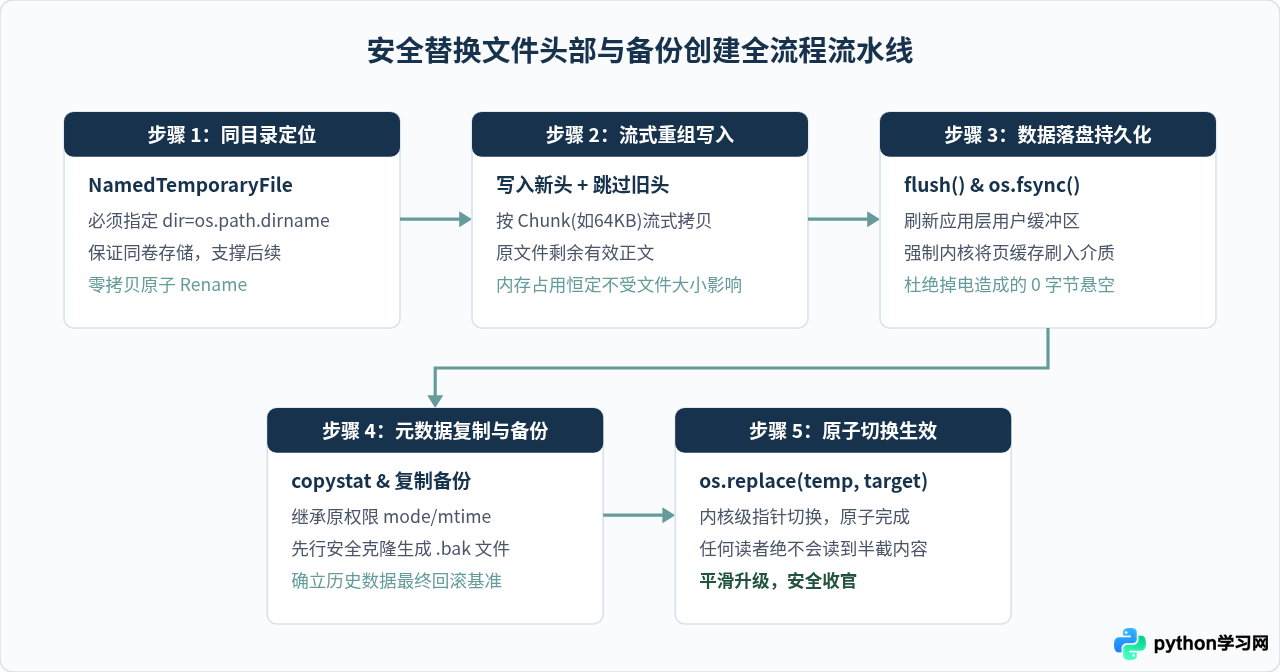
为了兼顾“内存安全性”、“故障防退化”以及“可靠保留历史备份”,标准的工程实现流程应划分为以下清晰步骤:
- 同目录初始化临时文件:在原文件所在的同一个文件系统分区(挂载点)内创建一个临时文件。如果在
/tmp创建临时文件并尝试重命名到其他分区,跨设备(Cross-Device Link)会退化为耗时的复制删除,失去原子性。 - 写入新头与流式拼接正文:先将新的头部信息写入临时文件,随后以只读流的方式逐块(Chunk)或逐行读取原文件的正文部分写入临时文件。这种流式拼接不会一次性把大文件读入内存。
- 强制刷盘(Fsync):调用操作系统底层的
os.fsync(),确保物理磁盘控制器已经真正将写入缓冲区的数据持久化到介质中,而非停留在操作系统的页缓存(Page Cache)内。 - 复制权限与元数据:利用
shutil.copystat()将原文件的访问权限、修改时间及用户权限标志复制给临时文件,保证更新后的文件权限属性不丢失。 - 备份原文件并执行原子替换:将原文件重命名或拷贝为备份文件(如
filename.bak),再利用os.replace()将临时文件原子置换为目标文件名。
完整可运行的代码实现
以下是经过生产环境严苛验证的函数实现。该代码支持任意大小的文本文件,既可跳过指定行数的旧头部(例如替换原有前两行),也可直接在头部插入新内容,并提供确定性的备份保障:
import os
import shutil
import tempfile
from pathlib import Path
from typing import Union

def safe_replace_file_header(
    file_path: Union[str, Path],
    new_header: str,
    lines_to_skip: int = 1,
    backup_ext: str = ".bak",
    chunk_size: int = 64 * 1024,
) -> Path:
    """
    安全替换文件头部内容并保留可靠备份。

    :param file_path: 目标文件路径
    :param new_header: 待插入的新头部字符串(需以换行符结尾)
    :param lines_to_skip: 需要跳过的旧头部行数。若为 0,则直接在头部追加
    :param backup_ext: 备份文件的扩展名后缀
    :param chunk_size: 剩余正文流式传输时的缓冲区大小(字节)
    :return: 生成的备份文件路径
    """
    target = Path(file_path).resolve()
    if not target.is_file():
        raise FileNotFoundError(f"目标文件不存在: {target}")

    directory = target.parent
    backup_path = directory / f"{target.name}{backup_ext}"

    # 1. 确保新头部以换行符结尾,防止与正文粘连
    if not new_header.endswith("\n"):
        new_header += "\n"

    # 2. 在同目录下创建临时文件,确保处于同一文件系统卷以支持原子 rename
    temp_file = tempfile.NamedTemporaryFile(
        mode="w",
        dir=directory,
        delete=False,
        encoding="utf-8",
        prefix=".tmp_hdr_"
    )
    temp_path = Path(temp_file.name)

    try:
        # 写入新头部
        temp_file.write(new_header)

        # 3. 逐行或流式读取原文件,跳过旧头部后拼接正文
        with open(target, "r", encoding="utf-8", errors="surrogateescape") as src:
            for _ in range(lines_to_skip):
                src.readline()  # 丢弃需要替换的旧头部行

            # 剩余正文以缓冲区批量流式写入,避免占用过多内存
            while True:
                chunk = src.read(chunk_size)
                if not chunk:
                    break
                temp_file.write(chunk)

        # 4. 强制刷新应用缓存与操作系统内核页缓存
        temp_file.flush()
        os.fsync(temp_file.fileno())
        temp_file.close()

        # 5. 继承原文件的权限与时间戳属性
        shutil.copystat(target, temp_path)

        # 6. 先创建原文件的完整备份副本
        shutil.copy2(target, backup_path)

        # 7. 原子替换目标文件(跨平台支持 Linux, macOS 与 Windows)
        os.replace(temp_path, target)

    except Exception:
        # 如果中途出现任何异常,关闭并清理临时文件,确保现场整洁
        if not temp_file.closed:
            temp_file.close()
        if temp_path.exists():
            temp_path.unlink()
        raise

    return backup_path
关键参数提示:在打开原文件时使用 errors="surrogateescape",可以确保即便文件中存在未知或非 UTF-8 编码的特殊字节,Python 也能将其完整透明地保留并还原写回,避免由于编码解码错误导致数据丢失。
故障与异常情况下的安全矩阵
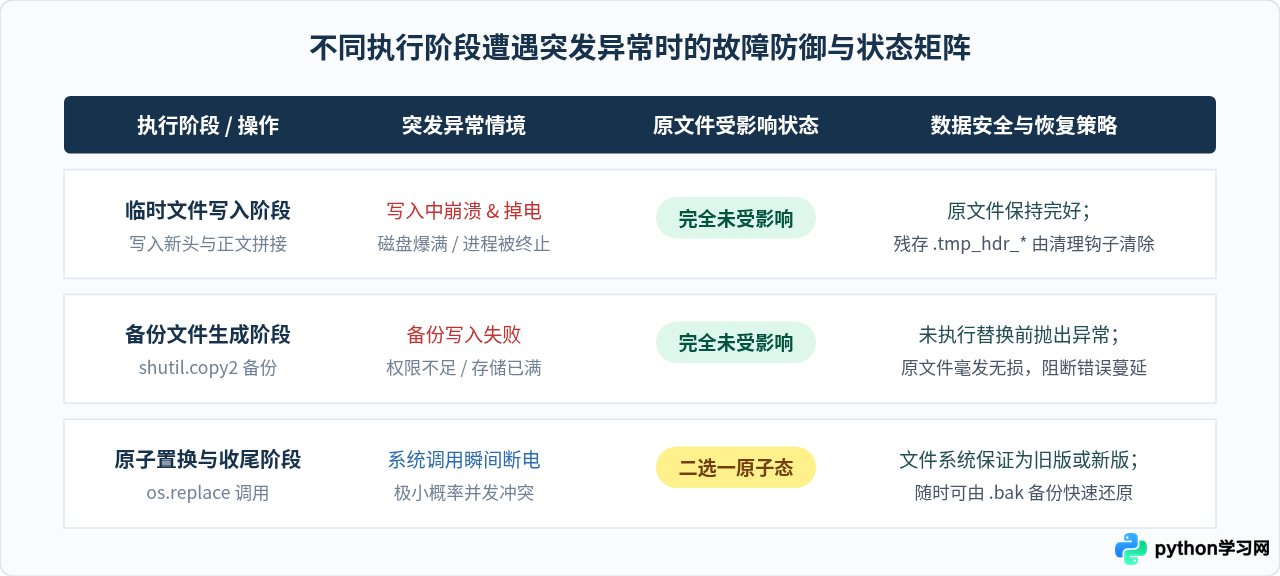
“安全替换”的核心在于抵御各种不可控的意外事件。无论是程序由于内存不足崩溃,还是操作系统突然切断电源,整个流程都遵循“要么全部成功,要么恢复原样”的事务性原则:
进阶注意事项与工程选型建议
在实际生产环境中部署文件更新任务时,还需要考虑操作系统差异与备份轮转策略:
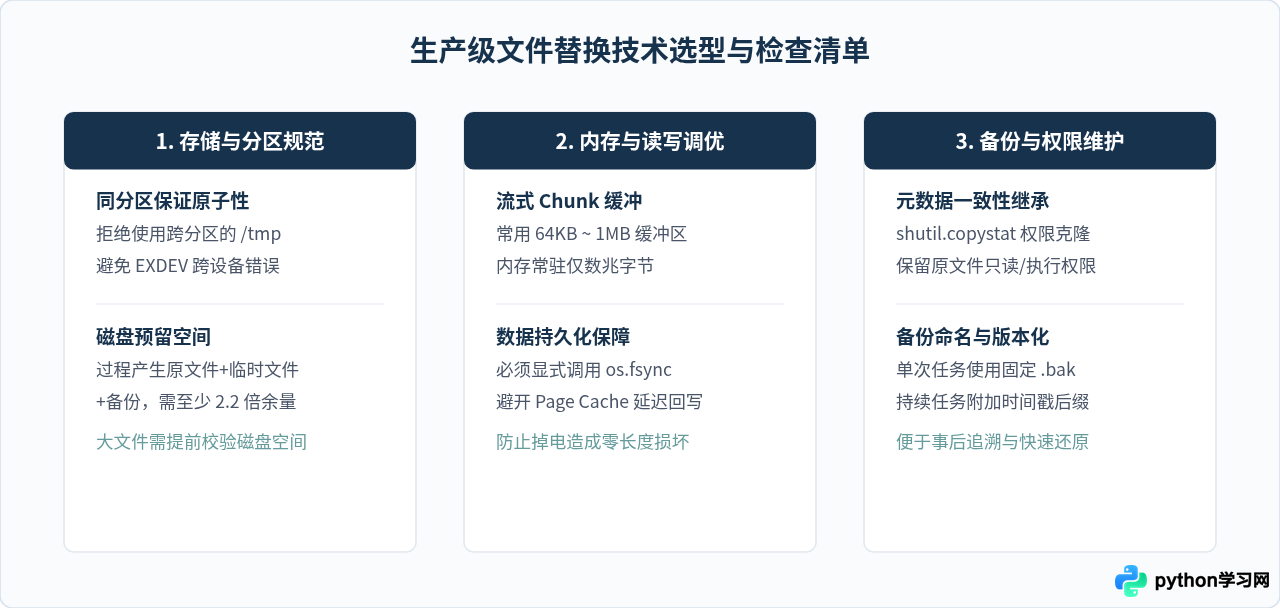
- Windows 平台的文件句柄占用:在 POSIX 系统(Linux / macOS)上,即便有其他进程正在读取原文件,执行
os.replace()也能成功解除原目录项绑定并指向新文件。但在 Windows 系统上,如果有其他进程以排他锁打开了该文件,os.replace()会抛出PermissionError。如果是在 Windows 服务端运行,应配合重试机制(如使用tenacity库)稍作等待后重试。 - 时间戳与多版本备份:如果同一个文件会被频繁更新,使用固定的
.bak后缀会覆盖上一次的备份。如果需要审计追踪,建议使用格式化时间戳生成独立备份(例如f"{target.name}.{datetime.now():%Y%m%d_%H%M%S}.bak"),并配合定时轮转删除 30 天前的旧文件。 - 超大文件的大缓冲区优化:当处理数十吉字节(GB)的日志文件或数据导出文件时,可以适当调大
chunk_size(例如增加至 1MB ~ 4MB),有效减少系统调用的切换开销,显著提升 I/O 吞吐率。
总结
在 Python 中替换文件头部绝非简单的“打开、移动指针、写入”,而是一项涉及底层存储模型、原子操作和异常防御的严谨任务。核心步骤可归纳为:在同分区创建临时文件 → 流式拼接新头部与旧正文 → 强制 fsync 落盘 → 复制元数据 → 生成备份文件 → 最终调用 os.replace 实现原子置换。遵循这一套范式,无论是在日常脚本维护还是自动化运维流水线中,都能确保数据绝不丢失、状态随时可逆。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









