

Python新手必备:os、json与datetime标准库常用方法解析
针对Python新手系统梳理os、json与datetime三大高频标准库的核心方法与应用场景,涵盖跨平台路径处理、JSON数据双向持久化、时间转换与计算,并提供综合实战与避坑指南。
编写Python脚本时,几乎所有实用任务都绕不开三个核心需求:与本地文件系统交互、解析和保存结构化数据、记录与计算业务时间。Python官方内置的 os、json 和 datetime 标准库无需额外安装,分别承担了操作系统接口、数据序列化与时间日期处理的核心职能。本文将直接拆解这三个模块最常用、最稳定的核心方法,通过具体场景、规范代码与流程图示,帮助新手建立清晰规范的标准库使用习惯。
一、os 模块:安全高效的文件与目录操作
os(Operating System)模块提供了与底层操作系统交互的基础能力。对于初学者而言,最关键的应用场景集中在跨平台路径拼接、目录创建检测以及文件遍历清理上。
1. 路径拼接与分离:为什么不能直接用加号拼接
Windows系统使用反斜杠(\)作为路径分隔符,而macOS和Linux使用正斜杠(/)。使用字符串加号拼接路径(例如 "folder/" + "file.txt")极易因斜杠漏写、多写或操作系统差异引发路径解析错误。os.path.join() 能够自动根据当前宿主系统拼接出规范合法的路径。
import os

# 安全拼接多级目录与文件名
base_dir = "workspace"
sub_dir = "logs"
filename = "app.log"

full_path = os.path.join(base_dir, sub_dir, filename)
print("拼接后的完整路径:", full_path)

# 获取所在目录路径与纯文件名
parent_dir = os.path.dirname(full_path)
base_name = os.path.basename(full_path)
print("父目录:", parent_dir)
print("文件名:", base_name)父目录: workspace/logs
文件名: app.log
2. 路径存在性检测与目录递归创建
在向文件写入数据前,如果目标目录不存在,Python会抛出 FileNotFoundError。常见的规范防御方式是先检测路径,再按需创建。os.makedirs() 配合参数 exist_ok=True 可以在创建多层嵌套目录时避免目录已存在报错。
import os

target_folder = os.path.join("output", "reports", "2026")

# exist_ok=True 表示若目录已存在则跳过,不抛出 FileExistsError
os.makedirs(target_folder, exist_ok=True)

# 检查目标是否真实存在,以及是否为目录
if os.path.exists(target_folder) and os.path.isdir(target_folder):
print(f"目录已就绪: {target_folder}")3. 文件遍历与环境变量获取
当需要批处理某个文件夹下的所有文件时,os.listdir() 可以列出该目录下的所有条目名;若需要递归扫描子文件夹,可以使用 os.walk()。读取系统配置或敏感凭据时,推荐使用 os.environ.get(),避免因环境变量未配置导致程序崩溃。
import os

# 读取系统环境变量,提供默认备用值
env_mode = os.environ.get("RUN_MODE", "development")
print(f"当前运行模式: {env_mode}")

# 列出当前工作目录下的文件与目录项
current_files = os.listdir(".")
print("当前目录包含条目数量:", len(current_files))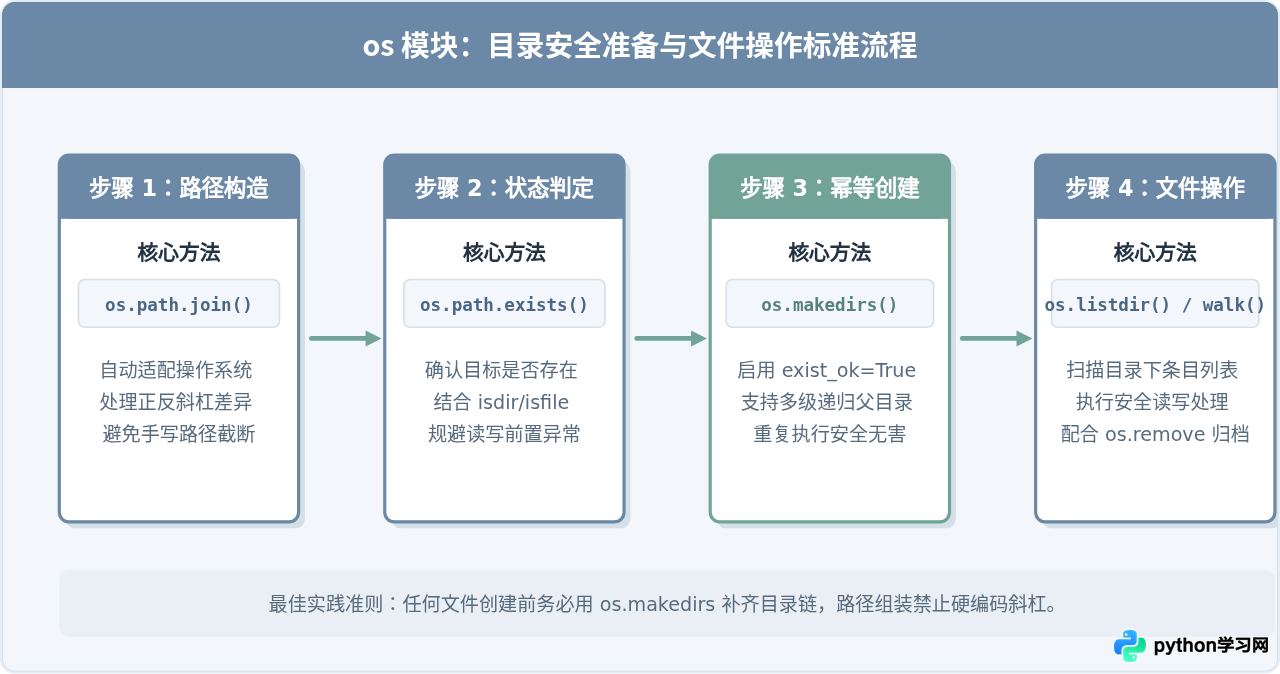
二、json 模块:数据序列化与配置交互
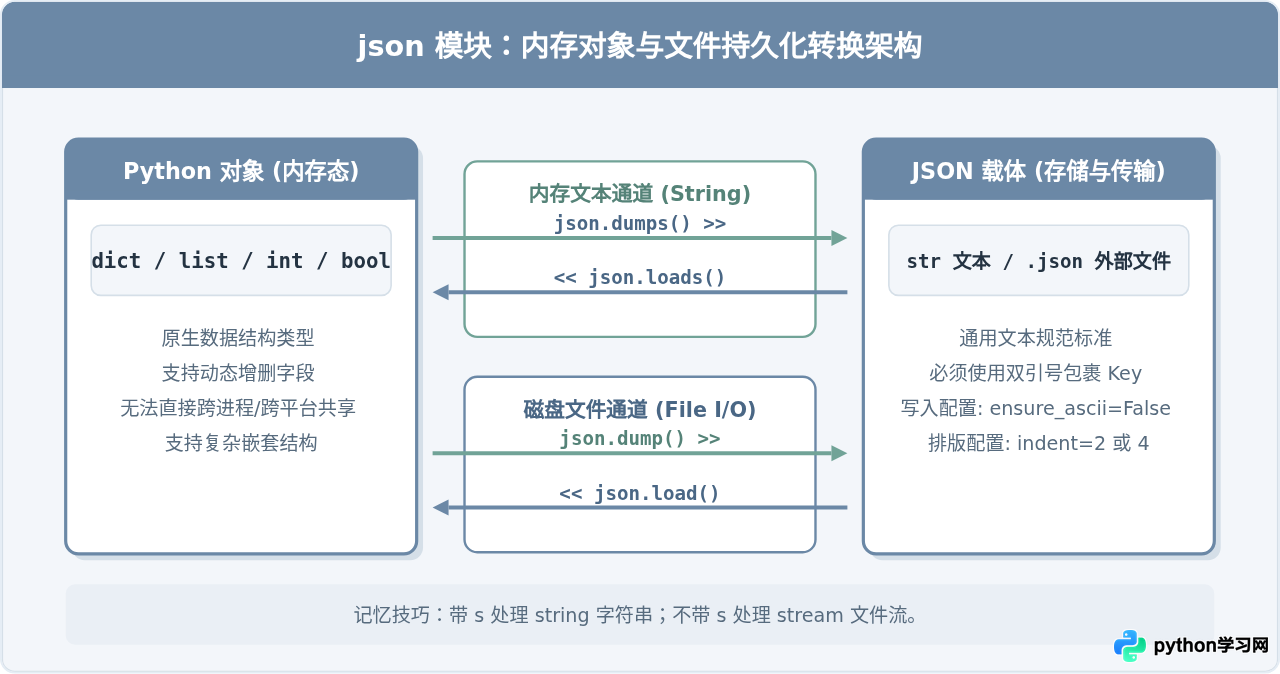
JSON(JavaScript Object Notation)是目前最通用的轻量级数据交换格式。Python内置的 json 模块负责在 Python 数据对象(字典、列表等)与 JSON 文本之间进行双向转换。初学者常困惑于带有 s 后缀(如 dumps)与不带 s(如 dump)的区别。
1. 核心四方法辨析:内存字符串 vs 磁盘文件
json.dumps()与json.loads():带字母s代表 string,操作对象为内存中的字符串。json.dump()与json.load():不带s,操作对象为真实的外部文件对象(file stream)。
import json

user_data = {
    "username": "zhangsan",
    "role": "admin",
    "tags": ["python", "developer"],
    "is_active": True
}

# 1. 序列化为内存字符串 (dumps)
json_string = json.dumps(user_data, indent=2)
print("生成的 JSON 字符串:\n", json_string)

# 2. 从字符串反序列化为 Python 字典 (loads)
parsed_dict = json.loads(json_string)
print("反序列化后的角色:", parsed_dict["role"]){
"username": "zhangsan",
"role": "admin",
"tags": [
"python",
"developer"
],
"is_active": true
}
反序列化后的角色: admin
2. 文件直读直写与中文防乱码参数
在直接将数据持久化到 .json 文件时,必须注意两个细节:一是文件打开时显式声明 encoding="utf-8";二是序列化时设置 ensure_ascii=False,否则中文字符会被默认转义为类似 \u4e2d\u6587 的 Unicode 编码,降低可读性。
import json

config = {
    "系统名称": "数据归档服务",
    "版本": "1.0.2",
    "重试次数": 3
}

# 写入文件:dump 接受目标文件指针
with open("config.json", "w", encoding="utf-8") as f:
    json.dump(config, f, ensure_ascii=False, indent=4)

# 读取文件:load 传入读取文件指针
with open("config.json", "r", encoding="utf-8") as f:
    loaded_config = json.load(f)

print("读取成功,系统名称:", loaded_config["系统名称"])避坑提示:JSON规范要求对象键(Key)必须是双引号字符串。Python中的 set(集合)、tuple(元组会被转为列表)、以及 datetime 对象不能被 json.dumps() 默认直接序列化,遇到时需提前转为列表或字符串格式。
三、datetime 模块:时间获取、格式转换与偏移计算
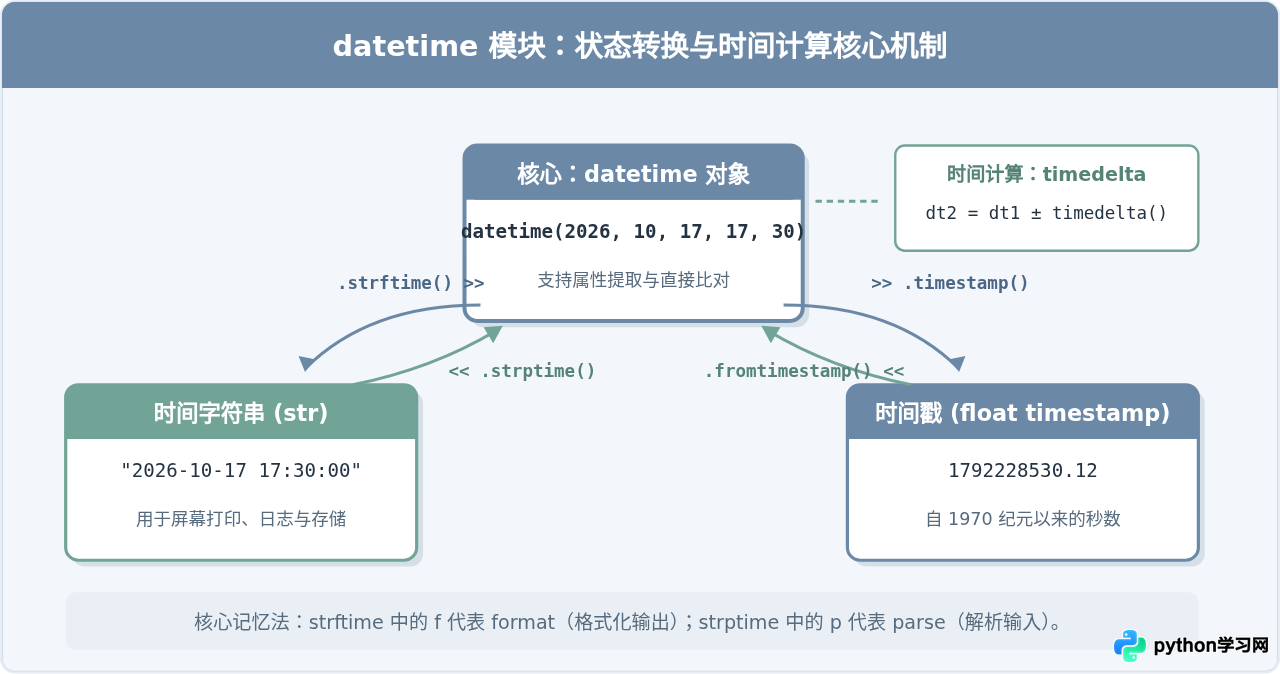
处理日志时间戳、数据采集时间或报表统计周期时,单纯用字符串保存时间无法进行早晚比对和增减计算。datetime 模块提供了专用的时间类,核心掌握当前时间获取、字符串与时间对象的双向格式化转换,以及基于 timedelta 的时间差计算。
1. 获取当前时间与时间戳互转
datetime.now() 返回包含年月日时分秒的当前系统时间对象;timestamp() 可以将其转换为以秒为单位的浮点数 Unix 时间戳。
from datetime import datetime

# 获取当前时间对象
now = datetime.now()
print("当前完整时间:", now)

# 提取关键时间属性
print(f"年: {now.year}, 月: {now.month}, 日: {now.day}")

# 转为 Unix 时间戳 (秒)
ts = now.timestamp()
print("当前时间戳:", ts)

# 从时间戳还原回 datetime 对象
restored_dt = datetime.fromtimestamp(ts)
print("还原后时间:", restored_dt)年: 2026, 月: 10, 日: 17
当前时间戳: 1792228530.123456
还原后时间: 2026-10-17 17:15:30.123456
2. 时间格式化与解析:strftime 与 strptime 的区别
新手最容易混淆 strftime 与 strptime 的用途与方向:
strftime():即 String Format Time,把datetime对象按指定格式转为字符串。strptime():即 String Parse Time,从已知格式的字符串中解析出 datetime 对象。
| 占位符 | 含义解释 | 示例值 |
|---|---|---|
%Y |
四位完整年份 | 2026 |
%m |
两位月份(01 - 12) | 10 |
%d |
两位日期(01 - 31) | 17 |
%H |
24小时制小时(00 - 23) | 17 |
%M |
两位分钟(00 - 59) | 30 |
%S |
两位秒数(00 - 59) | 45 |
from datetime import datetime

now = datetime(2026, 10, 17, 17, 30, 0)

# 1. 格式化输出 (strftime: datetime -> str)
time_str = now.strftime("%Y-%m-%d %H:%M:%S")
print("格式化字符串:", time_str)

# 2. 字符串解析 (strptime: str -> datetime)
raw_input = "2026/10/17 17:30"
parsed_time = datetime.strptime(raw_input, "%Y/%m/%d %H:%M")
print("解析后的日期对象:", parsed_time)解析后的日期对象: 2026-10-17 17:30:00
3. 时间差与周期计算:timedelta
当需要计算“7天前”、“30天后”或计算两个事件之间相差多少小时时,应当使用 timedelta 类。它直接支持与 datetime 对象进行加减运算符运算。
from datetime import datetime, timedelta

current_time = datetime(2026, 10, 17, 12, 0, 0)

# 计算 7 天前的日期(用于日志清理)
seven_days_ago = current_time - timedelta(days=7)
print("7 天前的时间:", seven_days_ago.strftime("%Y-%m-%d"))

# 计算两个时间点的时间差
start_time = datetime(2026, 10, 17, 8, 30, 0)
end_time = datetime(2026, 10, 17, 17, 45, 0)
duration = end_time - start_time

print(f"总耗时: {duration.total_seconds()} 秒,即 {duration}")总耗时: 33300.0 秒,即 9:15:00
四、综合实战:三大标准库协同落地
在真实的自动化脚本中,三个库通常紧密结合:利用 datetime 动态生成当天的日期与执行批次标记,利用 os 动态校验并建立归档文件夹,最后利用 json 读取运行配置并保存带有元数据的输出结果。
需求场景
编写一个日常数据备份脚本,要求:
- 根据当前日期自动建立如
backups/2026-10-17/的目标存储路径。 - 读取一个JSON格式的初始配置文件,补充当前备份执行时间戳、备份状态与结果数据。
- 将完整的结构化数据保存为带时间标记的独立JSON文件。
import os
import json
from datetime import datetime

def run_backup_task(job_name="daily_sync"):
    # 1. 动态生成时间字符串
    now = datetime.now()
    date_str = now.strftime("%Y-%m-%d")
    timestamp_str = now.strftime("%Y%m%d_%H%M%S")

    # 2. 使用 os 规范组织目录路径并创建
    base_backup_dir = "backups"
    target_dir = os.path.join(base_backup_dir, date_str)
    os.makedirs(target_dir, exist_ok=True)

    # 3. 构造业务数据,将时间统一转换为标准ISO文本
    backup_payload = {
        "job_name": job_name,
        "execution_date": date_str,
        "created_at": now.strftime("%Y-%m-%d %H:%M:%S"),
        "timestamp": now.timestamp(),
        "status": "SUCCESS",
        "records_processed": 1250,
        "operator": os.environ.get("USER", "system_cron")
    }

    # 4. 生成目标文件名并使用 json 持久化保存
    target_file = os.path.join(target_dir, f"{job_name}_{timestamp_str}.json")
    with open(target_file, "w", encoding="utf-8") as f:
        json.dump(backup_payload, f, ensure_ascii=False, indent=2)

    print(f"备份文件成功写入: {target_file}")
    return target_file

if __name__ == "__main__":
output_path = run_backup_task("user_audit")五、核心方法速查与避坑清单
为了帮助读者在日常编写中快速查阅与自检,我们将三个库的典型方法、关键参数与新手常见错误整合如下:
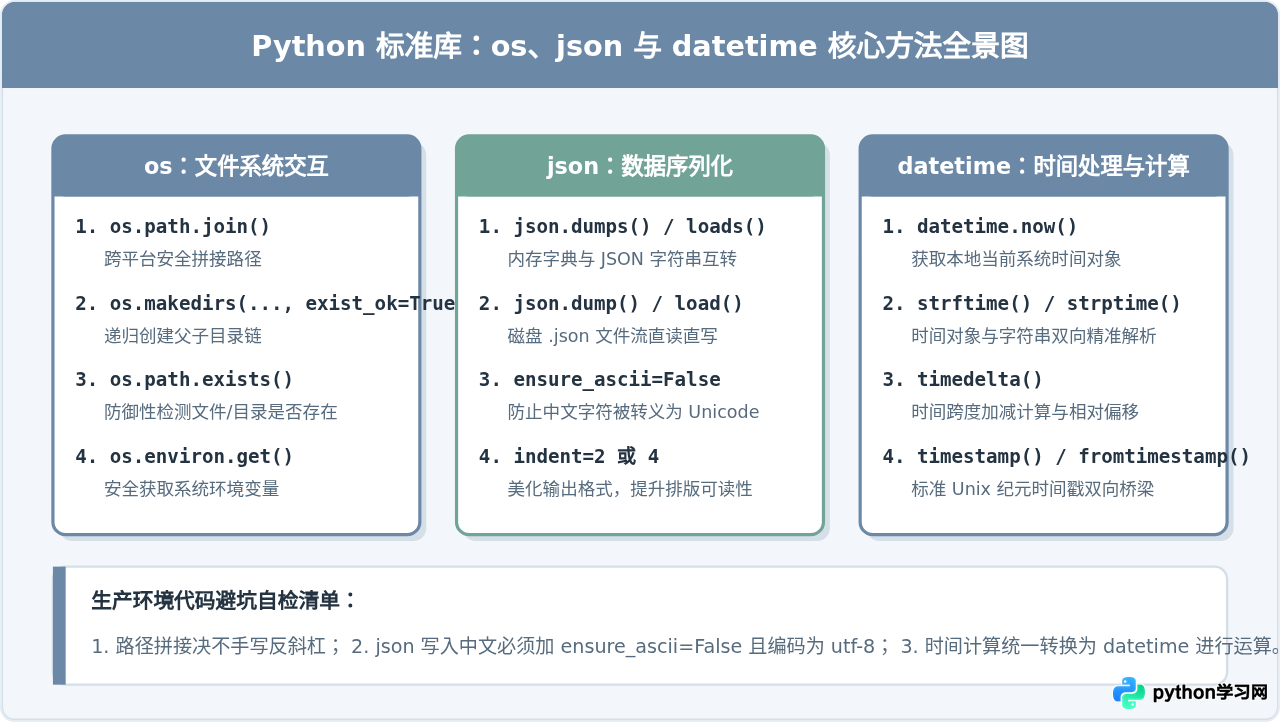
常见错误自查清单
TypeError: Object of type datetime is not JSON serializable:直接将datetime.now()放入字典并执行json.dumps()会抛出该异常。解决方案是在入库前先使用dt.strftime("%Y-%m-%d %H:%M:%S")或dt.isoformat()转换为字符串。FileNotFoundError: [Errno 2] No such file or directory:通常发生在直接打开一个位于多级深层未建目录中的文件时。解决方案是在open()之前先执行os.makedirs(os.path.dirname(file_path), exist_ok=True)。ValueError: time data '...' does not match format '...':使用strptime解析时间时,模板字符串的占位符(如%H24小时制与%I12小时制)必须与原始文本严格匹配。
掌握 os、json 与 datetime 这三大标准库的基础方法后,在面对大多数日常自动化办公、文件整理和网络接口数据保存时,都可以直接使用Python内置能力纯净、健壮地完成任务,无需引入繁重的第三方依赖。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









