

Python的序列类型有哪些:list、tuple、str、range与bytes详解
全面解析Python标准库内置的五大核心序列类型:list、tuple、str、range与bytes。深入分析序列协议、底层存储机制、性能特点、典型操作及选型决策。
在 Python 中,序列(Sequence)是一类非常基础且核心的数据结构容器,其最大特征是元素具有明确的线性排列顺序,并且每个元素都可以通过从零开始的整数索引进行快速访问。Python 内置了多种序列类型,其中最常用的五大核心序列分别是:列表(list)、元组(tuple)、字符串(str)、范围(range)与字节序列(bytes)。本文将系统阐述 Python 序列的核心抽象定义,深入拆解这五种序列的底层实现、典型操作和关键区别,并给出明确的技术选型建议。
一、什么是序列类型:核心定义与通用操作协议
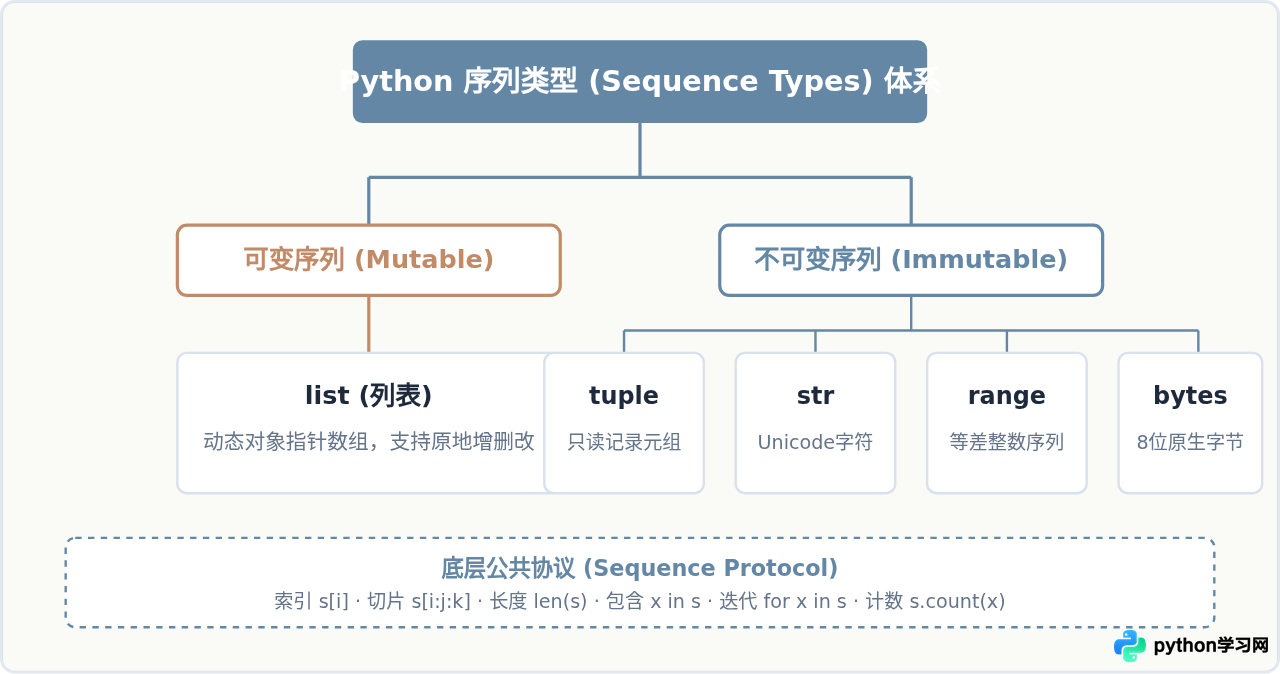
Python 采用基于协议的“鸭子类型”设计哲学。一个数据对象只要实现了 Python 序列协议规定的方法,在语义上就是序列。序列对象最基础的契约包括:元素有序、支持正负双向索引读取、支持切片运算、支持通过 len() 获取长度,以及支持迭代和成员存在性检查(in / not in)。
在 Python 的类型继承树中,序列类型通常划分为两大家族:可变序列(Mutable Sequences)与不可变序列(Immutable Sequences)。可变序列允许在创建后原地添加、删除或替换其中的元素;而不可变序列一旦在内存中分配初始化,其包含的元素引用或内容就不可再被篡改。
二、序列的核心通用操作与索引切片机制
所有序列类型共享一套高度一致的语法界面。掌握这些通用操作,是理解和运用具体序列类型的基石。
1. 双向索引机制
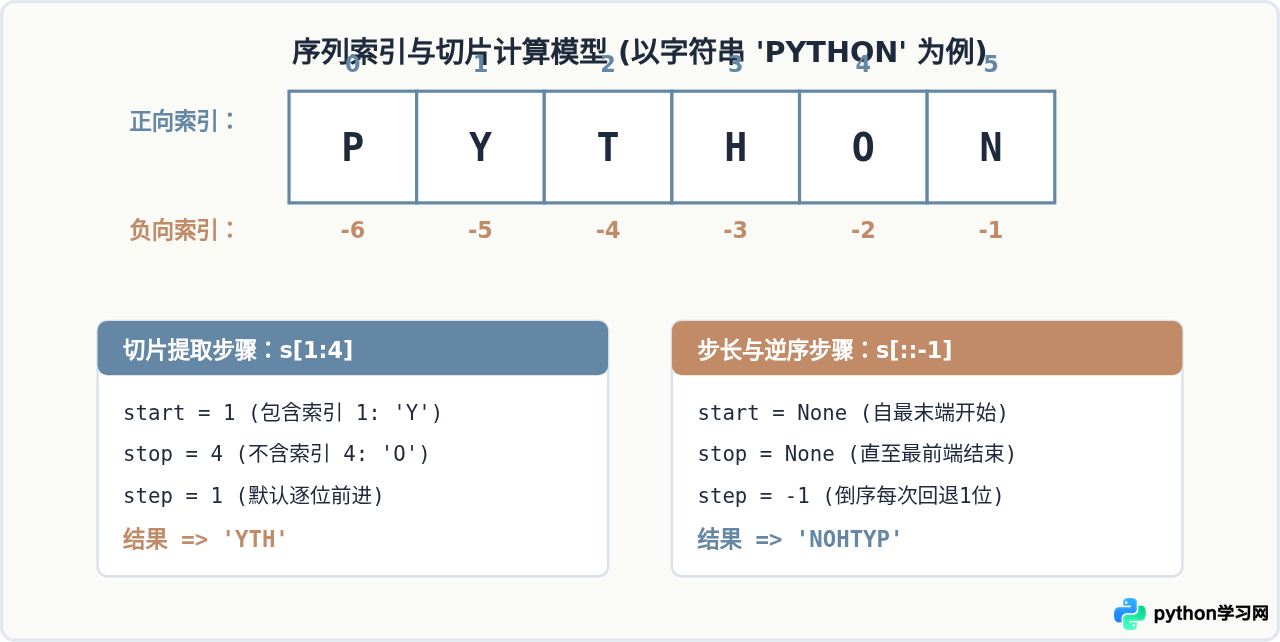
在 Python 序列中,正向索引从 0 开始,表示从头部依次向右计数;负向索引从 -1 开始,表示从末尾倒数第一个元素向左计数。如果访问超出 [-len, len - 1] 范围的索引,解释器将立即抛出 IndexError。
2. 切片语法规范
切片的基本语法为 s[start:stop:step],其核心规则如下:
- 左闭右开区间:截取结果包含
start处的元素,但不包含stop处的元素。 - 默认缺省值:当
step > 0时,start缺省为0,stop缺省为序列长度len(s)。 - 步长控制:
step可以为负数,代表逆序提取,例如s[::-1]能够快速生成逆序切片。 - 容错特性:切片操作对于超出边界的范围不会抛出
IndexError,而是优雅地截断到实际边界。
三、五大核心内置序列详解
1. list(列表)
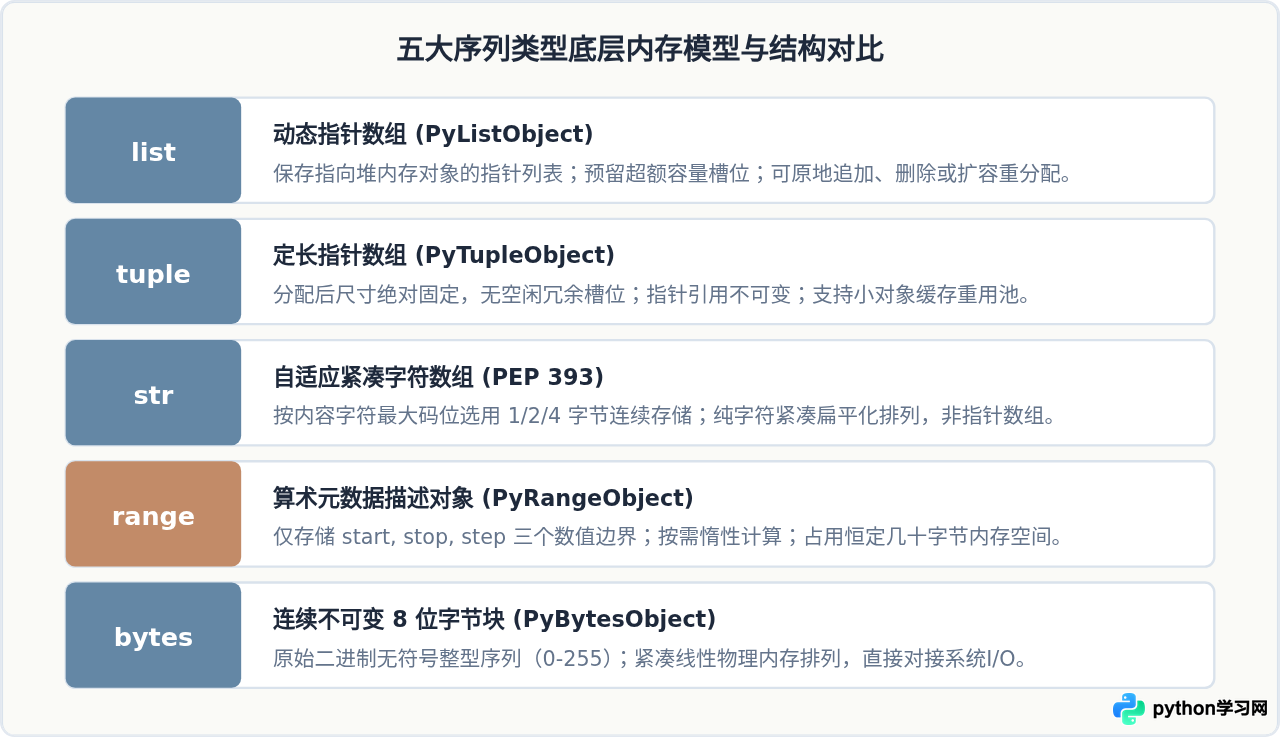
列表是 Python 中使用频率最高的可变序列。在底层实现上(以 CPython 为例),list 本质是一个连续动态对象指针数组(PyListObject)。数组中存放的并非对象实体本身,而是指向各个对象内存地址的指针。
- 动态扩容:当向列表追加元素触发容量上限时,CPython 会按照特定比例(预分配策略,约
1.125倍加常数)申请更大的连续内存块并搬移指针,从而保证单个append()的平摊时间复杂度为O(1)。 - 操作开销:尾部追加(
append)与弹出(pop())耗时均为O(1);而在头部或中间插入(insert(0, val))或删除,会导致后续所有指针在内存中发生批量移动,复杂度为O(n)。
# 列表声明与就地修改操作示例
fruits = ["apple", "banana", "orange"]
fruits.append("grape")       # 尾部快速追加
fruits[1] = "blueberry"      # 原地索引修改
print("列表结果:", fruits)   # 输出: 列表结果: ['apple', 'blueberry', 'orange', 'grape']
2. tuple(元组)
元组是固定长度的不可变序列。与列表类似,元组底层同样维护着对象指针数组,但一旦分配完成,其长度和内部指针地址便被锁定,不能增删改。
- 防御性与安全性:由于不可篡改,元组常用于函数返回多个参数、固定记录结构(如坐标点
(x, y))。 - 可哈希条件:如果元组内部包含的所有元素均为不可变类型,则该元组自身是可哈希的(Hashable),能够直接作为字典的
key或集合set的成员。若元组内含有列表等可变对象,则不可哈希。 - 内存优化:元组没有动态扩容的额外空闲槽位,内存开销较列表更为紧凑;且 CPython 内部对小元组实现了对象缓存池机制,回收与分配性能极高。
# 元组的使用与哈希特性
point = (10, 20)
location_map = {point: "Origin_Station"}  # 元组作为字典键合法
print("查表结果:", location_map[(10, 20)])  # 输出: 查表结果: Origin_Station
3. str(字符串)
字符串在 Python 中是存储 Unicode 字符 的不可变序列。在 Python 3 中,所有文本字符串均采用 Unicode 标准,底层由 PEP 393(灵活字符串表示法 Flexible String Representation)驱动。
- 内部存储自适应:根据字符串所包含字符的最大码位,底层自动选用 1 字节(Latin-1)、2 字节(UCS-2)或 4 字节(UCS-4)连续字符数组存储。这既保证了
O(1)的按字符索引性能,又最大限度节约了 ASCII 字符串的内存开销。 - 不可变约束:不能通过
s[0] = 'a'修改字符。在循环中若频繁使用+拼接字符串,会导致反复分配新内存并复制原内容,产生O(n^2)性能陷阱;标准做法是收集列表后使用str.join()一次性合并。
# 字符串高效拼接范式
tokens = ["Python", "Sequence", "Guide"]
sentence = " - ".join(tokens)
print("拼接结果:", sentence)  # 输出: 拼接结果: Python - Sequence - Guide
4. range(范围对象)
range 代表一个不可变的等差整数序列,常见于 for 循环计数。许多初学者容易将 range 误认为生成器(generator)或迭代器,但它在类型系统上是完整的不可变序列对象。
- O(1) 恒定内存占用:无论
range(10)还是range(10**12),它在内存中仅仅保存三个数值属性:start、stop和step,不会预先在内存中展开任何整数列表。 - 支持序列操作:
range对象支持直接索引访问r[10]、长度获取len(r),以及in成员算术检测(通过数学公式(x - start) % step == 0判定),其时间复杂度全为O(1)。
# range 的序列特性验证
r = range(100, 1000, 5)
print("元素个数:", len(r))       # 快速计算长度: 180
print("索引第10项:", r[10])       # O(1) 访问: 150
print("快速数学判定:", 255 in r)  # O(1) 计算判定: True
5. bytes(字节序列)
bytes 是处理原始二进制数据的不可变序列,其内部元素为范围在 0 到 255 之间的单个 8 位无符号整数(byte)。在网络传输、文件读写(如图片、音视频)、加密解密和系统底层交互中,所有文本都必须编码(encode)为 bytes,二进制流则需解码(decode)为 str。
- 字面量表示:形如
b"hello",其中 ASCII 字符可直接字面呈现,非 ASCII 字符以\xHH形式转义。 - 整数索引行为:当对
bytes序列取单个索引时,返回的是对应的整数数值(0-255);而对其进行切片截取时,返回的仍然是bytes对象。若需要可变的二进制缓冲块,则应使用其可变同胞类型bytearray。
# bytes 与 str 的编解码交互
raw_data = b"Hello\x20Python"
print("首字节数值:", raw_data[0])         # 输出对应 ASCII 码整数: 72
print("切片对象:", raw_data[0:5])          # 输出切片 bytes: b'Hello'
text = raw_data.decode("utf-8")
print("解码文本:", text)                  # 输出: 解码文本: Hello Python
四、核心序列类型的全方位对比与技术选型
在实际工程开发中,合理选用序列类型不仅直接决定代码的执行效率与内存开销,还关系到数据流转的安全性与代码表达力。下表汇总了这五大序列的关键特征差异:
| 序列类型 | 可变性 | 存储元素类型 | 可哈希 (可做字典Key) | 内存占用特征 | 典型应用场景 |
|---|---|---|---|---|---|
| list | 可变 | 任意 Python 对象 | 否 | 动态预分配,有冗余槽位 | 动态集合、工作队列、元素频繁增删 |
| tuple | 不可变 | 任意 Python 对象 | 若全元素不可变则可哈希 | 定长紧凑,分配性能高 | 固定记录、函数多返回值、字典联合键 |
| str | 不可变 | Unicode 字符 | 是 | 紧凑自适应存储 (1/2/4字节) | 人类可读文本呈现、日志、格式化信息 |
| range | 不可变 | 等差整数 | 是 | O(1) 恒定极小内存 | 大跨度循环迭代、索引计数控制 |
| bytes | 不可变 | 8 位无符号整数 (0-255) | 是 | 紧凑二进制连续内存 | 网络协议封包、文件流传输、加解密 |
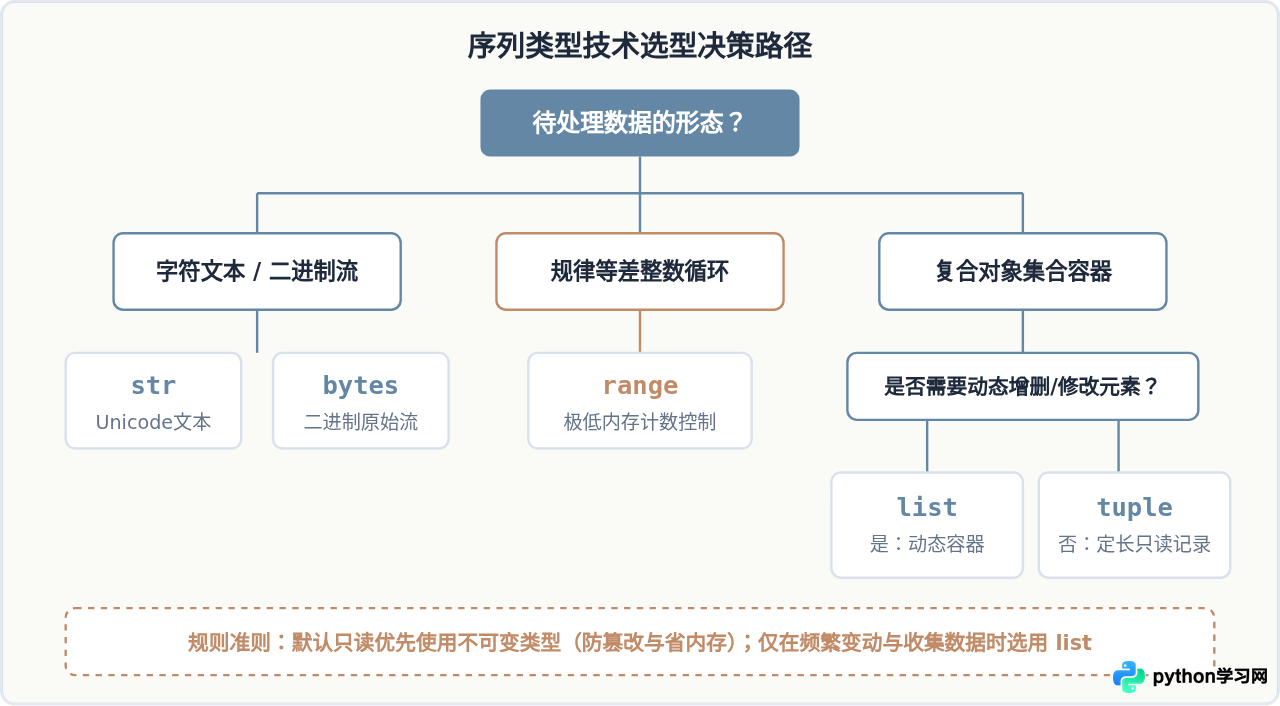
为了帮助开发者在实际编码中快速做出决策,可以参考以下结构化的技术选型决策图:
五、常见误区与避坑指南
1. 误区一:元组不可变等于元组内所有内容不可变
元组的“不可变”指的是其持有的引用指针列表不可变,并不保证被引用对象本身不可变。如果元组中包含一个列表(如 t = (1, [2, 3])),虽然不能替换该位置的列表对象,但可以直接修改该列表内部的数据(t[1].append(4))。此时该元组由于包含了可变对象,无法计算哈希值,也不能作为字典的键。
2. 误区二:列表乘法引发的浅拷贝浅坑
使用 [[0] * 3] * 3 创建二维数组时,外层列表存储的实际上是同一个内层子列表的 3 次重复引用。当修改 matrix[0][0] = 1 时,所有行的首个元素都会同步变为 1。正确的构造方式应使用列表推导式:[[0] * 3 for _ in range(3)],确保每次迭代创建独立的内存对象。
3. 误区三:混淆 str 与 bytes 的操作边界
在 Python 3 中,文本(str)与原始字节(bytes)具有严格的类型边界,两者无法直接隐式拼接或使用 == 返回 True。网络请求接收到的始终是 bytes,在展示或正则匹配前必须显式指定字符编码(如 utf-8)调用 decode();写入文件或向外发送时必须显式调用 encode()。
实战要点:切勿在循环中使用 + 运算符反复拼接 str 或 bytes,这会引发不可忽视的频繁内存分配与拷贝;对于字符序列优先使用 "".join(),对于字节序列优先使用 b"".join() 或 bytearray 缓冲区。
总结
Python 的序列类型体系在一致性与专门化之间取得了优秀平衡。通过遵循统一的序列协议,list、tuple、str、range 和 bytes 都能自然融入 for 循环、切片和解构赋值等 Pythonic 语法中;而在底层设计上,它们针对动态扩展、定长只读、多语言字符紧凑表达、大范围常数级内存以及原始二进制交互等不同场景进行了深度优化。理解其可变性差异、内存模型与算法复杂度,是编写健壮、高效 Python 程序的核心功底。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









