

python函数递归栈溢出怎么优化
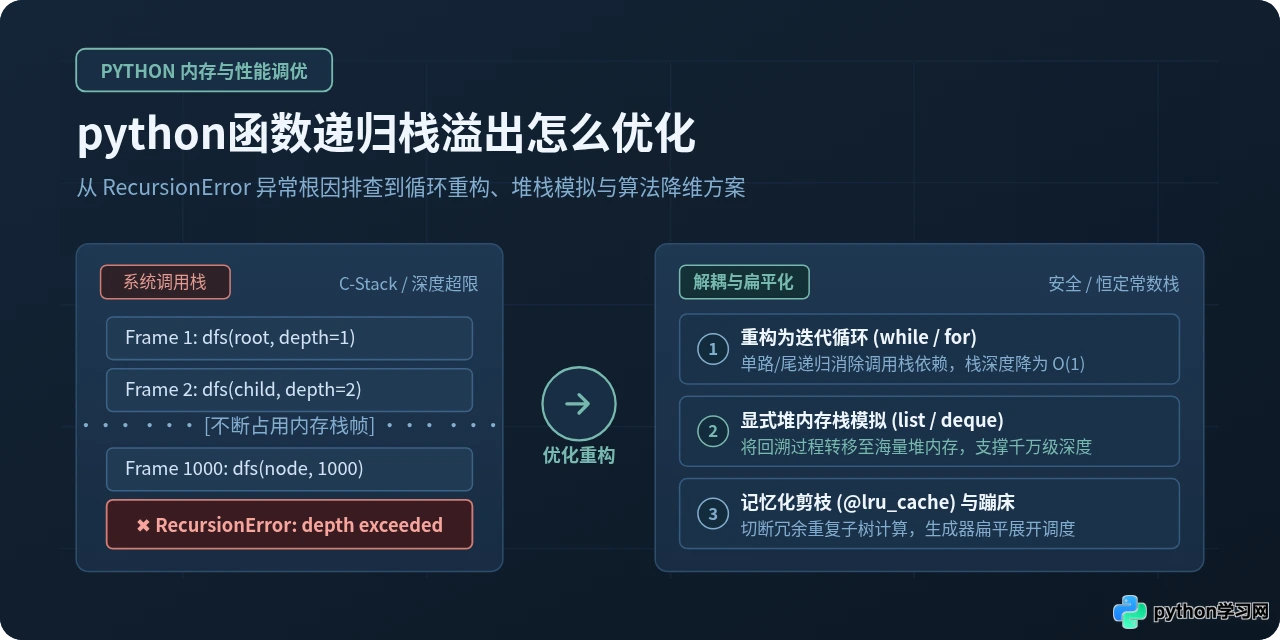
深入讲解 Python 函数递归栈溢出(RecursionError)的产生机理与系统性优化方案。涵盖将递归重构为迭代循环、使用堆内存显式模拟栈、记忆化剪枝、蹦床调度机制及调整递归深度上限的安全边界与避坑指南。
在编写处理深层嵌套数据(例如树形组织架构、图的深度搜索、长链表或多层 JSON 结构)的代码时,我们常常顺手写下一个递归函数。在本地针对少量测试数据运行时一切正常,但当业务数据规模扩大、调用层级突破 1000 层时,程序往往会直接中断,并抛出 RecursionError: maximum recursion depth exceeded in comparison 异常。
解决 Python 递归栈溢出的核心原则,在于彻底解除对底层系统调用栈(Call Stack)深度的依赖。最常见且根治问题的做法包括:将线性递归重构成 while / for 循环迭代、利用堆内存通过 list 或 collections.deque 显式模拟调用栈、借助 functools.lru_cache 实施记忆化剪枝避免无效分支展开,以及在特定场景下采用生成器蹦床机制(Trampoline)。至于调整 sys.setrecursionlimit(),通常只适合排查定位或已知深度上限时的临时验证,不能作为防范高并发与极端数据的通用根治手段。
一、为什么 Python 会出现递归栈溢出
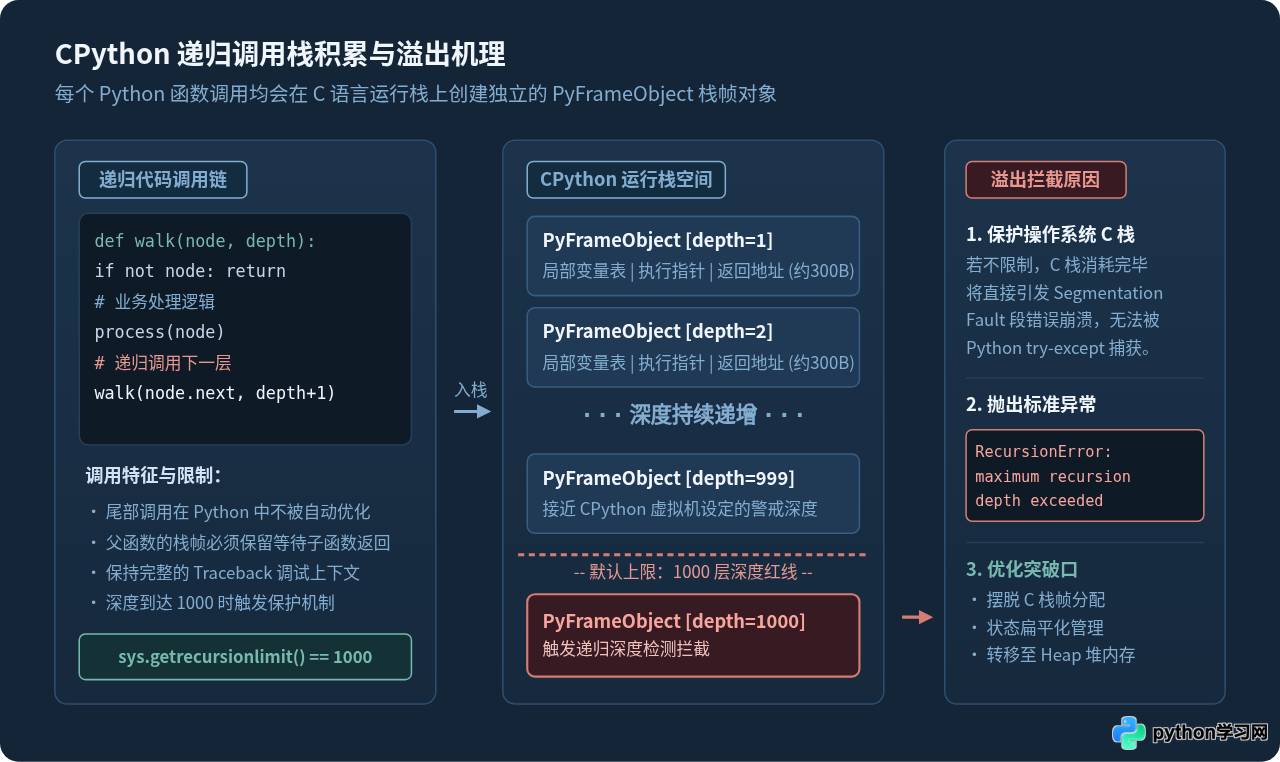
理解优化的关键在于明确 Python 在函数调用时底层的行为特征。在 CPython 实现中,每一次调用 Python 函数,虚拟机都会在操作系统分配给 Python 进程的 C 调用栈上创建一个新的 PyFrameObject 栈帧对象。这个栈帧不仅要保存函数返回地址,还需要维护函数内部的全部局部变量表、全局名字空间指针、计算栈以及执行字节码的指令指针,单个栈帧的内存开销通常在几百字节到上千字节不等。
为了防止死循环递归或者失控的深层调用直接耗尽操作系统的 C 语言物理栈,进而引发无法被 Python 语言层捕获的 Segmentation Fault(段错误崩溃闪退),CPython 在内部设立了一个主动防护门槛:通过 sys.getrecursionlimit() 查询,其默认上限通常为 1000 层。一旦递归调用的嵌套深度达到该数值,解释器会主动抛出 RecursionError。
此外,与其他一些函数式语言(例如 Scheme 或 Erlang)不同,Python 官方解释器默认不支持尾调用优化(Tail Call Optimization, TCO)。Python 之父 Guido van Rossum 曾明确阐述过这一设计哲学:隐式消除尾调用栈帧会破坏完整的堆栈追踪(Traceback)信息,导致异常排查和调试过程丢失真实的调用链路,且支持 TCO 并不会从根本上提升非尾递归场景的通用性能。因此在 Python 中,即便代码写成了标准的尾递归形式,解释器依然会逐层为每个调用分配栈帧,无法自动规避溢出。
二、优化方案一:转换为循环迭代(消除调用栈依赖)
对于单路递归、尾递归或简单的线性递推问题,将递归重构为基于 while 或 for 的扁平循环是最直接、最高效的优化手段。循环只在当前函数的单一栈帧内重复更新局部变量,无论迭代执行十万次还是千万次,其调用栈空间复杂度始终恒定为 O(1)。
1. 典型场景:从线性递归到迭代累加
以下面计算链表长度或单链累加的代码为例。当传入长度为 2000 的链表时,递归版本必定崩溃:
# 优化前:递归实现(当链表深度超过 1000 时崩溃)
def sum_linked_list_recursive(node):
    if node is None:
        return 0
    return node.value + sum_linked_list_recursive(node.next)
通过引入累加变量并用 while 循环推进游标指针,可以将其平滑转换为无栈开销的迭代结构:
# 优化后:迭代实现(时间复杂度 O(N),栈空间复杂度 O(1))
def sum_linked_list_iterative(head):
    total = 0
    current = head
    while current is not None:
        total += current.value
        current = current.next
    return total
2. 累加器模式(Accumulator)改写
如果原本的递归函数带有某种累加状态,改写时只需要将原函数入参中的初始状态提炼为循环体外的局部变量,每次循环更新该变量,直到满足退出条件(原 Base Case)后直接返回。
只要函数在深入调用时不需要在返回后根据子调用的返回值再做额外后序计算,或者该计算满足结合律能够边遍历边累加,就应当优先重构成循环迭代。
三、优化方案二:使用堆内存显式栈模拟递归(解决复杂分支与回溯)
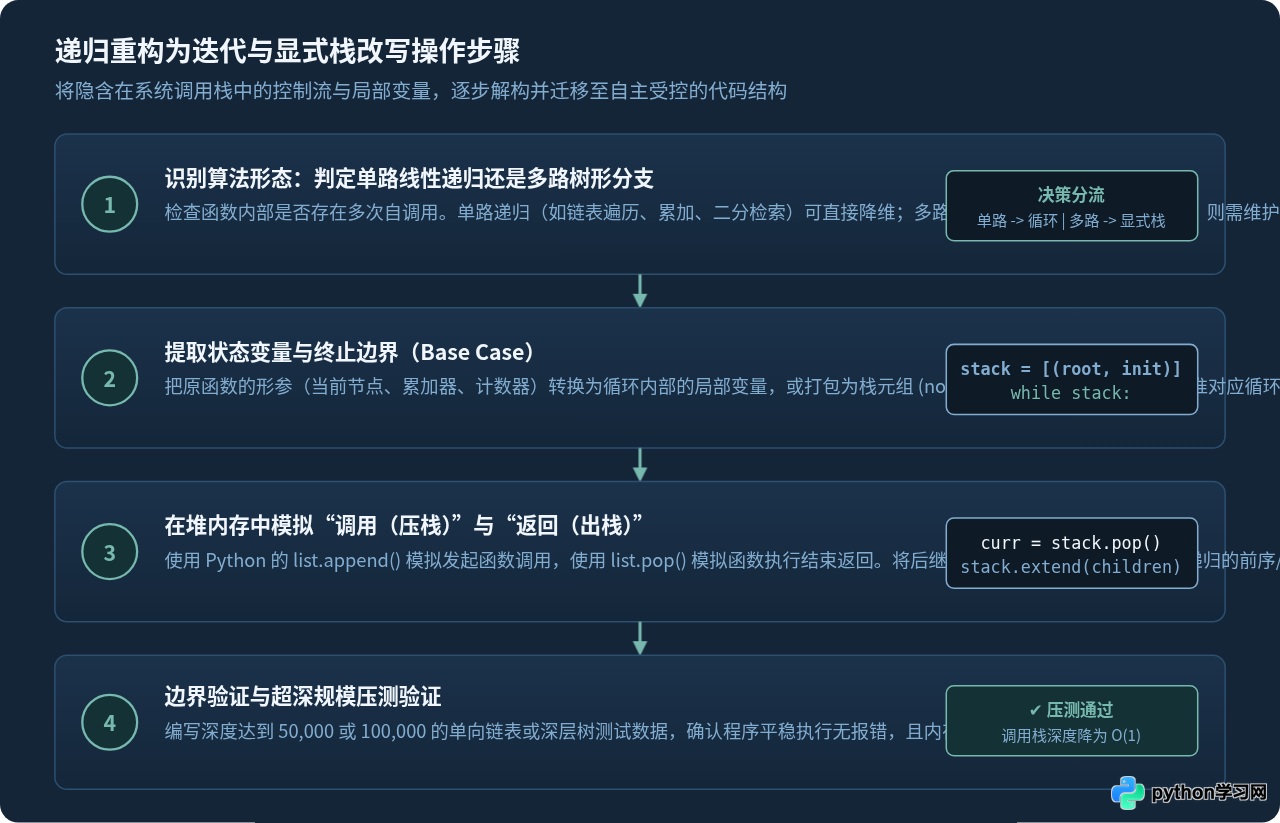
并不是所有的递归都能简单地写成一个单层循环。在多叉树深度优先搜索(DFS)、语法抽象语法树(AST)分析、带回溯的图路径搜索等场景中,一个节点可能拥有多个子分支,递归不仅承担计算功能,还隐式记录了“当前分支处理完毕后,返回父节点继续处理其他兄弟分支”的回溯状态。
对于这种多路递归,优化思路是:使用 Python 普通的列表(list)在堆内存(Heap)中模拟调用栈。操作系统的 C 栈容量通常受到线程栈大小限制(一般仅几 MB),而 Python 进程的堆内存则取决于系统的可用物理内存与虚拟内存(通常有数 GB 甚至更多)。通过 list.append() 模拟入栈,通过 list.pop() 模拟出栈,彻底规避了 C 栈溢出风险。
实战示例:多叉树前序遍历与节点处理
假设我们需要遍历一个深度可达数万层的树形组织结构并收集节点数据:
class TreeNode:
    def __init__(self, val, children=None):
        self.val = val
        self.children = children if children is not None else []

# 优化前:递归 DFS(树深度达 1000 层以上时抛出 RecursionError)
def traverse_tree_recursive(root, result=None):
    if result is None:
        result = []
    if not root:
        return result
    result.append(root.val)
    for child in root.children:
        traverse_tree_recursive(child, result)
    return result

# 优化后:显式栈迭代 DFS(支持十万级甚至更高深度,完全不受 recursionlimit 限制)
def traverse_tree_explicit_stack(root):
    if not root:
        return []

    result = []
    # 在堆内存中初始化显式调用栈
    stack = [root]

    while stack:
        # 弹出栈顶节点,模拟子函数被唤醒执行
        current = stack.pop()
        result.append(current.val)

        # 将子节点逆序压入栈中,以保证出栈顺序与原递归前序遍历一致
        for child in reversed(current.children):
            stack.append(child)

    return result
在显式栈版本中,所有的节点引用都保存在普通的 Python 列表里,解释器在执行 while 循环时始终只占有当前函数的一个系统栈帧。即使树的单链深度达到 50,000 层,也仅仅是 stack 列表中暂存了 50,000 个对象的指针,内存占用不过数百 KB,运行平稳顺畅。
四、优化方案三:记忆化与剪枝(解决重叠子问题引发的调用激增)
有时递归引发栈溢出并非因为单纯的单链过长,而是因为算法存在指数级的重复递归调用,导致调用树极其庞大,进而过早触碰了深度警戒线。典型的例子是未经优化的斐波那契数列计算、背包问题搜索或动态规划的自顶向下拆解。
通过使用 Python 标准库 functools.lru_cache,可以自动缓存已计算子问题的返回值,避免对相同参数重复深入递归:
from functools import lru_cache

# 未优化前:fib(40) 调用次数超亿次,参数稍大即耗尽栈或耗费巨大时间
# 使用 lru_cache 增加记忆化:
@lru_cache(maxsize=None)
def fib_memoized(n):
    if n < 2:
        return n
return fib_memoized(n - 1) + fib_memoized(n - 2)@lru_cache 能够彻底消除分支重叠计算,但若直接调用 fib_memoized(2000),依然会因为线性展开链条长达 2000 层而抛出 RecursionError。因此针对高深度的动态规划问题,更健壮的优化方式是采用自底向上的迭代制表法(Tabulation):
def fib_bottom_up(n):
    if n < 2:
        return n
    a, b = 0, 1
    for _ in range(2, n + 1):
        a, b = b, a + b
    return b
五、优化方案四:生成器蹦床机制(Trampoline)
在某些严谨的算法实现或函数式编程风格中,直接将代码改写为显式栈可能会使原本直观的数学推导逻辑变得冗长。此时可以采用蹦床机制(Trampoline Pattern)。
蹦床的核心思想是:被调用的递归函数不再直接嵌套调用自身,而是返回一个包含“下一步计算指令”的轻量包装对象(Thunk 或生成器)。外层调度器运行在一个扁平的 while 循环中,每次接收该对象,执行一步计算,再接收下一步,像蹦床一样反复将执行控制权弹回循环层,从而将任意深度的调用压平到常数级栈深度中。
def trampoline(generator_func):
    """
    通用蹦床调度器:将产出生成器的伪递归展平成扁平循环
    """
    def wrapper(*args, **kwargs):
        gen = generator_func(*args, **kwargs)
        stack = [gen]
        result = None

        while stack:
            try:
                # 推进当前栈顶的生成器
                if result is None:
                    next_call = stack[-1].send(None)
                else:
                    next_call = stack[-1].send(result)
                    result = None

                # 如果 yield 返回了一个新的生成器,则压栈展开
                if hasattr(next_call, '__next__'):
                    stack.append(next_call)
                else:
                    result = next_call
            except StopIteration as e:
                # 当前层执行完毕,接收返回值并弹出当前层
                result = e.value
                stack.pop()

        return result
    return wrapper

# 使用示例:即使递归深度达到 50000 层也不会发生系统栈溢出
@trampoline
def deep_factorial(n, acc=1):
    if n <= 1:
        return acc
    # 通过 yield 挂起当前状态并将下一步委托给调度器
    return (yield deep_factorial(n - 1, acc * n))
蹦床模式的优势在于完美保留了递归书写的逻辑结构,同时具备循环运行的安全优势。其代价是在 Python 中由于生成器调度和对象包装会带来一定的额外运行耗时,因此适合对调用深度有极端要求且希望保留递归结构表达力的特定模块。
六、临时手段与注意事项:调整递归深度上限的风险
在面对 RecursionError 时,不少初学者会尝试直接在代码开头加入以下两行指令:
import sys
# 将默认递归深度上限由 1000 放大至 10000
sys.setrecursionlimit(10000)
我们需要明确界定这一操作的适用边界与潜在危险:
- 适用场景:输入数据深度已经确定在合理区间(例如最大层级在 1200 ~ 1500 左右,确认不会无节制增长),重构代码改动成本较高,此时小幅提升限制是可行的权宜之计。
- 核心风险(段错误致命崩溃):
sys.setrecursionlimit仅仅改变了 Python 解释器软件层面的计数器上限,并没有扩充操作系统分配给当前线程的 C 语言硬件执行栈大小。如果将上限盲目调大至100000,当真实的递归调用深入到一定程度时,物理 C 栈会被彻底耗尽,操作系统会立即发出SIGSEGV(Segmentation Fault)信号强行终止整个 Python 进程。这种崩溃是操作系统级别的,无法被任何try...except捕获,不会输出友好的 Python 堆栈日志,在线上服务中极具破坏性。 - 操作系统线程栈调优:如果确实必须使用超深递归,除了调用
sys.setrecursionlimit,还需要同步在子线程中通过threading.stack_size()调整栈分配大小,并在操作系统层面通过ulimit -s提升栈空间。但即便如此,这种方式依然远不如显式栈或迭代来得可靠与可控。
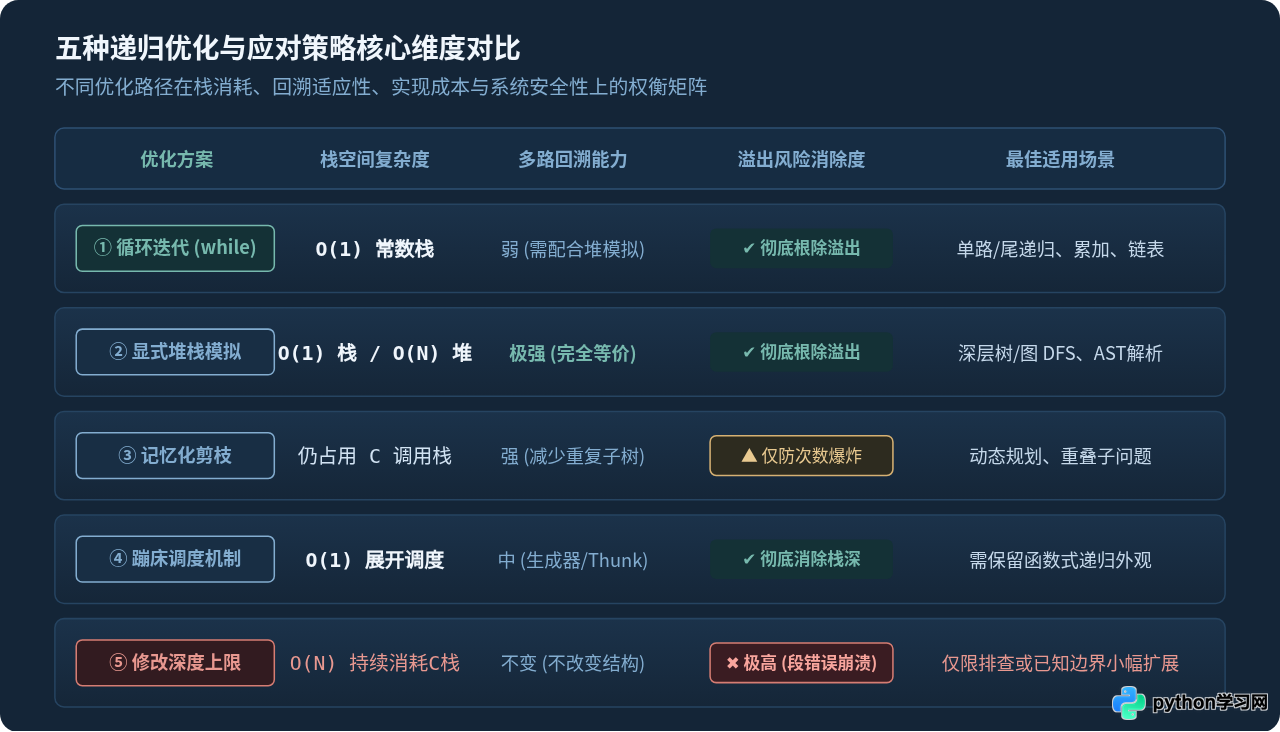
七、排查与选型决策指南
当在线上或开发环境中遭遇递归栈溢出报错时,建议按照以下排查与优化路线图循序渐进地解决:
- 第一步:排查基准终止条件(Base Case)
检查是否由于条件判断写错、浮点数精度偏差或死循环逻辑,导致递归永远无法命中终止分支。很多时候RecursionError是逻辑 Bug 造成的“假性深层”,修补退出条件即可解决。 - 第二步:分析递归拓扑形态
若属于单分支、尾递归或链表串行遍历,毫不犹豫地直接将其转换为while或for循环,这是零成本且性能最优的选择。 - 第三步:评估数据深度的不确定性
如果处理的是外部传入的任意多层 JSON 嵌套、XML DOM 树或用户生成的复杂结构,深度可能具有不可控的突发性,必须使用基于list的显式堆栈重写。显式栈消耗的是数以 GB 计的系统内存,哪怕遇到万级甚至数十万级深度也不会崩溃。 - 第四步:检查是否存在重叠计算
若函数内部存在多次相同的分支拆解,先通过@functools.lru_cache拦截冗余计算,再观察是否能演进为自底向上的迭代制表算法。
总结
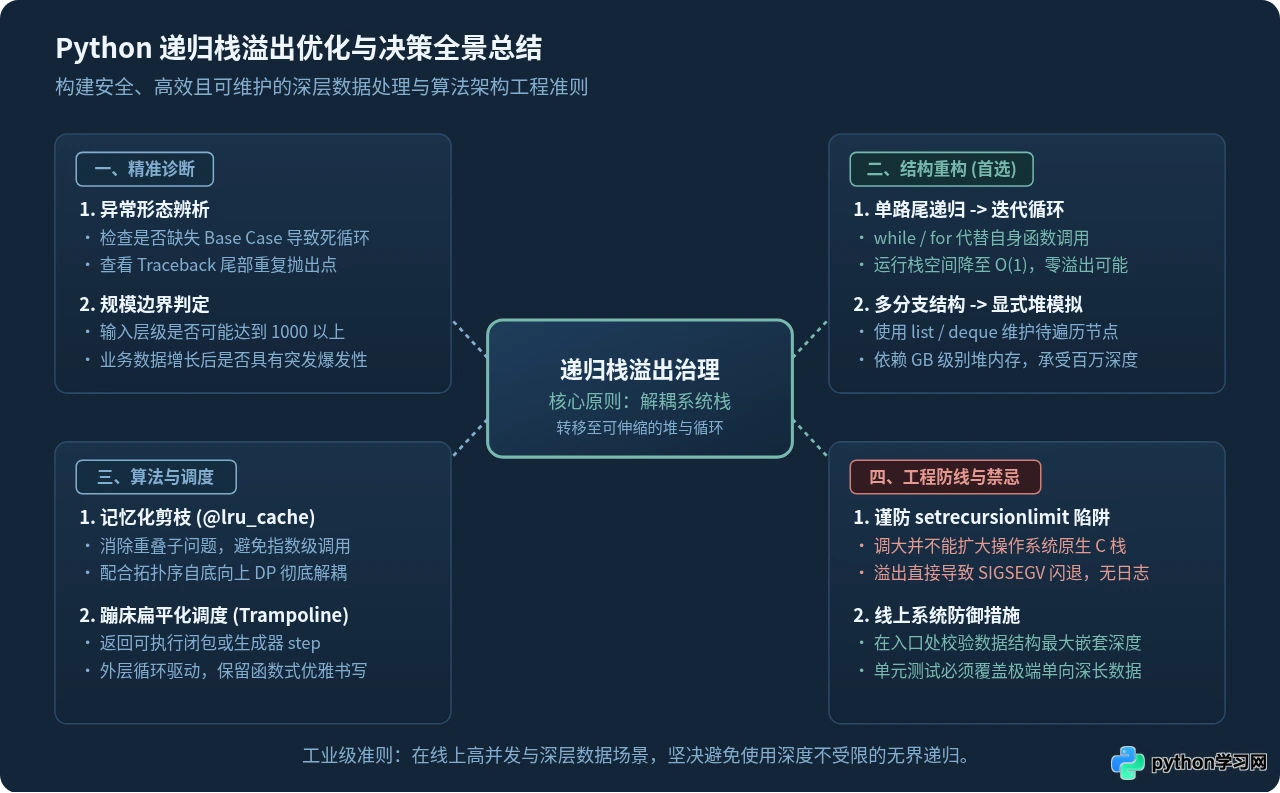
Python 解释器设置默认 1000 层递归限制不是性能缺陷,而是一道关键的安全防线。优化递归栈溢出的核心不在于“强行撬开防护门”(调高上限),而在于“顺应解释器的内存模型”,将深层状态从脆弱的系统调用栈逐步迁移到可控的循环结构或充足的堆内存空间中。掌握从循环迭代改写、显式堆模拟到记忆化剪枝的完整工具箱,能够确保我们编写的代码在面对海量与极端深层数据时始终兼具鲁棒性与高效性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









