

零基础怎么系统学Python?从环境搭建到独立项目的完整路径
面向零基础读者的系统化Python学习全流程指南。涵盖官方解释器安装与环境变量配置、VS Code高效开发流、核心语法与运行机制、虚拟环境隔离以及从需求分析到独立项目的完整工程化落地步骤。
很多零基础学习者在接触 Python 时,常常陷入“看视频觉得懂了,关掉教程连报错都不会看”的被动状态。根本原因在于把时间过度消耗在零碎语法的死记硬背上,缺乏从开发工具链、语言底层执行机制到完整工程拆解的系统化支撑。系统学 Python 的真正路径,是以“标准环境搭建”为起点,以“核心运行机制”为骨架,通过“虚拟环境隔离”养成工程习惯,最终以“完整独立小项目”实现能力的闭环检验。
一、开发环境的规范搭建与基础验证
学习任何编程语言,首要任务是在本地操作系统中搭建一套稳定、可验证的运行环境。依赖在线编辑器练习往往会隐藏文件读写、路径解析和依赖管理的真实问题,给后续做项目留下隐患。
1. 官方解释器下载与关键配置
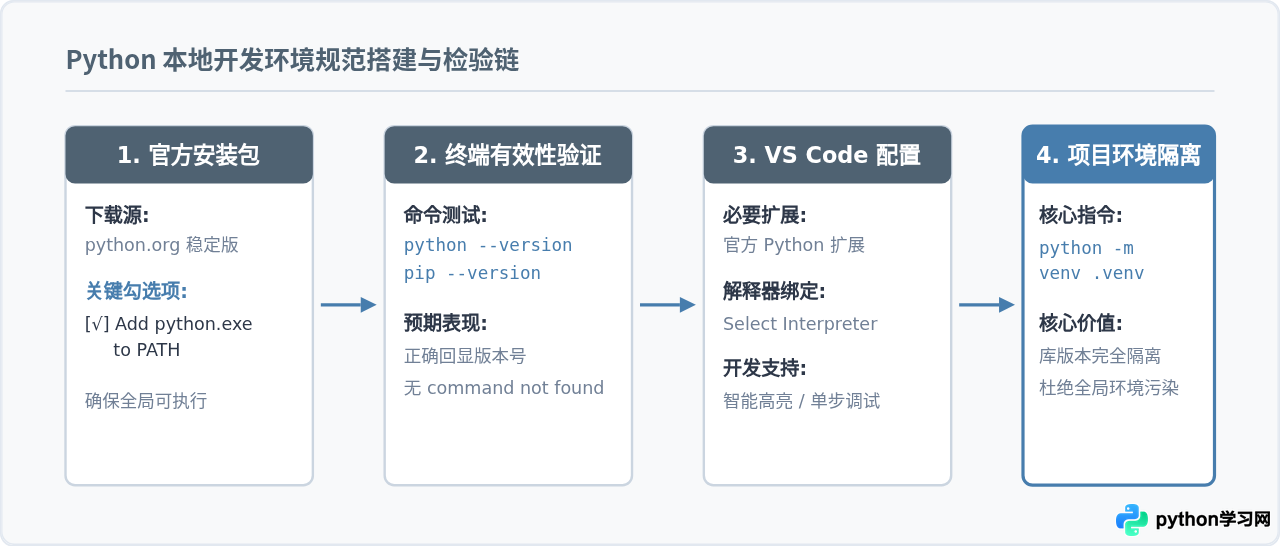
访问 Python 官方网站(python.org),下载对应操作系统的稳定版本(推荐 Python 3.10 或更高版本)。在 Windows 系统运行安装向导时,必须特别注意安装窗口底部的选项:务必勾选 “Add python.exe to PATH”。这一步的作用是将 Python 解释器和 pip 包管理工具的可执行文件路径注册到系统全局环境变量中,避免之后在终端提示“'python' 不是内部或外部命令”。在 macOS 系统中,若使用官方安装包安装,建议使用系统自带的终端验证预装路径。
2. 命令行验证安装状态
安装完成后,打开操作系统的命令行工具(Windows 的 PowerShell 或 CMD,macOS 的 Terminal),分别输入以下指令进行检测:
python --version
pip --versionpip 24.0 from C:\Users\Username\AppData\Local\Programs\Python\Python311\Lib\site-packages\pip (python 3.11)
若输出了具体的版本号信息,说明解释器与包管理工具已就绪。如果同时安装了多个版本,在某些系统下可能需要使用 python3 和 pip3 指令触发。
3. 代码编辑器选择与工作区绑定
对于初学者,轻量且生态完善的 Visual Studio Code(VS Code)是通用性极高的选择。安装 VS Code 之后,在扩展市场(Extensions)搜索并安装由 Microsoft 官方提供的 Python 插件包。在项目文件夹内新建 main.py 文件后,点击编辑器右下角的状态栏,或者使用快捷键 Ctrl+Shift+P(macOS 为 Cmd+Shift+P)输入 Python: Select Interpreter,选定刚才安装的 Python 解释器路径,即可获得语法高亮、自动补全与断点调试能力。
二、核心语法、运行机制与虚拟环境隔离
搭建好工具后,不能把 Python 当作纯粹的数学计算器来学,必须理解“代码文件是如何被机器执行的”,以及“为什么做项目绝不能把库直接装在全局系统里”。
1. 脚本执行与运行机制
当在终端执行 python main.py 时,操作系统唤醒 Python 解释器进程。解释器首先读取源代码文本,对其进行语法分析,并将其编译成中间形态的“字节码(Bytecode)”。如果代码目录拥有写入权限,这些字节码通常会被缓存到 __pycache__ 目录下的 .pyc 文件中。接着,Python 虚拟机(PVM)逐条解释并执行这些字节码指令,与底层操作系统交互输出结果。
# sample_flow.py 基础业务逻辑与输入输出
def process_user_records(records: list) -> dict:
    valid_count = 0
    total_score = 0
    for item in records:
        score = item.get("score", 0)
        if score >= 60:
            valid_count += 1
            total_score += score
    return {
        "valid_count": valid_count,
        "avg_score": total_score / valid_count if valid_count > 0 else 0.0
    }

data = [{"name": "张三", "score": 85}, {"name": "李四", "score": 52}]
summary = process_user_records(data)
print(f"合格人数: {summary['valid_count']}, 平均分: {summary['avg_score']:.1f}")2. 掌握“最小必要语法集合”
零基础最容易在复杂的面向对象高级特性(如元类、复杂装饰器)中迷失方向。在初期,只需透彻掌握以下四个基石结构:
- 基本容器类型:掌握
list(列表)的遍历与切片,dict(字典)的键值对检索与.get()安全取值。 - 流程控制:理解
if/elif/else条件分支和for ... in迭代循环,掌握break与continue的截断时机。 - 函数封装:明确入参、默认参数与
return返回值的关系,理解变量作用域(局部变量与全局变量)。 - 基础文件 I/O:使用
with open("file.txt", "r", encoding="utf-8") as f:上下文管理器安全读写文本,杜绝文件句柄泄漏。
3. 虚拟环境(venv)的隔离原理
很多初学者直接执行 pip install pandas,导致所有第三方库全部堆积在系统全局解释器的 site-packages 目录中。当项目 A 依赖特定库的低版本,而项目 B 依赖该库的高版本时,全局环境会直接崩溃产生冲突。因此,每一个独立项目都必须拥有独立的虚拟环境。
在当前项目根目录下创建并激活虚拟环境的操作如下:
# 1. 创建名为 .venv 的虚拟环境目录
python -m venv .venv

# 2. 激活虚拟环境
# Windows PowerShell 执行:
.venv\Scripts\Activate.ps1
# macOS / Linux 终端执行:
source .venv/bin/activate

# 3. 激活后命令行前缀会显示 (.venv),此时安装依赖完全受限于该项目
pip install requests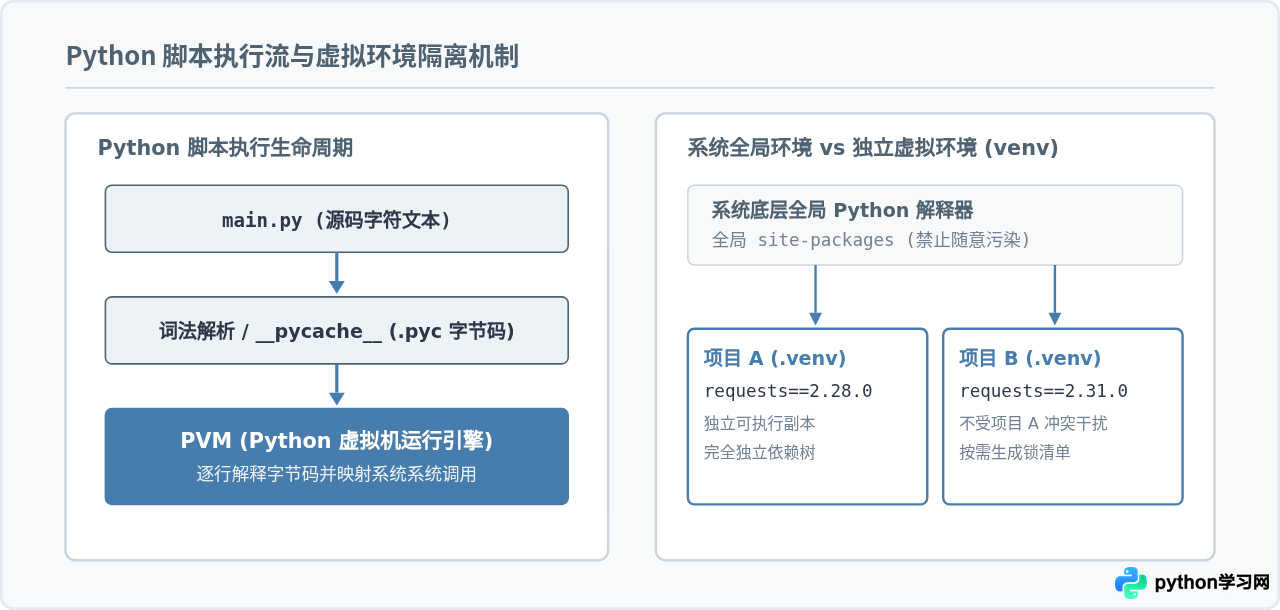
三、系统化推进的四阶段时间路径与避坑要点
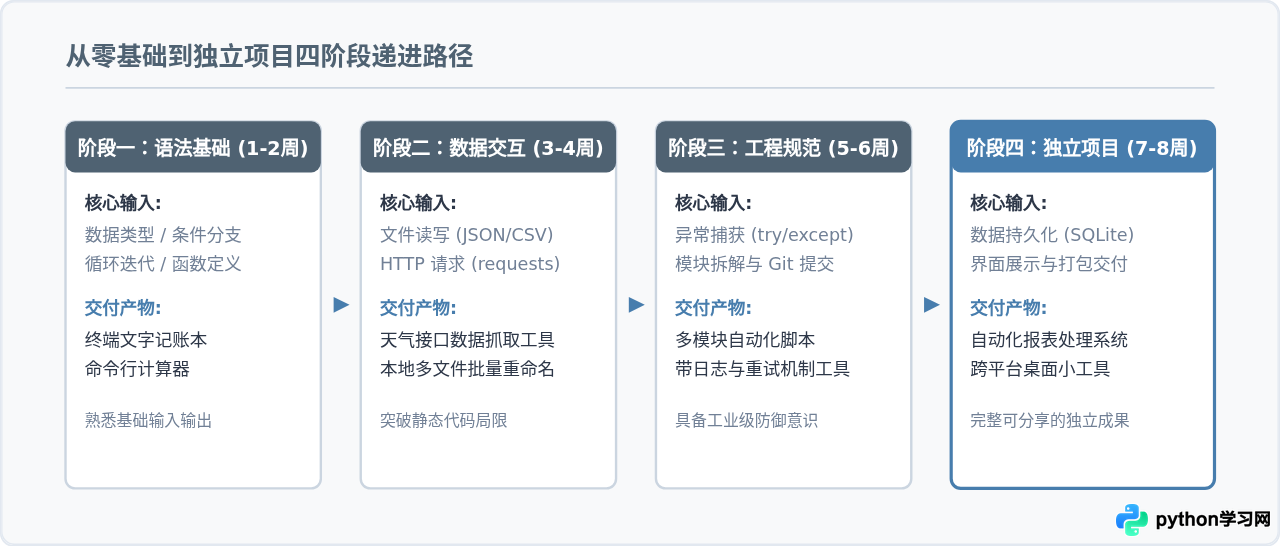
学习 Python 绝不能无序跳转。建立一个时间跨度约 8 周、目标明确的阶段演进模型,能保证在每个阶段都有可运行的成果输出。
关键认知提醒:代码报错不是失败,而是定位问题的精准线索。遇到错误时,直接阅读终端最后一行输出的异常类型(例如 KeyError、IndexError、TypeError),再根据调用栈(Traceback)指示的文件名和行号定位代码。切忌在没读懂报错信息前盲目修改代码。
四、独立项目的完整工程化落地步骤
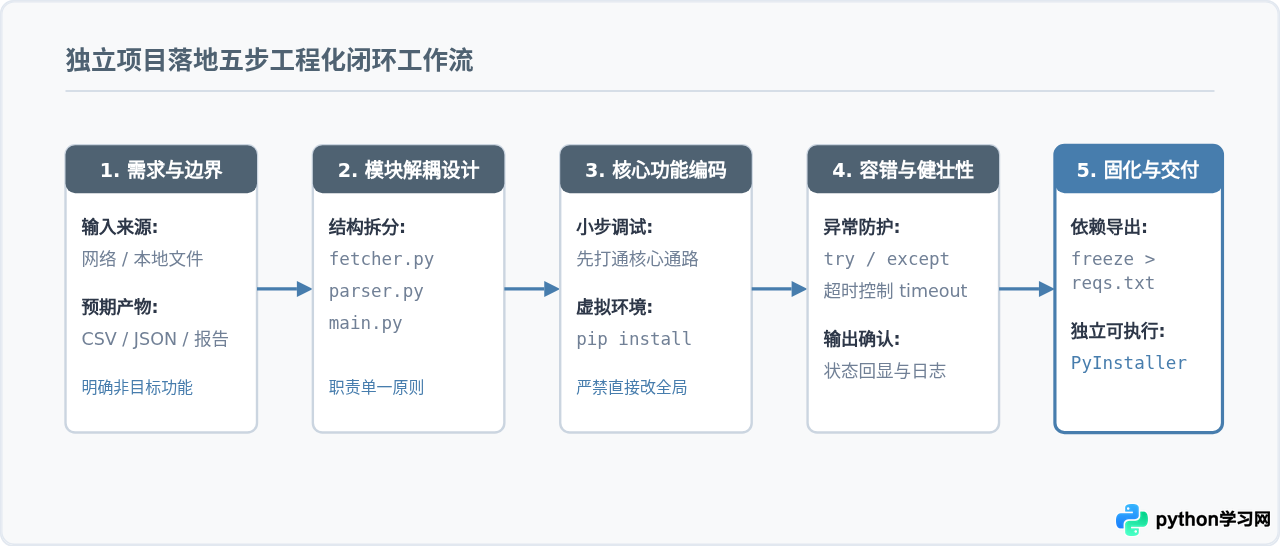
所谓“独立项目”,并非指代码量几万行的大型系统,而是指由个人从零梳理输入输出、组织目录结构、管理外部依赖,并具备容错保护的完整程序。以一个典型的实用项目——“网络数据抓取与本地结构化报表生成器”为例,展示标准的开发闭环。
1. 规范的项目目录骨架
避免把所有逻辑堆在一个 test.py 里。标准的小型独立项目应具备清晰的职责划分:
project_report/
│
├── .venv/                  # 虚拟环境目录(不提交至代码库)
├── config.py               # 基础常量与配置参数
├── fetcher.py              # 数据获取与网络通信模块
├── parser.py               # 核心清洗与聚合计算逻辑
├── main.py                 # 程序总入口与调度
├── requirements.txt        # 依赖清单
└── output/                 # 产物存储目录
2. 核心模块代码编写与防御性设计
在 fetcher.py 中编写获取数据的函数,明确处理网络超时或返回异常:
# fetcher.py
import requests

def fetch_api_payload(endpoint_url: str, timeout: int = 5) -> list:
    """安全获取远程接口数据,返回解析后的字典列表"""
    try:
        response = requests.get(endpoint_url, timeout=timeout)
        response.raise_for_status()  # 若状态码非 200 则抛出 HTTPError
        return response.json()
    except requests.exceptions.RequestException as err:
        print(f"[网络请求告警] 获取数据失败: {err}")
        return []
在 parser.py 中完成本地数据清洗和报表存储,采用内置的 csv 模块进行持久化,无需额外重量级依赖:
# parser.py
import csv
import os

def export_clean_csv(raw_records: list, target_path: str) -> bool:
    """提取核心字段并写入 CSV 报表"""
    if not raw_records:
        return False

    os.makedirs(os.path.dirname(target_path), exist_ok=True)
    fields = ["id", "title", "status"]

    with open(target_path, "w", encoding="utf-8-sig", newline="") as fp:
        writer = csv.DictWriter(fp, fieldnames=fields)
        writer.writeheader()
        for row in raw_records:
            writer.writerow({
                "id": row.get("id", ""),
                "title": row.get("title", "未命名"),
                "status": "已完成" if row.get("completed", False) else "待处理"
            })
    return True
在 main.py 中串联整个流程,统一管理生命周期与异常提示:
# main.py
import os
from fetcher import fetch_api_payload
from parser import export_clean_csv

TARGET_URL = "https://jsonplaceholder.typicode.com/todos"
OUTPUT_FILE = os.path.join("output", "task_report.csv")

def run_pipeline():
    print(">>> 启动数据自动化同步任务...")
    records = fetch_api_payload(TARGET_URL)
    if not records:
        print(">>> 未获取到有效数据,任务终止。")
        return

    success = export_clean_csv(records, OUTPUT_FILE)
    if success:
        print(f">>> 任务执行完毕,产物已成功生成至: {OUTPUT_FILE}")
    else:
        print(">>> 报表导出失败。")

if __name__ == "__main__":
    run_pipeline()
3. 依赖固化与交付打包
当项目在本地虚拟环境测试通过后,为了让其他人或在其他机器上运行,必须固化依赖清单:
pip freeze > requirements.txt接收者只需在新的虚拟环境中执行 pip install -r requirements.txt,即可在秒级内重建完全一致的依赖环境。如果需要交付给没有安装 Python 的非技术人员使用,可以使用 PyInstaller 执行单文件打包:
pip install pyinstaller
pyinstaller --onefile main.py
打包完成后,在生成的 dist/ 目录下即可得到一个双击即可运行的独立可执行文件(Windows 下为 .exe,macOS 下为二进制应用),至此完成独立项目的闭环交付。
五、关键问题与排查策略
在实际练习过程中,初学者常会遇到几个典型的认知误区与操作障碍,针对这些问题的清晰界定如下:
- IDE 选择策略:该用 PyCharm 还是 VS Code? 对于完全零基础的学习者,推荐使用 VS Code。PyCharm 功能强大但结构复杂(包含虚拟环境自动接管、内置终端与索引机制),新手常分不清报错来自代码本身还是来自 IDE 的后台索引;VS Code 保持了更贴近命令行底层的交互体验,能帮助建立更清晰的文件与路径概念。
- 关于 Python 2 与 Python 3 的版本边界: Python 2 早已于 2020 年停止所有官方维护与安全更新。所有现行教程、第三方库与生产实践均严格以 Python 3 为唯一标准,不需要在旧版本上消耗任何精力。
- 出现
ModuleNotFoundError: No module named 'xxx'的根本原因: 绝大多数情况下并非库没有下载,而是当前 VS Code 运行选定的解释器与终端中执行pip install的虚拟环境不一致。按Ctrl+Shift+P确认当前选择的解释器位于该项目的.venv/Scripts/python.exe(或.venv/bin/python),确保编辑器与命令行使用的是同一个隔离环境。
按照“安装验证环境变量 → 掌握核心容器与控制流 → 采用虚拟环境组织代码 → 完成包含网络交互、文件存储与异常防御的独立小工具”的路径推进,零基础学习者便能脱离对教程的依赖,建立自主构建工程项目的稳定能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









