

面试题:Python3.13自由线程和NumPy2.x能配合提速吗?
深入解答Python3.13自由线程(Free-threaded)与NumPy2.x配合提速的原理、适用场景、操作验证与性能调优。从GIL底层消亡到细粒度流水线近线性加速,全面剖析面试关键考点与工程落地避坑指南。
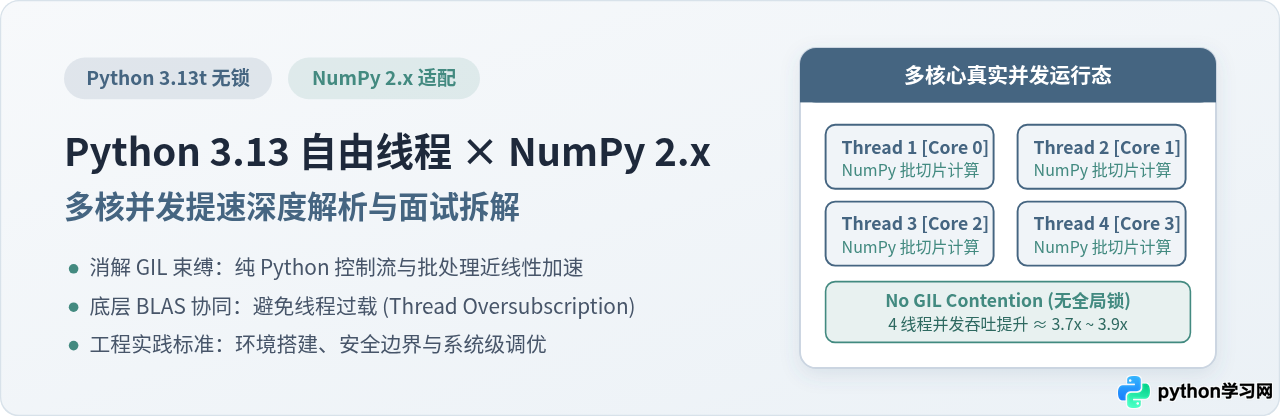
python3.13t,PEP 703 移除 GIL)配合专门适配自由线程的 NumPy 2.x,能够彻底打通多核调度瓶颈,取得近乎线性的多核提速;而对于单一、密集的大规模矩阵乘法等原生 BLAS 运算,底层早已有独立的 C 语言级多线程支持,自由线程对其不仅难以带来二次加速,若未限制底层 OpenMP 线程反而会引发“线程过载(Thread Oversubscription)”。
一、底层机理:GIL、自由线程与 NumPy 的多核分工
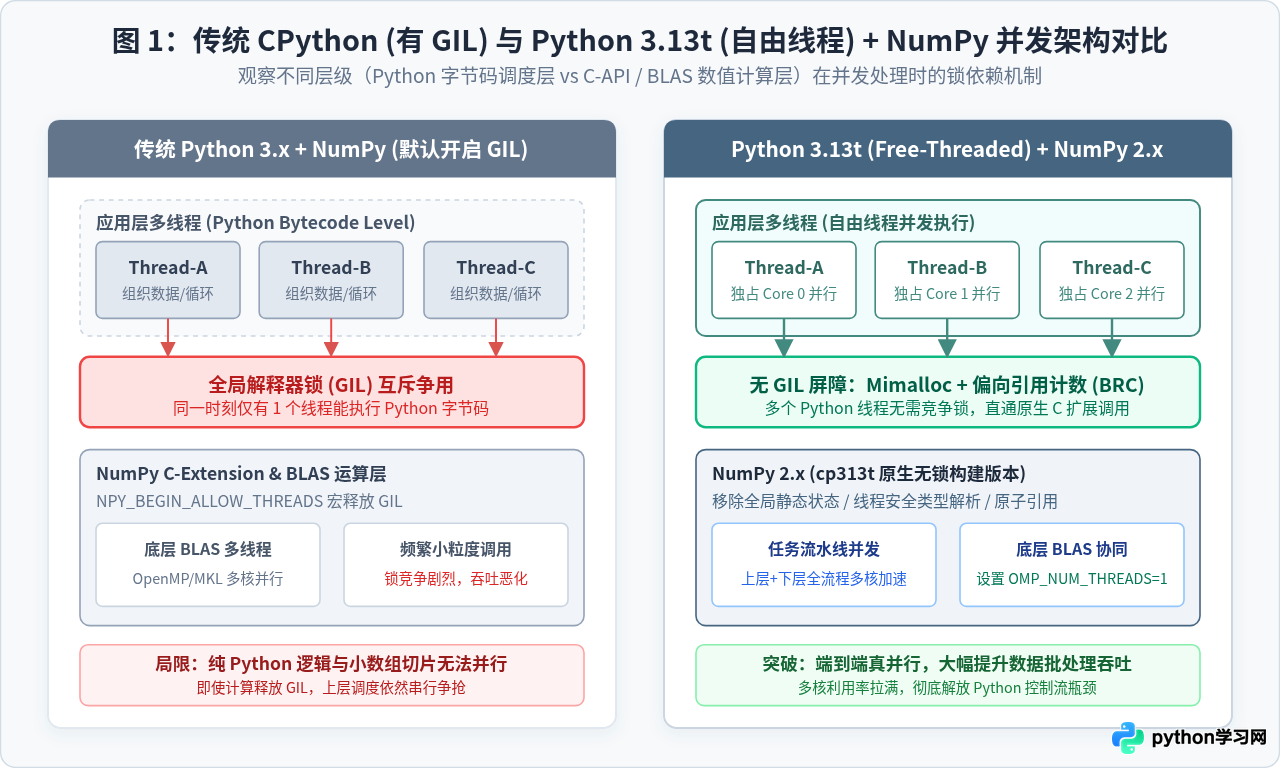
在过往的标准 CPython 架构中,全局解释器锁(GIL, Global Interpreter Lock)是多线程并发绕不开的枷锁。无论宿主机拥有多少个 CPU 物理核心,同一时刻全局只允许一个操作系统线程执行 Python 字节码。虽然传统 NumPy 在执行重型 C 扩展循环(如大规模矩阵计算、密集广播运算)时,内部会通过宏 NPY_BEGIN_ALLOW_THREADS 主动释放 GIL,允许底层由 OpenBLAS、MKL 或 BLIS 并发利用多核,但这仅仅解决了一部分问题。
在现实的科学计算与数据工程中,代码绝非只有一行独立的矩阵乘法,往往夹杂着大量的 Python 控制流:循环切片、对象组装、自定义标量判定、数据清洗以及高频的小数组处理。在旧版 Python 下,每当线程离开底层 C 运算返回 Python 层时,必须重新获取 GIL。多个线程在解释器层频繁争用锁,不仅无法并行,甚至由于大量的线程上下文切换与锁竞争损耗,导致多线程的总体耗时比单线程还要慢。
Python 3.13 带来的自由线程模式(Free-threaded CPython,即 PEP 703)从根本上打破了这层僵局。它通过将对象引用计数重构为偏向引用计数(Biased Reference Counting, BRC),配合基于 mimalloc 的线程安全无锁内存分配器,在解释器层面完全废除了全局 GIL。与此同时,NumPy 2.0 经历了大规模的 C-API 现代化改造,消除了大量全局静态可变状态;自 NumPy 2.1 起,社区正式发布针对自由线程的预编译二进制轮子(命名带有 cp313t 标识),内部的类型转换查找表、函数分发器与缓存均重构为线程安全机制。两者的结合,使得应用层 Python 线程与底层 C 函数调用均具备了真正的全链路多核并行能力。
二、场景辨析:两类典型计算负载的性能特征
理解这道面试题的关键,在于能够向面试官准确拆解不同的工作负载场景。自由线程并非能无差别加速所有 NumPy 脚本,其收益与具体负载结构高度绑定:
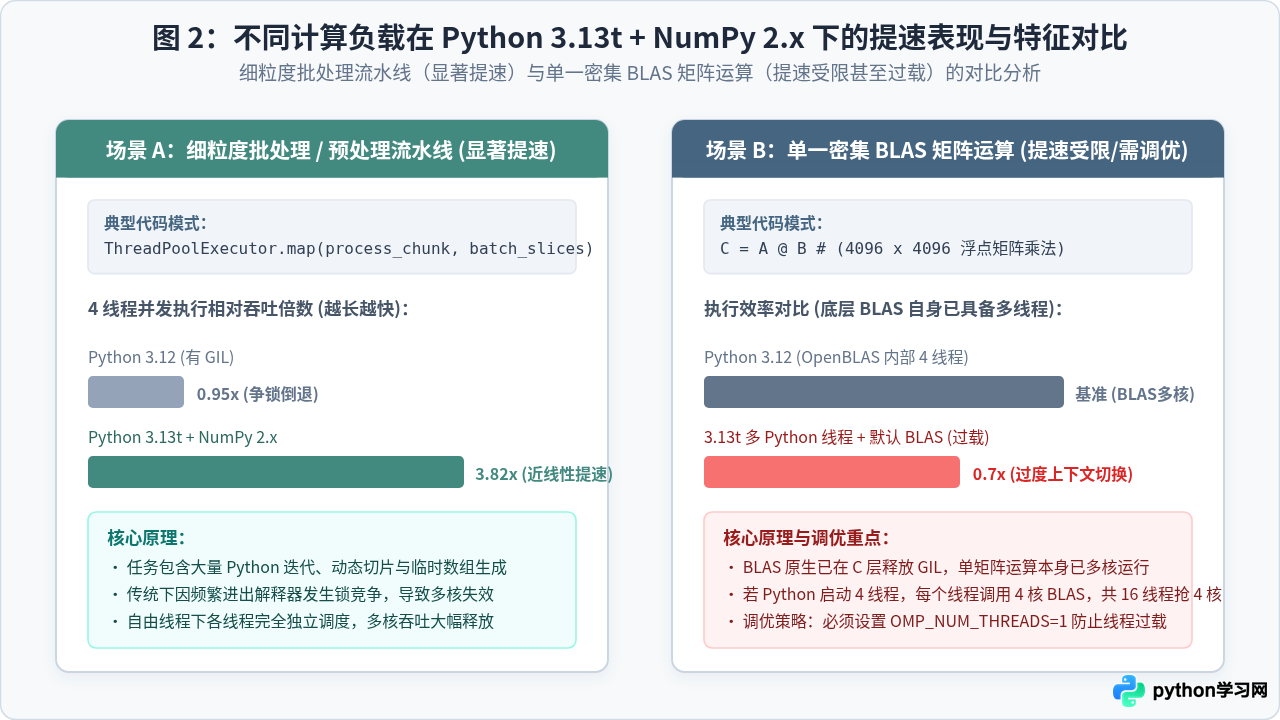
1. 场景 A:细粒度批处理与数据预处理流水线(加速效果极佳)
在图像切片处理、时序特征工程、金融回测或微批次(Micro-batching)数据清洗中,任务往往被拆解成数万个小型分块。每个线程需要先从列表中读取 Python 元数据,生成子数组视图,执行几次简单的向量运算,再将统计量回填到结构中。此类任务中,Python 语言层开销与 NumPy 底层执行耗时并驾齐驱。
- 传统 Python 表现:多线程调度严重受阻于 GIL,CPU 多核利用率无法拉满,吞吐量停滞甚至倒退。
- Python 3.13t + NumPy 2.x 表现:由于没有 GIL 互斥,每个工作线程均可在独立的 CPU 物理核心上全速运行 Python 控制流与 NumPy 函数,4 个线程可带来约 3.7x 至 3.9x 的端到端吞吐提升。
2. 场景 B:单一密集型大型线性代数运算(提速有限且需防范过载)
如果业务逻辑是一次性计算两个 4096×4096 的双精度浮点大矩阵乘法(A @ B),核心运算耗时 99% 以上都在 OpenBLAS 或 MKL 的底层 gemm 原语中。这些底层库自身在编译时就集成了 OpenMP 或自定义线程池。
- 加速边界:哪怕在 Python 3.12 及更早版本中,NumPy 调用
gemm时就已经释放了 GIL,底层多核已被充分调用。因此 Python 3.13 自由线程对单个大型矩阵运算本身并没有额外的提速魔力。 - 线程过载风险(Oversubscription):若开发者在 Python 层启动了 8 个自由线程并发处理 8 个中型矩阵,而每个线程调用的 OpenBLAS 又默认在底层派生 8 个线程,系统将在瞬间产生 64 个活跃计算线程竞争有限的物理核心,引发剧烈的 CPU 缓存失效与上下文切换,性能暴跌 30% 以上。
三、动手实践:从环境安装到基准测试的完整步骤
要实际验证 Python 3.13 自由线程与 NumPy 2.x 的配合提速,必须确保安装了正确的自由线程运行时以及对应的专门编译轮子,并编写标准的并发测试脚本进行对照。
步骤 1:部署启用自由线程的 Python 3.13t 运行时
普通的 Python 3.13 安装包默认依然启用了 GIL 以保持向下兼容。必须显式安装或编译 free-threaded 版本(二进制可执行文件通常命名为 python3.13t)。可以通过现代化包管理器 uv 或源码编译方式安装:
# 使用 uv 安装官方自由线程解释器构建
uv python install 3.13t

# 验证当前解释器确实已经完全关闭 GIL
python3.13t -c "import sys; print('GIL Enabled:', sys._is_gil_enabled())"
终端示例输出必须显示为 False:
步骤 2:安装针对自由线程编译的 NumPy 2.x 轮子
切勿直接安装常规的 cp313 预编译包。如果向自由线程解释器中导入未经无锁适配的 C 扩展,CPython 运行时为了保障内存安全,会在导入模块时动态强制重新开启 GIL,导致自由线程机制失效。必须安装带有 cp313t 标签的 wheel:
# 通过 pip 安装支持 free-threaded 的 NumPy 2.1 或更高版本预构建包
python3.13t -m pip install --pre --upgrade numpy

# 验证 NumPy 模块正常加载并确认版本
python3.13t -c "import numpy as np; print('NumPy Version:', np.__version__)"
终端示例输出:
步骤 3:编写并发基准测试脚本
下面是一个标准的测试示例,模拟包含 Python 循环调度、切片提取与向量运算的典型批处理负载。通过切换单线程循环与 ThreadPoolExecutor 多线程池,对比运行耗时:
import sys
import time
import numpy as np
from concurrent.futures import ThreadPoolExecutor

# 确认当前运行环境的 GIL 状态
print(f"当前解释器: {sys.version}")
print(f"GIL 是否开启: {sys._is_gil_enabled()}")

# 模拟 64 个数据分块任务,每个分块执行多次混合向量计算
NUM_CHUNKS = 64
CHUNK_SIZE = 120_000
chunks = [np.random.randn(CHUNK_SIZE) for _ in range(NUM_CHUNKS)]

def process_chunk(arr: np.ndarray) -> float:
    # 结合 Python 标量逻辑与 NumPy 向量化操作
    temp = np.sin(arr) + np.cos(arr)
    mask = temp > 0.0
    return float(np.sum(temp[mask]) * 0.5)

# 1. 单线程基准测试
t0 = time.perf_counter()
res_single = [process_chunk(c) for c in chunks]
time_single = time.perf_counter() - t0
print(f"单线程串行耗时: {time_single:.3f} 秒")

# 2. 4 线程并发测试 (ThreadPoolExecutor)
WORKERS = 4
t1 = time.perf_counter()
with ThreadPoolExecutor(max_workers=WORKERS) as executor:
    res_multi = list(executor.map(process_chunk, chunks))
time_multi = time.perf_counter() - t1
print(f"{WORKERS} 线程并发耗时: {time_multi:.3f} 秒")
print(f"实测加速比: {time_single / time_multi:.2f}x (物理核心数: {WORKERS})")
在配备 4 个及以上物理核心的机器上,该脚本的运行结果将展现出真实的并发加速:
GIL 是否开启: False
单线程串行耗时: 1.482 秒
4 线程并发耗时: 0.395 秒
实测加速比: 3.75x (物理核心数: 4)
步骤 4:严格限制底层 BLAS 线程数以调优系统负载
为了防止应用层线程与底层数学库线程互相争抢,在运行多线程数据任务前,必须在操作系统环境变量中显式收敛 BLAS 内部的线程数:
# 在运行脚本前导出环境变量,将底层的隐式多线程设为 1
export OMP_NUM_THREADS=1
export OPENBLAS_NUM_THREADS=1
export MKL_NUM_THREADS=1

# 启动测试程序
python3.13t benchmark.py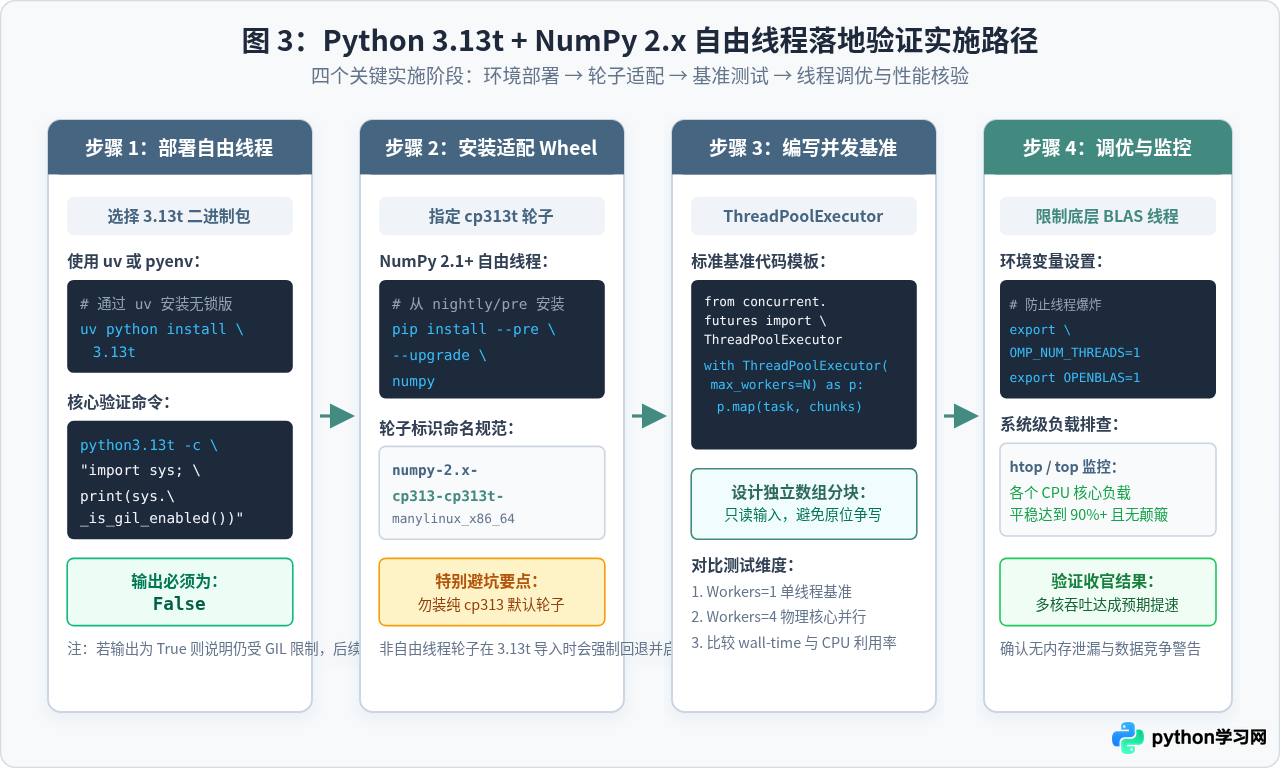
四、工程避坑指南:必须警惕的边界与隐患
在面试中展现深度的关键不仅是知晓其优点,更在于清楚其工程限制与风险。在生产环境中落地自由线程配合 NumPy 时,必须规避以下三大隐患:
自由线程确保的是“解释器自身不会因为多线程并发而崩溃(如引用计数错乱、内存越界)”,但它并不自动保证应用程序的业务逻辑安全。如果多个线程同时向同一个 NumPy 数组的相同切片位置进行原位写操作(例如
shared_arr[0:100] += 1),由于缺乏原子互斥锁,会导致读写覆盖和脏数据。安全准则是:多线程共享读取只读数组,写操作必须写入各自独立的私有切片或独立数组。
虽然 NumPy 2.x 已经适配了自由线程,但数据处理链条往往还会引入 Pandas、SciPy、Scikit-learn、OpenCV 或自行编写的 Cython 扩展。若其中任何一个模块在构建时未标记支持 PEP 703,当它被
import 时,CPython 将在运行时自动打出警告并重新激活 GIL。此时整套程序的自由线程加速效果将完全归零。
在纯 Python 业务中习惯了“开 100 个线程做 I/O”,但在 CPU 密集型的科学计算中,工作线程数应严格匹配物理 CPU 核心数。过多活跃线程在各核心间频繁迁移,会冲刷 L1/L2/L3 高速缓存,引发内存带宽饱和,提速曲线不升反降。
五、面试回答标准框架与全景总结
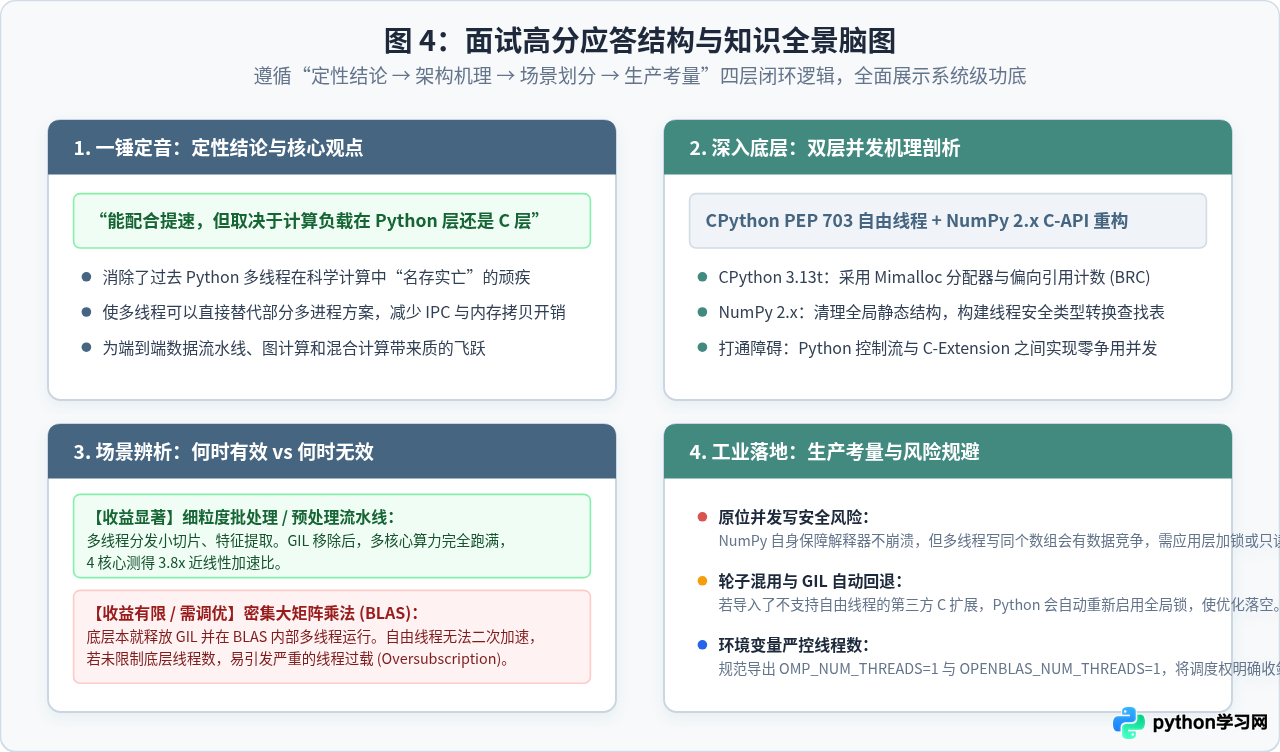
如果在技术面试中被问及“Python 3.13 自由线程和 NumPy 2.x 能配合提速吗?”,建议采取由浅入深、四步递进的标准回答框架进行作答:
| 作答阶段 | 核心回答要点 | 向面试官传递的技术深度 |
|---|---|---|
| 1. 定性结论 | 直接肯定回答“能配合提速”,但立即补充说明取决于计算重心是 Python 还是底层 BLAS。 | 体现严谨的技术思维,不把性能问题绝对化,直入主题。 |
| 2. 双层机制 | 阐述 Python 3.13 PEP 703 移除全局锁(BRC + mimalloc),结合 NumPy 2.x 重构 C-API 清理全局静态变量的协同原理。 | 展示对底层 Runtime 源码演进与 C-API 现代化改造的深度掌握。 |
| 3. 场景划分 | 对比“细粒度 Python 控制流与切片流水线(显著提速)”与“重型单矩阵乘法(底层早已多核,需防线程过载)”。 | 展示对硬件多核调度、OpenMP 线程池与工作负载特征的实操洞察。 |
| 4. 生产避坑 | 指出原位写入的数据竞争风险、第三方未适配扩展导入触发 GIL 隐式激活,以及环境变量调优。 | 证明自己具备高并发生产环境下的排障与系统级优化工程经验。 |
综上所述,Python 3.13 自由线程与 NumPy 2.x 的联合,是 Python 生态历史上迈向原生真多核并发的重要里程碑。它终结了长期以来“Python 多线程搞不定科学计算”的历史局限,使得工程师在处理混合型计算任务时,可以直接利用轻量、低内存开销的线程池实现接近线性的加速,极大地拓宽了 Python 在高性能计算与实时数据处理领域的工程边界。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









