

Python列表索引越界IndexError报错怎么解决
深入解析Python开发中常见的IndexError: list index out of range报错成因,从索引机制、报错排查流程、防御式编程方案及常见避坑场景展开,提供实用的解决办法与代码示例。
在 Python 开发过程中,IndexError: list index out of range 是最基础却也极为高频的运行时异常之一。该错误的字面含义为“列表索引超出范围”,本质是程序试图通过下标访问一个在内存列表中根本不存在的位置。解决这一报错的核心路径非常明确:首先借助异常堆栈精确定位报错的具体行号,其次打印或检查列表的实际长度与目标索引数值,最后通过前置边界判断、改用无下标迭代、安全切片或异常捕获等防御手段,确保代码在任何数据输入下都不会触发越界访问。
一、为什么会发生 IndexError:Python 列表索引机制
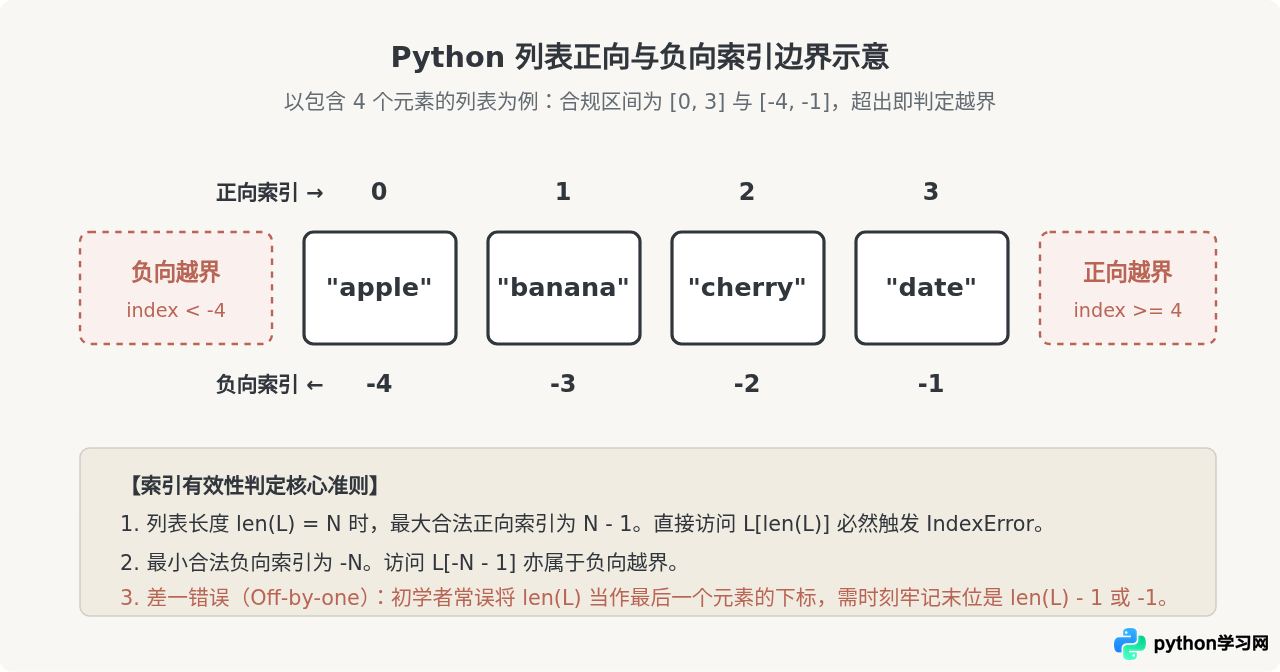
要彻底排除 IndexError,必须先理清 Python 列表下标的计算规则。Python 列表采用基于 0 的连续整数索引机制。对于一个包含 N 个元素的非空列表:
- 正向索引:范围严格限定在
0到N - 1之间。首个元素索引为0,末尾元素索引为N - 1。 - 负向索引:范围限定在
-1到-N之间。最后一个元素索引为-1,首个元素索引为-N。
只要请求的索引值小于 -N 或者大于等于 N,解释器就无法在该内存段寻址,从而抛出 IndexError。尤其需要注意,如果列表本身为空(长度 N = 0),那么任何索引访问(包括 [0] 和 [-1])都会瞬间抛出 IndexError。
二、遇到 IndexError 时的标准排查与定位步骤
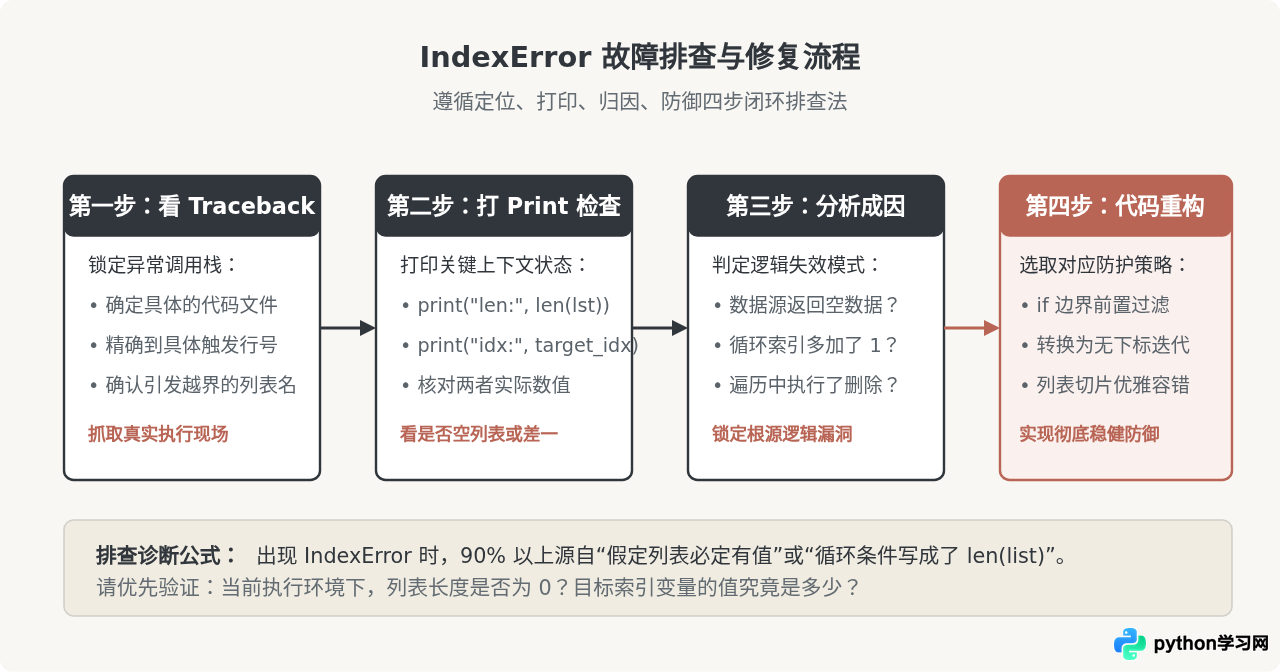
当终端或日志中出现 IndexError 时,不要盲目凭经验修改代码,而应按如下 4 个步骤进行系统化排查:
典型报错示例与现场还原
# 触发报错的代码片段
user_scores = [85, 92, 78]
print(user_scores[3])
运行后解释器输出如下回溯:
Traceback (most recent call last):
  File "main.py", line 2, in <module>
    print(user_scores[3])
IndexError: list index out of range
解读要点:回溯信息直接指明了发生错误的文件是 main.py,行号是第 2 行。列表中只有 3 个元素,最大索引是 2,而代码请求了 [3],直接越界。
三、解决 IndexError 的四种核心方案
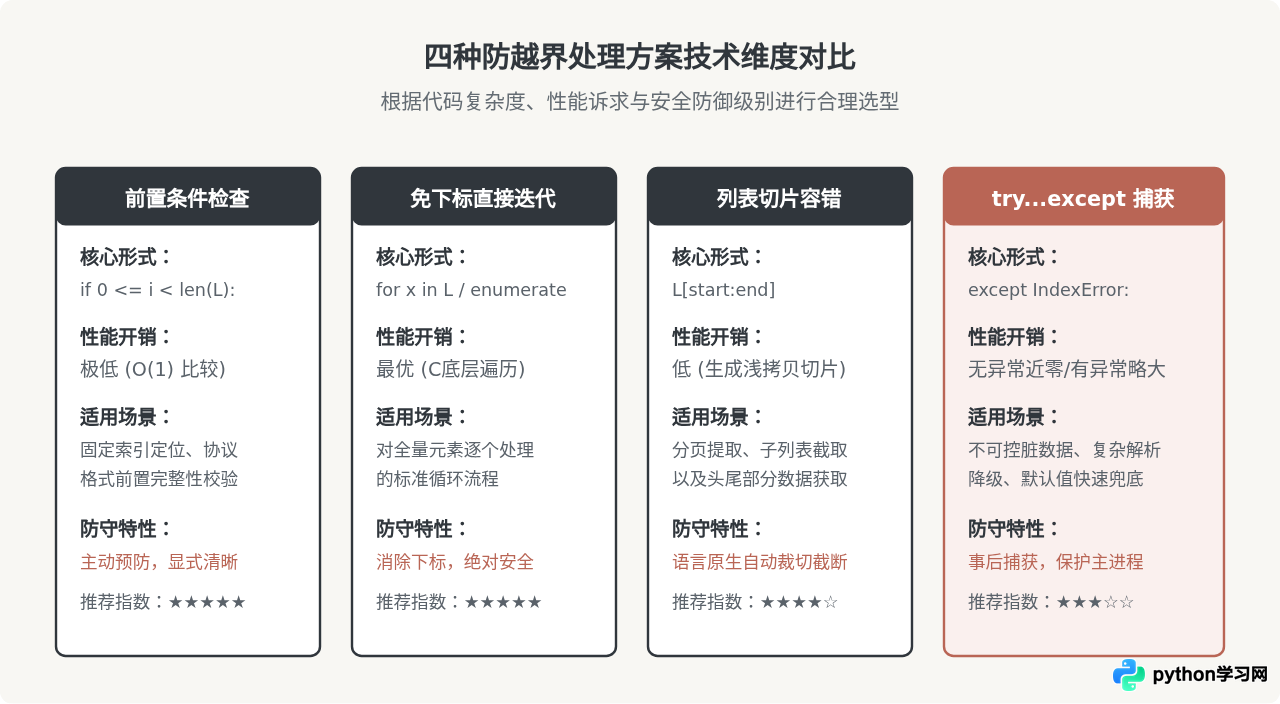
在明确了报错原因后,应根据具体业务场景选择最合理的处理手段,避免简单粗暴地随意包裹异常。
方案 1:前置长度检查与安全验证
如果业务逻辑本身就依赖指定索引(例如解析特定协议格式:第一个元素是指令,第二个元素是参数),最直观且开销最小的做法是先核对列表长度:
def get_command_param(commands, target_index):
    # 前置检查:确保列表存在且索引处于合法正向区间
    if commands and 0 <= target_index < len(commands):
        return commands[target_index]
    return None  # 或者返回自定义默认值

# 验证调用
params = ["START", "PORT_8080"]
print(get_command_param(params, 1))  # 正常输出 PORT_8080
print(get_command_param(params, 5))  # 返回 None,不抛出异常
方案 2:优先采用迭代器直接遍历(消除下标索引)
在 Python 中,初学者常带着 C/C++ 等语言的习惯使用 for i in range(len(my_list)),这种写法不仅繁琐,而且极易因偏移量计算错误引发 IndexError。Python 的首选写法是直接遍历对象,或者使用 enumerate():
fruits = ["苹果", "香蕉", "橙子"]

# 推荐写法 A:不需要索引时直接遍历内容
for fruit in fruits:
    print(fruit)

# 推荐写法 B:同时需要索引和元素时使用 enumerate
for index, fruit in enumerate(fruits):
    print(f"序号 {index}: {fruit}")
这种遍历方式完全由 Python 内部迭代协议驱动,在底层保证了不会越界,彻底消除由手动计算索引带来的隐患。
方案 3:利用列表切片(Slicing)天然防越界的特性
Python 列表的下标访问极其严格,超出即报错;但切片操作具有高度容错性。如果切片的起始或结束范围超出了列表边界,Python 不会抛出异常,而是自动截断并返回有效部分(若完全不在区间则返回空列表 []):
numbers = [10, 20, 30]

# 下标访问越界会直接崩溃:
# print(numbers[5])  # 报错 IndexError

# 切片访问越界则非常安全:
print(numbers[1:10])  # 输出 [20, 30]
print(numbers[5:6])   # 输出 []

# 技巧:安全获取指定位置单个元素(存在则取值,不存在给默认值)
def safe_index(lst, idx, default=None):
    sub = lst[idx:idx+1]
    return sub[0] if sub else default

print(safe_index(numbers, 0))  # 10
print(safe_index(numbers, 9))  # None
方案 4:使用 try...except 捕获异常并降级兜底
当列表来自外部动态输入、网络请求或文件解析,且越界属于偶尔发生但完全在预期内的特殊情况时,可以使用 try...except IndexError 进行捕获并优雅降级:
def parse_csv_row(row_cells):
    try:
        user_id = row_cells[0]
        user_name = row_cells[1]
        user_email = row_cells[2]
    except IndexError:
        # 数据列不全时的降级兜底逻辑
        user_email = "not_provided@domain.com"
return user_id, user_name, user_email注意:只有在确实可能出现偶发越界且有明确回退策略时才推荐使用 try...except。切勿在整个大型函数外随意套上一层 except IndexError: pass,这会掩盖真正的业务逻辑 Bug。
四、常见诱发 IndexError 的场景与避坑重构
场景 1:在循环遍历列表的同时执行删除操作
这是一个极具迷惑性的典型错误。当开发者试图在循环内部根据条件剔除元素时,如果直接用下标删除,会导致后续元素的索引向前移动,而循环计数器继续自增,从而引发 IndexError 或遗漏检查:
# 错误示例:边遍历边删除
items = [1, 2, 3, 4, 5]
for i in range(len(items)):
    if items[i] % 2 == 0:
del items[i] # 随着删除,len 变小,i 继续增大,必触发 IndexError正确解决方式:不要就地改变正在遍历的列表大小,而应通过列表推导式生成新列表,或者逆序遍历:
# 方案 A:列表推导式过滤(最清晰)
items = [1, 2, 3, 4, 5]
items = [x for x in items if x % 2 != 0]

# 方案 B:如果必须原地修改,采用逆序循环(倒序删除不会影响前面元素的下标)
items = [1, 2, 3, 4, 5]
for i in range(len(items) - 1, -1, -1):
    if items[i] % 2 == 0:
        del items[i]
场景 2:解析嵌套多维列表或 JSON 结构时的级联越界
在处理多维矩阵、爬虫抓取表格或解析外部 API 返回的多层数组时,经常会写出形如 data[0][1][2] 的链式调用。一旦中间层级返回了空列表 [],后续访问立刻报错:
# 脆弱的代码:假定每一层都有足够数据
def get_user_first_tag(data_matrix):
    return data_matrix[0][0]  # 若 data_matrix 为空,直接崩溃

# 健壮的重构:逐层校验解包
def get_user_first_tag_safe(data_matrix):
    if data_matrix and len(data_matrix) > 0:
        first_row = data_matrix[0]
        if first_row and len(first_row) > 0:
            return first_row[0]
    return "默认标签"
场景 3:试图用字典的 get 模式操作列表
字典提供了 dict.get(key, default) 方法来优雅避免 KeyError,但 Python 内置列表并没有内置的 list.get(index, default)。如果业务中确实有大量通过下标取值且经常越界的场景,建议封装一个通用的工具函数:
def safe_get(lst, index, default=None):
    """
    通用列表安全取值函数:
    同时支持正向索引与负向索引,越界时安全返回 default
    """
    if not isinstance(lst, list):
        return default
    if -len(lst) <= index < len(lst):
        return lst[index]
    return default

# 测试使用
records = ["A", "B", "C"]
print(safe_get(records, 1))    # 输出 'B'
print(safe_get(records, -1))   # 输出 'C'
print(safe_get(records, 10, "无记录"))   # 输出 '无记录'
print(safe_get(records, -5, "无记录"))   # 输出 '无记录'
五、防御式编程与总结清单
编写高质量 Python 代码的核心准则之一是:绝不假定外部输入的数据长度与结构恒定不变。针对列表访问,建立防御式编程习惯能够将越界异常彻底阻断在生产环境之外。
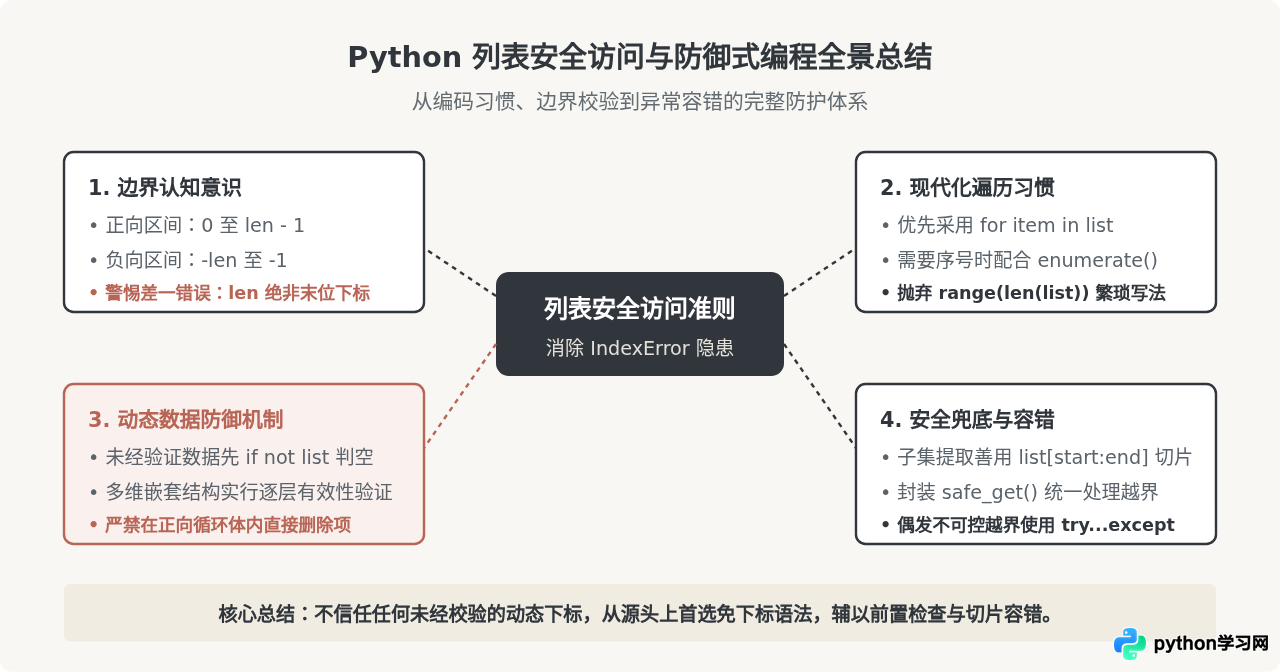
日常自查清单:
- 查长度:在写下
lst[idx]时,是否能 100% 确定0 <= idx < len(lst)?如果无法确定,务必补充if len(lst) > idx判断。 - 查首尾:取最后一个元素直接用
lst[-1],避免写出容易犯错的lst[len(lst) - 1]。 - 查空列表:任何可能接收外部动态数据的地方,必须先确认
if lst:列表不为空。 - 改习惯:在
for循环中,优先使用for item in lst或enumerate(lst),主动告别range(len(lst))。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









