

Python实现基础密码验证:检查长度与字符类型
本文详细介绍如何使用原生Python实现基础密码验证,涵盖密码长度范围校验与大小写字母、数字、特殊符号等字符类型的检查方法,并提供完整代码与对比分析。
实现密码验证的核心在于两项基础约束:其一是控制长度边界,防止过短易猜或过长溢出;其二是检查字符构成,确保大小写字母、数字及特殊符号达到安全门槛。在 Python 中,通过字符串内置方法结合单次循环遍历即可构建出清晰、轻量且易于维护的验证函数,既能给出布尔判定,又能明确告知用户未达标的具体原因。
一、长度范围检查的必要性与实现
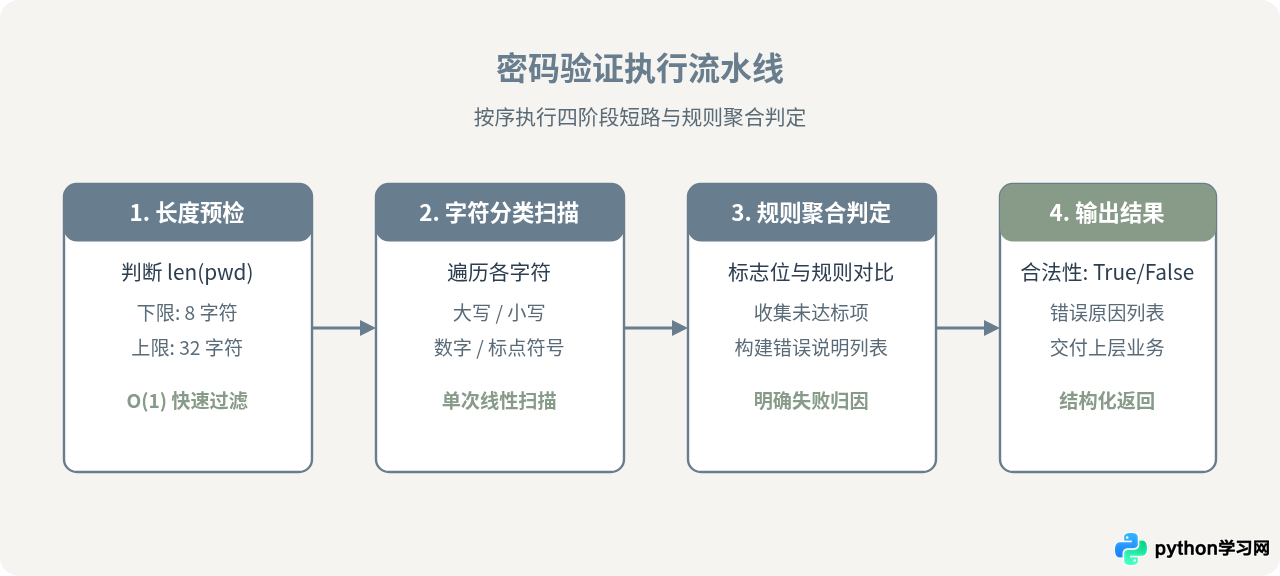
验证密码的第一步通常是检查其长度。限制长度不仅是为了保证密码具备最低的穷举复杂度,也是为了防止过长的输入造成哈希计算资源被恶意消耗(例如防止超长字符串引发拒绝服务风险)。
在 Python 中,通过内置的 len() 函数即可完成校验。由于 Python 的字符串对象在底层直接记录了长度属性,调用 len() 属于 O(1) 复杂度的即时操作。我们可以设置合理的默认区间(例如 8 到 32 个字符):
def check_length(password: str, min_len: int = 8, max_len: int = 32) -> bool:
    """检查密码长度是否在允许区间内"""
    return min_len <= len(password) <= max_len
将长度检查放在最前面有显著的性能优势。当用户输入的密码长度不足 8 位时,程序可以立即终止或直接记录该错误,省去后续对长字符串中每个字符进行分类判断的开销。
二、字符类型的判断方法与逻辑拆解
基础密码验证通常要求字符串同时包含以下四种基本字符类别:
- 大写字母(Uppercase):A 到 Z
- 小写字母(Lowercase):a 到 z
- 数字(Digits):0 到 9
- 特殊符号(Punctuation/Symbols):如 !@#$%^&*()_+-=[]{}|;:,.<>?
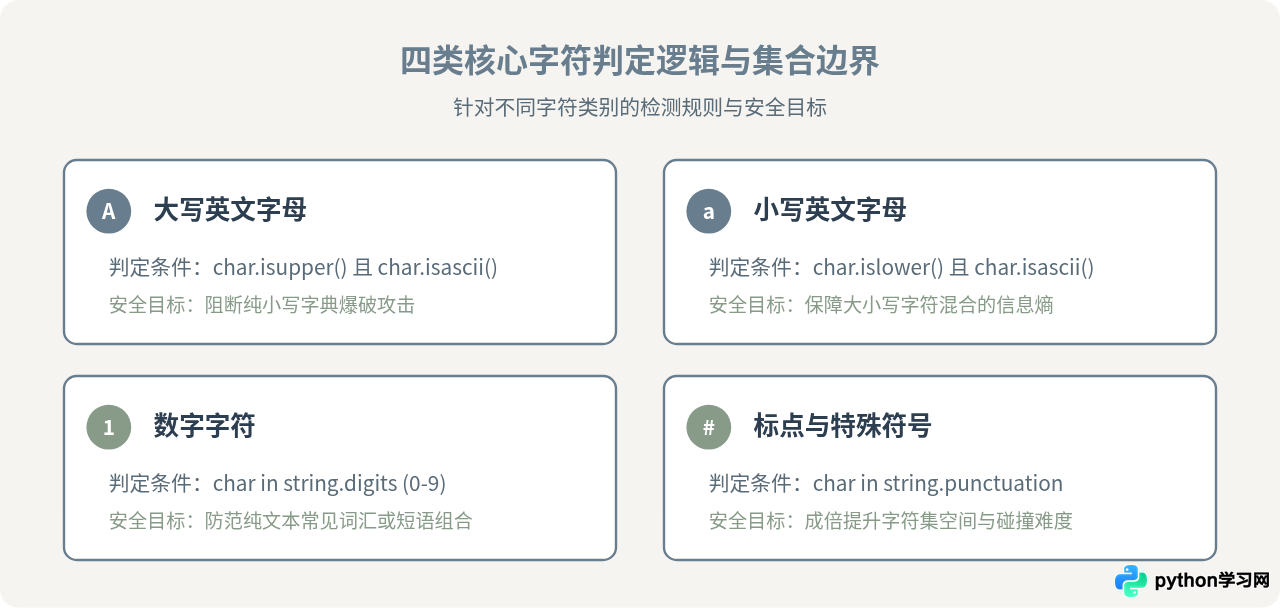
在 Python 中检查字符分类时,推荐使用标准库 string 模块提供的常量集合配合内置字符串测试方法:
char.isupper():如果字符是 Unicode 大写字符则返回 True。在基础密码验证中,通常建议同时结合char.isascii(),以避免带有音标的其他语言变音字母产生意料之外的匹配。char.islower():如果字符是小写字符则返回 True,同理建议限制在 ASCII 范围内。char in string.digits:虽然char.isdigit()也能判断数字,但在 Python 中,类似全角数字(如 "1")或部分 Unicode 数字字符在isdigit()下也会返回 True。直接使用char in string.digits(即 "0123456789")是最准确且安全的做法。char in string.punctuation:包含 32 个常用的 ASCII 标点符号(如!"#$%&'()*+,-./:;<=>?@[\]^_`{|}~)。
三、完整验证函数的构建与实现
结合上述长度与字符分类规则,我们可以编写一个完整的密码验证函数。为了让调用方能够精确提示用户哪些规则未达成,函数应当返回一个布尔状态值和一个包含错误原因的列表。
import string

def validate_password(
    password: str,
    min_len: int = 8,
    max_len: int = 32
) -> tuple[bool, list[str]]:
    """
    验证密码的基础强度:
    1. 检查长度是否在 [min_len, max_len] 区间
    2. 检查是否同时包含:大写字母、小写字母、数字、特殊符号

    返回:
        (is_valid, error_messages)
    """
    errors: list[str] = []

    # 1. 长度校验
    pwd_len = len(password)
    if pwd_len < min_len:
        errors.append(f"密码长度不足,至少需要 {min_len} 个字符(当前 {pwd_len} 个字符)")
    elif pwd_len > max_len:
        errors.append(f"密码长度过长,最多允许 {max_len} 个字符(当前 {pwd_len} 个字符)")

    # 2. 状态标志位初始化
    has_upper = False
    has_lower = False
    has_digit = False
    has_special = False

    punctuation_set = set(string.punctuation)
    digit_set = set(string.digits)

    # 3. 单次线性遍历统计
    for char in password:
        if not char.isascii():
            continue
        if char.isupper():
            has_upper = True
        elif char.islower():
            has_lower = True
        elif char in digit_set:
            has_digit = True
        elif char in punctuation_set:
            has_special = True

    # 4. 汇总字符类型缺失项
    if not has_upper:
        errors.append("密码必须包含至少一个大写英文字母(A-Z)")
    if not has_lower:
        errors.append("密码必须包含至少一个小写英文字母(a-z)")
    if not has_digit:
        errors.append("密码必须包含至少一个数字字符(0-9)")
    if not has_special:
        errors.append("密码必须包含至少一个特殊符号(如 !@#$%^&* 等)")

    # 判定整体是否通过
    is_valid = (len(errors) == 0)
    return is_valid, errors
下面给出一段验证调用的测试示例,直观展示输入不同形态密码时的判定结果:
# 验证示例与控制台输出演示
test_cases = [
    "abc123",              # 长度不足,缺少大写与特殊符号
    "Password123",         # 缺少特殊符号
    "password@2024",       # 缺少大写字母
    "PASSWORD#999",        # 缺少小写字母
    "K7#mQ9!xL2@vP4",      # 完全合规的强密码
]

for pwd in test_cases:
    valid, reasons = validate_password(pwd)
    status_label = "【通过】" if valid else "【未通过】"
    print(f"密码: {pwd:<16} {status_label}")
    for err in reasons:
print(f" - {err}")密码: abc123 【未通过】
- 密码长度不足,至少需要 8 个字符(当前 6 个字符)
- 密码必须包含至少一个大写英文字母(A-Z)
- 密码必须包含至少一个特殊符号(如 !@#$%^&* 等)
密码: Password123 【未通过】
- 密码必须包含至少一个特殊符号(如 !@#$%^&* 等)
密码: K7#mQ9!xL2@vP4 【通过】
四、关键差异分析:原生循环遍历 vs 正则表达式
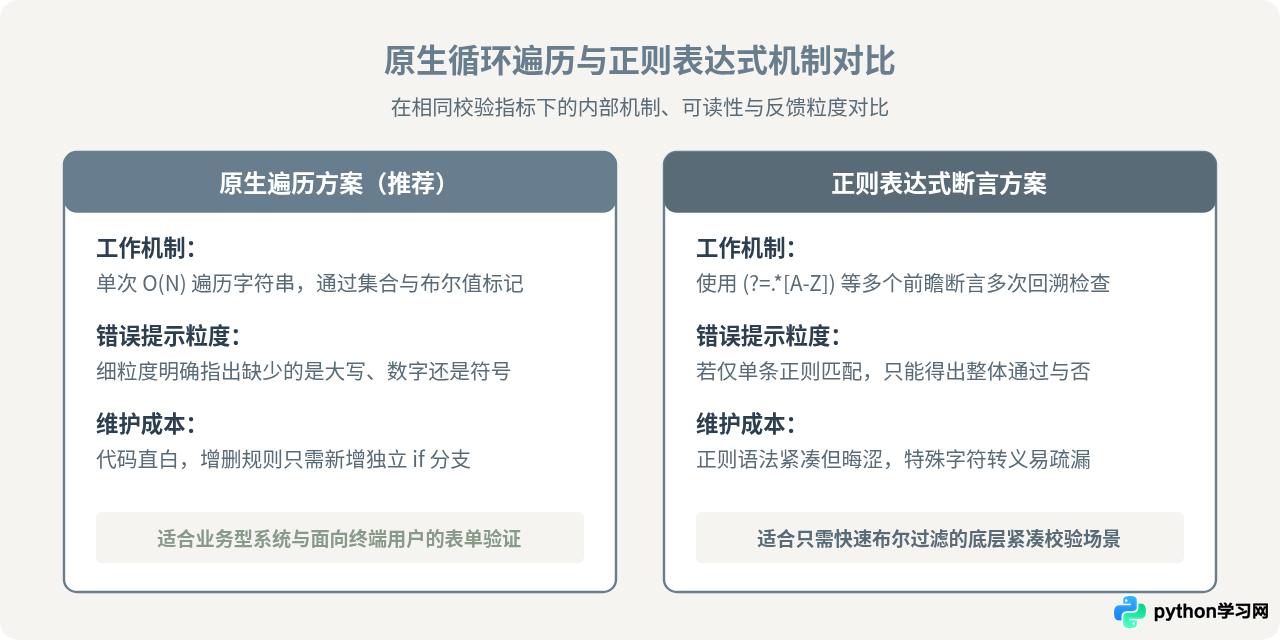
在实现密码字符验证时,经常有两种实现思路被广泛讨论:一种是本文推荐的原生单次循环与集合判断,另一种是基于正则表达式正向肯定前瞻断言(Positive Lookahead)。在完全一致的校验规则下,这两种方式的核心差异与影响如下:
若使用正则表达式,通常会写成如下复杂的模式串:
import re

# 包含大小写、数字、特殊符号且长度在8-32位的前瞻断言正则
PASSWORD_PATTERN = re.compile(
    r"^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[!@#$%^&*()_+\-=\[\]{}|;:,.<>?]).{8,32}$"
)

def validate_by_regex(password: str) -> bool:
return bool(PASSWORD_PATTERN.match(password))为什么在实际工程开发中更推荐原生遍历方案?核心原因在于用户体验与维护成本:
- 错误反馈的清晰度:当用户注册时设置密码失败,单条正则只能返回
False,界面只能提示模糊的“密码不符合规则”。而原生循环可以动态收集具体的未满足项,告知用户“还差一个特殊符号”或“缺少大写字母”,极大地降低了用户试错的挫败感。 - 规则的可读性与扩展性:如果后续业务需要微调规则(例如:允许放宽特殊符号范围、增加黑名单字符过滤、或者限制连续3个相同字符),在原生代码中只需增加几行独立的逻辑分支;而在前瞻断言正则中修改不仅容易引入回溯死循环或转义错误,代码也极难维护。
五、常见问题与注意事项
在落地密码验证功能时,开发者还需要留意几个常见边界问题:
- 空格字符的处理:密码中间是否允许出现空格?大部分系统允许密码包含空格(以支持短语密码 Passphrase),但应当禁止纯首尾空白字符,或者在校验前确认是否需要使用
password.strip()。若业务明确禁止包含任何空格,可在循环中直接增加if char.isspace(): errors.append("密码不能包含空格")。 - 不可见字符与非 ASCII 字符:若用户复制粘贴了零宽空格(Zero-width space)或非西文字符,可能会导致登录输入时极难排查。因此在基础校验中,通过
char.isascii()过滤非标准字符能有效规避编码差异问题。 - 不要使用纯前端校验替代后端验证:前端页面的 JavaScript 密码提示主要服务于交互体验,真正的密码验证必须在后端(如 Python 服务)严格执行,防止攻击者绕过浏览器接口直接提交非法数据。
六、验证规则矩阵与总结
通过清晰的结构化设计,我们能够将密码的基础验证逻辑从主业务流程中解耦出来。下表总结了基础密码验证的关键检测项与判定准则:
| 验证维度 | 检查方法 | 通过条件 | 失败处理 |
|---|---|---|---|
| 长度控制 | len(password) |
8 <= 长度 <= 32 | 快速拦截,直接追加长度说明 |
| 大写英文字母 | char.isupper() and char.isascii() |
至少出现 1 次 | 记录缺少大写字母 |
| 小写英文字母 | char.islower() and char.isascii() |
至少出现 1 次 | 记录缺少小写字母 |
| 数字字符 | char in string.digits |
至少出现 1 次 | 记录缺少数字 |
| 特殊符号 | char in string.punctuation |
至少出现 1 次 | 记录缺少特殊字符 |
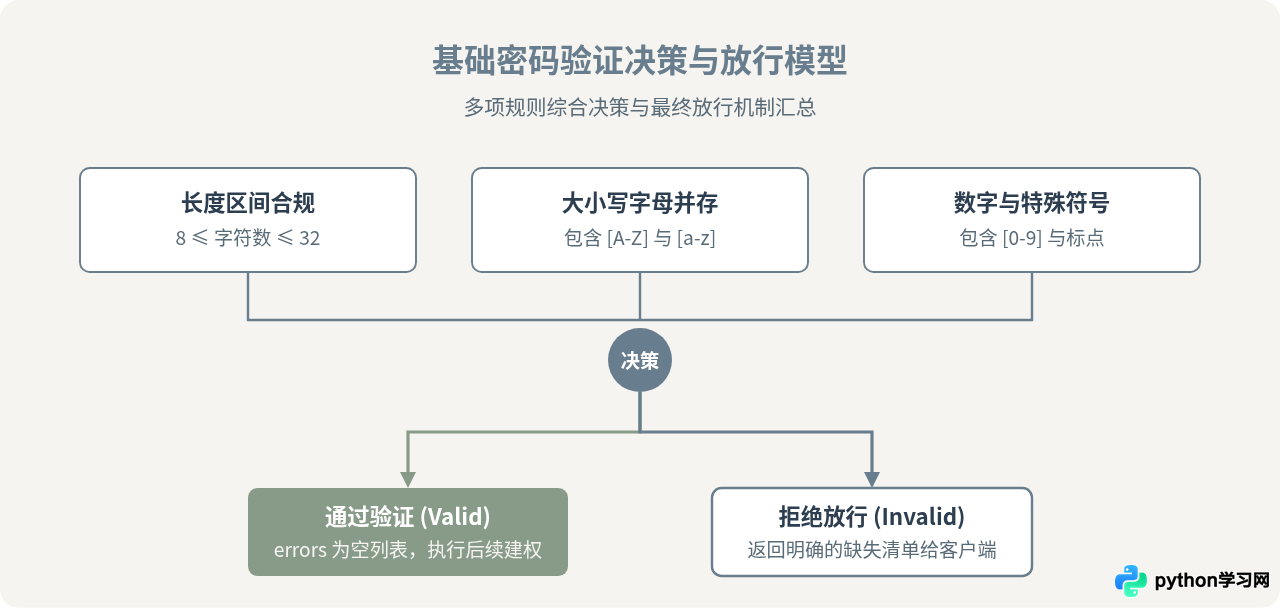
掌握了长度预检与字符分类的核心机制后,可以根据具体业务场景灵活调整条件组合。借助 Python 原生的高效字符串处理能力,无需引入第三方重型依赖,即可打造出安全可靠、反馈直观的密码验证模块。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









