

python必背源代码统计字符出现次数代码
在Python中统计字符出现次数,核心有两种必背方案:标准库collections.Counter(工程开发首选)与原生字典循环遍历(底层哈希面试必背)。本文详解四种经典必背源码、执行机制、数据清洗与性能选型。
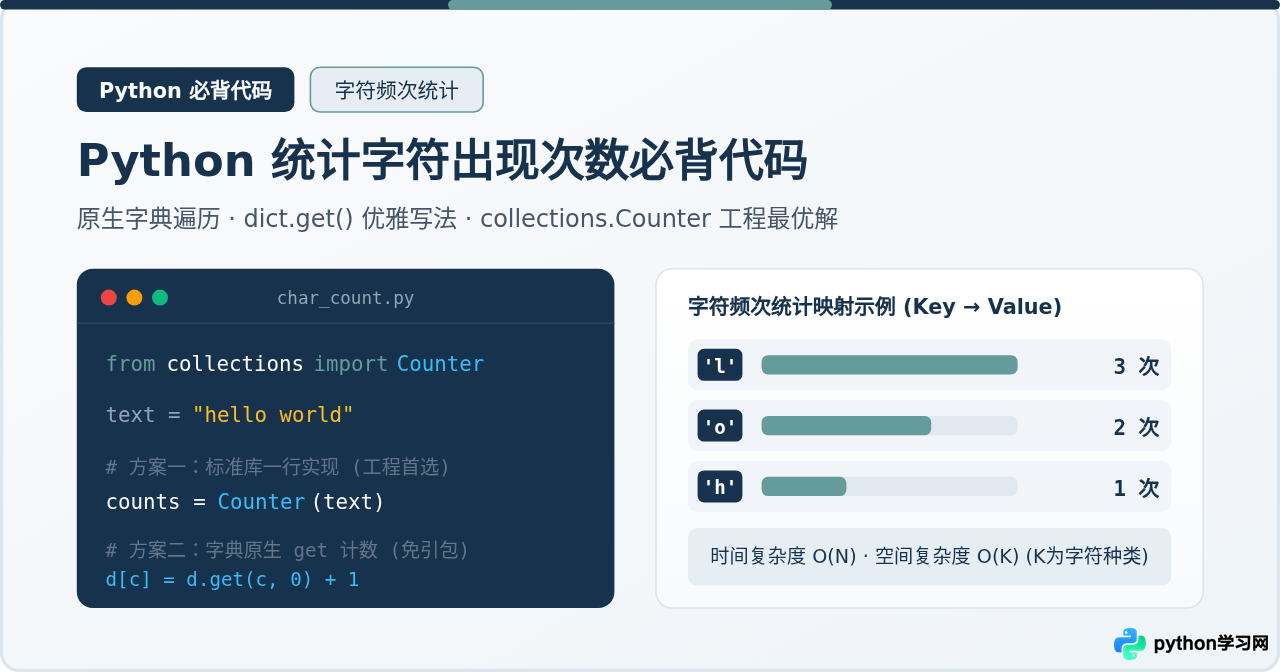
collections.Counter,代码仅需一行且底层由 C 语言加速;如果是算法面试或夯实基础逻辑,必须掌握基于字典(dict)的原生循环计数,尤其是利用 dict.get() 消除判断分支的高效写法。本文将系统梳理这几种经典必背源代码、执行原理、复杂度分析以及文本预处理实战技巧。
一、核心源码速查清单
在深入执行原理之前,这里先列出三种最常调用的核心代码模板,便于快速选用:
| 场景定位 | 实现方式 | 核心代码 |
|---|---|---|
| 工程首选(最推荐) | collections.Counter |
from collections import Counter |
| 免引包优雅写法 | dict.get() 累加 |
counts = {} |
| 仅查单个字符 | 内置方法 str.count() |
num = text.count('a') |
二、经典必背一:原生字典与遍历循环(底层哈希机制)
掌握字典计数是理解哈希表(Hash Table)映射原理的基础。字符串在 Python 中属于可迭代对象(Iterable),通过遍历逐个提取字符,并维护一个以“字符为键(Key)、出现次数为值(Value)”的字典。
1. 基础 if-else 条件判断写法
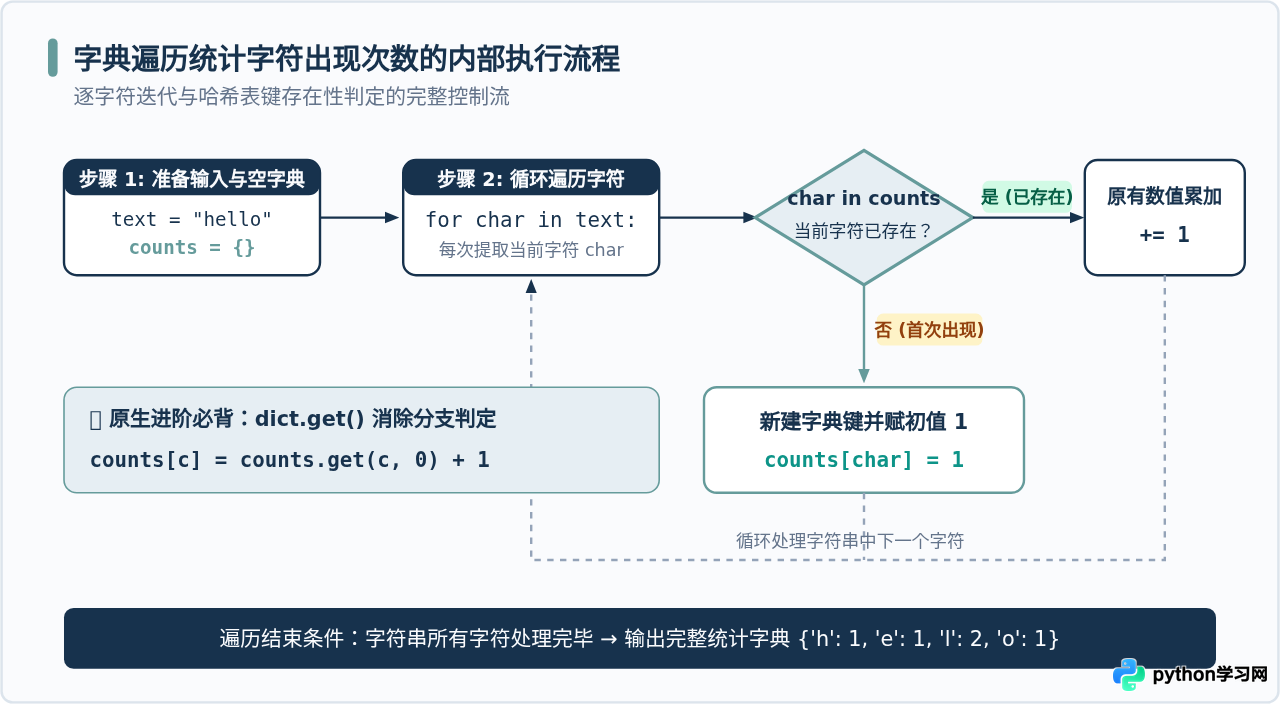
这是最符合直觉的底层逻辑写法。对于字符串中的每一个字符,首先检查它是否已存在于字典的键集合中:若不存在,说明是初次遇到,将频次初始化为 1;若已存在,则在原有数值上加 1。
# 基础 if-else 字典统计源码
text = "hello world"
char_count = {}

for char in text:
    if char in char_count:
        char_count[char] += 1
    else:
        char_count[char] = 1

print(char_count)
{'h': 1, 'e': 1, 'l': 3, 'o': 2, ' ': 1, 'w': 1, 'r': 1, 'd': 1}
2. dict.get() 一行优化写法(必背)
在 Python 中,如果直接访问字典中不存在的键(例如 char_count['z'] += 1),解释器会抛出 KeyError 异常。基础写法用 if-else 规避了该异常,但显得代码冗长。
更优雅的 Pythonic 写法是使用字典内置的 get(key, default) 方法:如果键存在,返回对应的值;如果不存在,则返回指定的默认值 0。这样即可直接进行 + 1 操作,无需显式的条件分支:
# dict.get() 优雅紧凑写法
text = "hello world"
char_count = {}

for char in text:
    char_count[char] = char_count.get(char, 0) + 1

print(char_count)
if-else,dict.get() 将原本 4 行代码浓缩为 1 行,不仅书写清爽,而且减少了字节码层面的跳转指令,在无依赖的原生 Python 代码中执行效率更高。
三、经典必背二:标准库 collections.Counter(工程首选)
如果是在实际业务、数据分析或日常脚本中开发,无需手动编写任何循环,Python 标准库的 collections 模块提供了专门用于频次计数的容器类:Counter。
1. 一行代码实现全量统计
Counter 继承自原生 dict,当把字符串传入时,它会自动在底层完成所有字符的哈希计算与累加,速度显著快于纯 Python 循环:
from collections import Counter

text = "hello world"
counts = Counter(text)

print(counts)
# 访问单个字符:若字符不存在,Counter 不会报错,而是友好地返回 0
print("'l' 的次数:", counts['l'])
print("'z' 的次数:", counts['z'])
Counter({'l': 3, 'o': 2, 'h': 1, 'e': 1, ' ': 1, 'w': 1, 'r': 1, 'd': 1})
'l' 的次数: 3
'z' 的次数: 0
2. 进阶利器:most_common() 快速提取高频字符
在面试或文本分析场景中,“找出出现频次最高的 Top N 个字符”是常见需求。如果用原生字典,还需要调用 sorted(d.items(), key=...) 进行复杂排序;而 Counter 自带高效的 most_common(n) 方法,其内部利用堆(Heap)算法实现了高效的局部排序:
# 统计出现次数最多的前 2 个字符
top2 = counts.most_common(2)
print("最高频字符 Top 2:", top2)
最高频字符 Top 2: [('l', 3), ('o', 2)]
四、方案对比与推导式性能警示
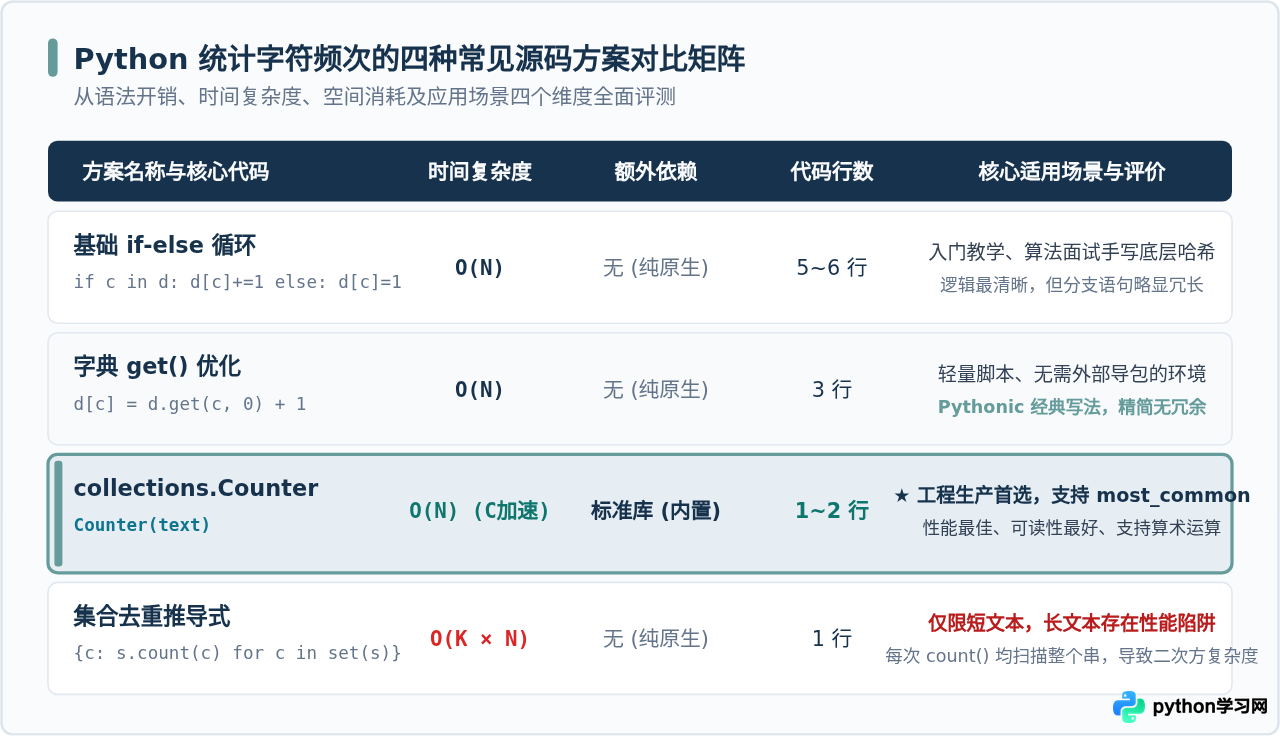
除上述两种主流做法外,初学者还经常遇到 str.count() 和字典推导式的写法。理解它们的适用边界十分关键。
1. 单字符快速统计:str.count()
如果你只需要知道某一个特定字符在长文本中出现了几次,完全不需要遍历整个字符串生成全量字典,直接调用字符串的内置方法 count() 是最快的方案:
text = "banana"
target_count = text.count('a')
print("'a' 出现的次数:", target_count)  # 输出: 3
2. 集合推导式:{c: text.count(c) for c in set(text)}
有些教程会推荐一行字典推导式:先用 set(text) 取得所有不重复字符,然后循环调用 text.count(c):
# 简短但存在性能隐患的写法
text = "hello world"
counts = {c: text.count(c) for c in set(text)}
text.count(c) 时,底层都会从头到尾完整扫描一次字符串(耗时 O(N))。如果字符串中有 K 种不重复字符,整体计算耗时为 O(K × N)。对于数十万字的长文本,该写法耗时可能会比
Counter 或原生字典慢数十甚至数百倍。因此该写法仅适用于几十个字符以内的超短文本,不建议作为通用方案。
五、工程实战:统计前的数据清洗与标准化
在真实业务中,直接统计往往会因为格式噪点导致结果不符合预期。常见问题包括:大写和小写被视作两个独立字符(如 'P' 与 'p')、换行符
和空格占位、或者夹杂中英文标点符号。
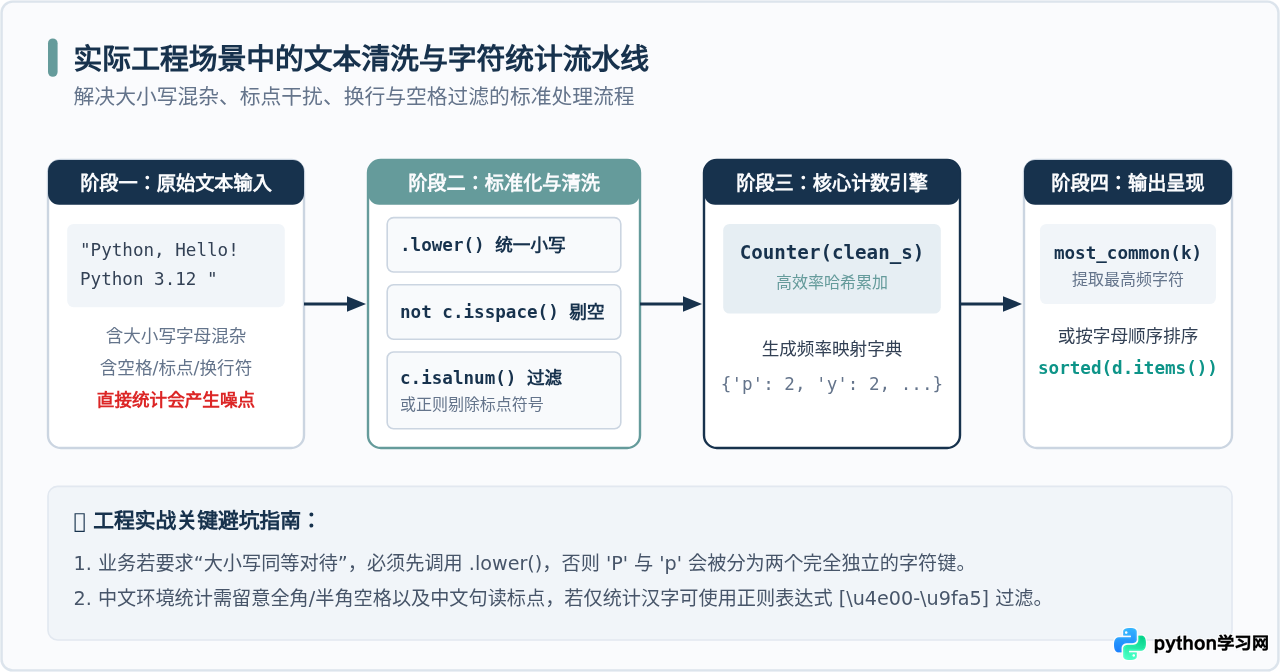
以下是一套健壮的工程处理代码,结合了字符串清洗与 Counter 统计:
from collections import Counter
import re

raw_text = "Python, Python 3.12! 你好,Python。
"

# 步骤 1:统一转换为小写(消除大小写歧义)
normalized_text = raw_text.lower()

# 步骤 2:过滤无意义字符(仅保留字母、数字和中文字符,剔除空格标点)
# 正则 \w 匹配字母、数字以及包括中文汉字在内的字符
clean_chars = [c for c in normalized_text if re.match(r'^\w$', c)]

# 步骤 3:进行频次统计
clean_counts = Counter(clean_chars)

print("清洗后的统计结果:")
for char, count in clean_counts.most_common():
    print(f"字符 '{char}': 出现 {count} 次")
清洗后的统计结果:
字符 'p': 出现 3 次
字符 'y': 出现 3 次
字符 't': 出现 3 次
字符 'h': 出现 3 次
字符 'o': 出现 3 次
字符 'n': 出现 3 次
字符 '3': 出现 1 次
字符 '1': 出现 1 次
字符 '2': 出现 1 次
字符 '你': 出现 1 次
字符 '好': 出现 1 次
六、选型决策指南与记忆总结
面对不同的应用场景,选择最适合的代码实现能够兼顾开发效率、运行性能与代码规范性:
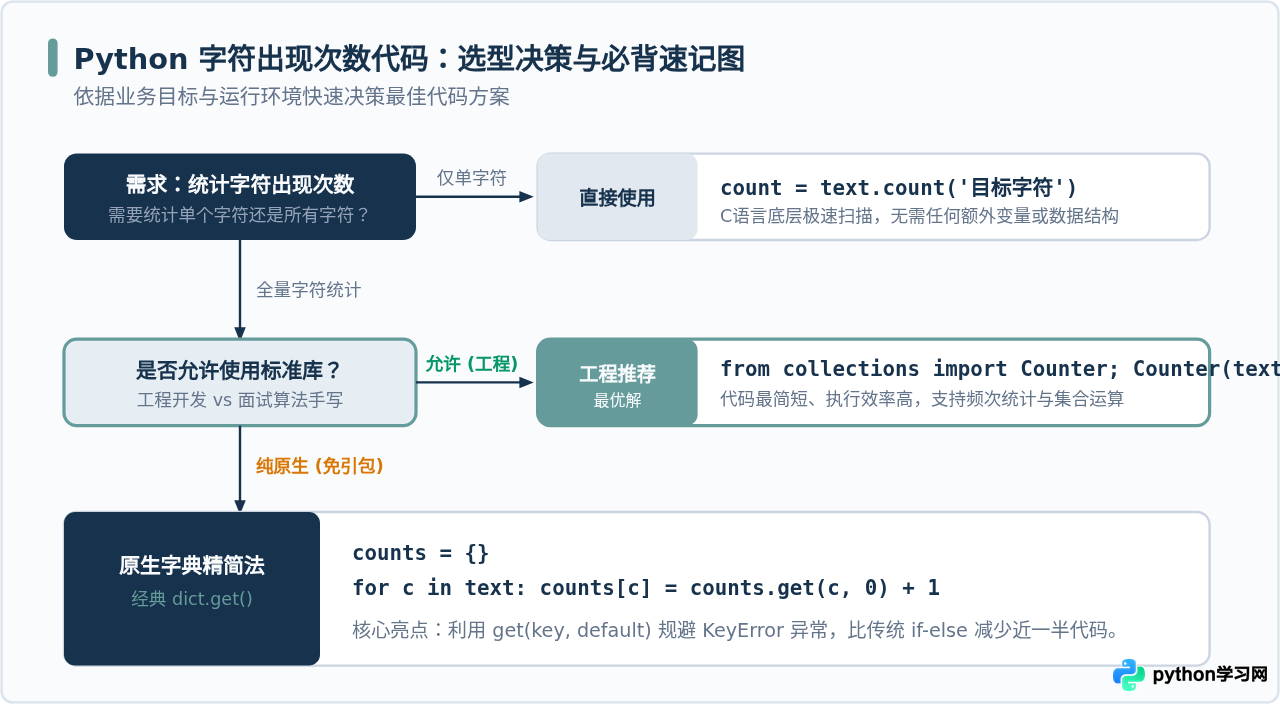
30秒核心记忆口诀
- 单字符查询:直接调
text.count('a'),最快最省事。 - 工程项目开发:必须首选
from collections import Counter,一行代码解决,且自带most_common()排序利器。 - 面试与算法题手写:优先熟背
counts[c] = counts.get(c, 0) + 1,展示对哈希字典机制与默认值特性的熟练掌握。 - 长文本性能警惕:坚决避免在循环或推导式中反复调用
text.count(),防止时间复杂度退化至二次方。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









