

python必背源代码pandas读取Excel代码
本文详解Python中使用pandas读取Excel表格的核心必背代码,包含环境安装、基础读取、工作表选择、行列裁剪过滤、数据类型转换以及常见报错的解决全流程与代码示例。
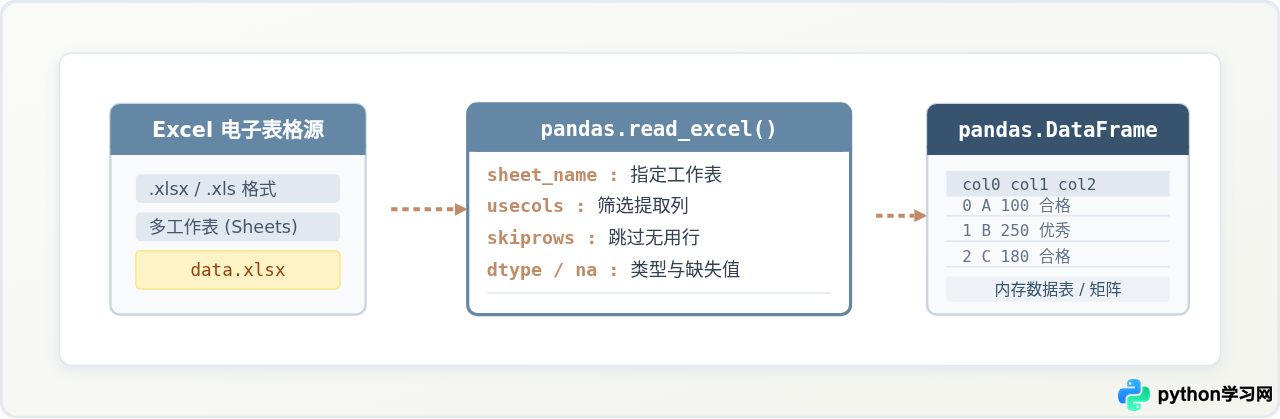
在 Python 数据分析与自动化办公场景中,通过 pandas 读取 Excel 电子表格是出现频次最高的核心技能。其基础执行指令只有简短的一行 pd.read_excel('文件路径'),但在实际使用中,往往伴随工作表指定、跳过冗余表头、筛选特定列、控制数据类型及修补缺失值等多种具体需求。本文精选必须掌握的 pandas 读取 Excel 源代码,并逐一拆解关键参数、执行步骤与避坑细节,让读者可以直接复制并在具体项目中稳定运行。
一、准备工作:依赖引擎与最基础代码
pandas 自身不直接解析二进制的 Excel 文件底层格式,而是通过底层的第三方引擎进行解构。在现代 Python 环境中处理主流的 .xlsx 格式,官方推荐使用的引擎是 openpyxl;如果要读取早期遗留的 .xls 格式文件,则需要依赖 xlrd。因此在运行读取代码前,必须确保安装了相应引擎。
# 终端执行命令:安装 pandas 与底层解析引擎 openpyxl
pip install pandas openpyxl
安装完成后,使用 Python 读取 Excel 的最基础必背代码如下:
import pandas as pd

# 最简读取代码:读取当前路径下的 data.xlsx 默认工作表
df = pd.read_excel('data.xlsx')

# 检查读取结果:打印前 5 行与表格形状信息
print("数据前 5 行:")
print(df.head())
print("
表格维度(行, 列):", df.shape)
在 Windows 环境下,若文件路径包含反斜杠 \,容易因转义符产生路径读取失败。推荐在路径字符串前加上前缀 r,写成原始字符串:
# 推荐的跨目录或 Windows 绝对路径写法
df = pd.read_excel(r'D:\workspace
eports6_sales.xlsx')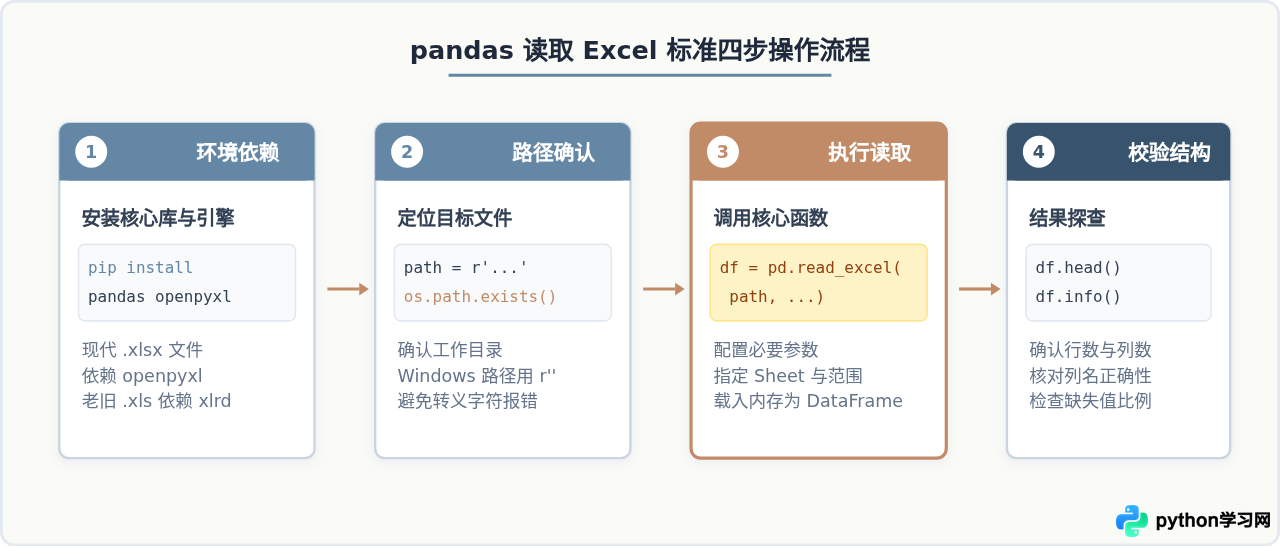
二、精准定位:指定工作表 (sheet_name)
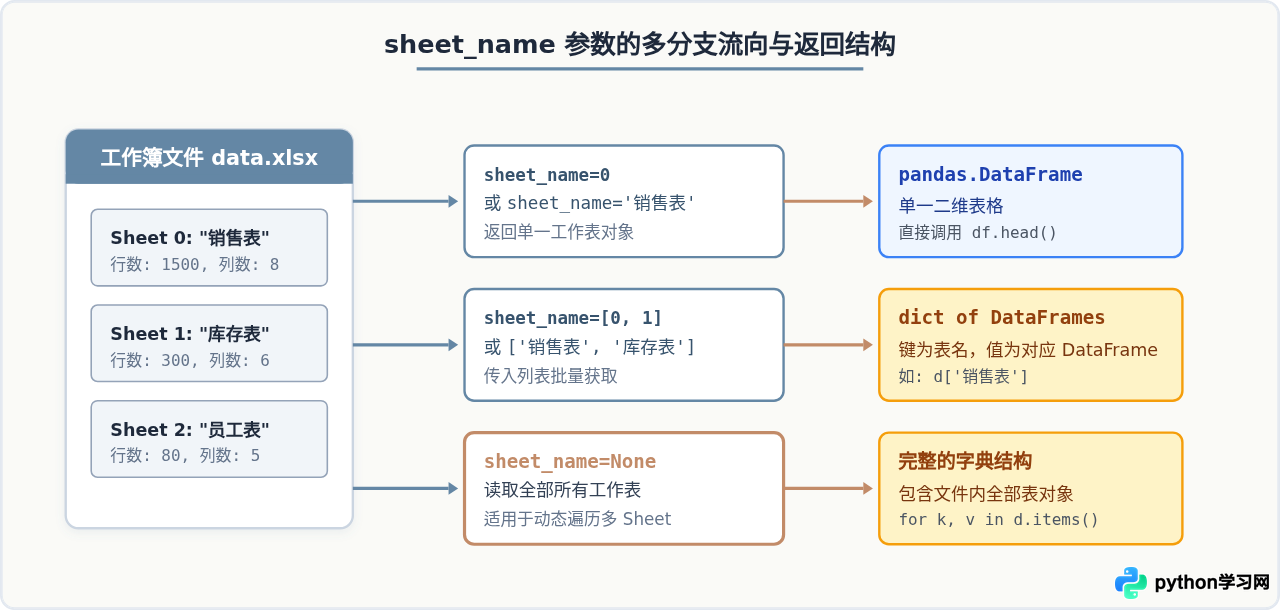
Excel 工作簿通常包含多个工作表(Worksheet)。如果不传 sheet_name 参数,pandas 默认只会读取索引为 0 的第一个工作表。通过灵活设置 sheet_name,可以精确读取某一个、某几个甚至全部工作表。
1. 常用读取模式与必背代码
import pandas as pd

excel_file = 'company_sales.xlsx'

# 模式 A:按索引读取(0 代表第 1 个工作表,1 代表第 2 个工作表)
df_first = pd.read_excel(excel_file, sheet_name=0)

# 模式 B:按工作表名称读取(常用且直观)
df_shanghai = pd.read_excel(excel_file, sheet_name='上海分部')

# 模式 C:读取多个指定工作表(返回字典,键为表名,值为对应的 DataFrame)
dict_dfs = pd.read_excel(excel_file, sheet_name=['北京分部', '上海分部'])
df_beijing = dict_dfs['北京分部']

# 模式 D:一次性读取所有工作表(设置 sheet_name=None)
all_sheets_dict = pd.read_excel(excel_file, sheet_name=None)
for sheet_name, df_sheet in all_sheets_dict.items():
print(f"工作表【{sheet_name}】共有 {len(df_sheet)} 行数据")sheet_name 传入单个整数或单个字符串时,函数返回单一的 pandas.DataFrame;当传入列表或 None 时,函数返回一个以表名为 Key、对应 DataFrame 为 Value 的 dict。若对字典直接调用 .head() 会抛出 AttributeError。
三、规整裁剪:行列过滤与表头定位
日常业务中的 Excel 往往并不“纯净”:顶部可能包含 2~3 行大标题、制作人批注或空行;底部附带合计签名;横向更是包含许多无关字段。如果直接读取,脏数据会变成列名或混入数据区。通过行列过滤参数可以实现入库即清洗。
1. 核心裁剪参数详解
skiprows:跳过表格开头的指定行数。例如skiprows=2跳过前 2 行。header:指定哪一行作为列索引。默认为 0(即跳过之后的第一行作为列名)。如果文件完全没有表头,需显式设置header=None。usecols:只读取指定列。支持列名列表(如['姓名', '薪资'])、列索引序号列表(如[0, 2, 4])或 Excel 字母列范围(如'A:C,E')。nrows:限制读取的最大行数,适合文件极大时进行快速抽样或结构试探。skipfooter:跳过表格末尾的最后 N 行,常用于剔除底部的“制表人签章”或“系统生成时间”。index_col:将某一列直接设置为行索引(Index),例如以“员工工号”作为索引。
2. 典型业务表格读取必背代码
import pandas as pd

# 场景:Excel 前两行为公司名称与说明,第3行是正式列名;末尾有1行统计备注;仅提取4个关键列
df_clean = pd.read_excel(
    'monthly_report.xlsx',
    skiprows=2,                                # 跳过开头的两行标题行
    header=0,                                  # 以剩余区域的第1行作为列索引
    usecols=['工号', '姓名', '部门', '实发工资'],    # 仅加载指定字段,大幅节省内存
    skipfooter=1,                              # 剔除尾部“审核签字”行
    nrows=1000,                                # 限制只取前 1000 行
    index_col='工号'                           # 以工号作为行唯一标识
)

print(df_clean.head())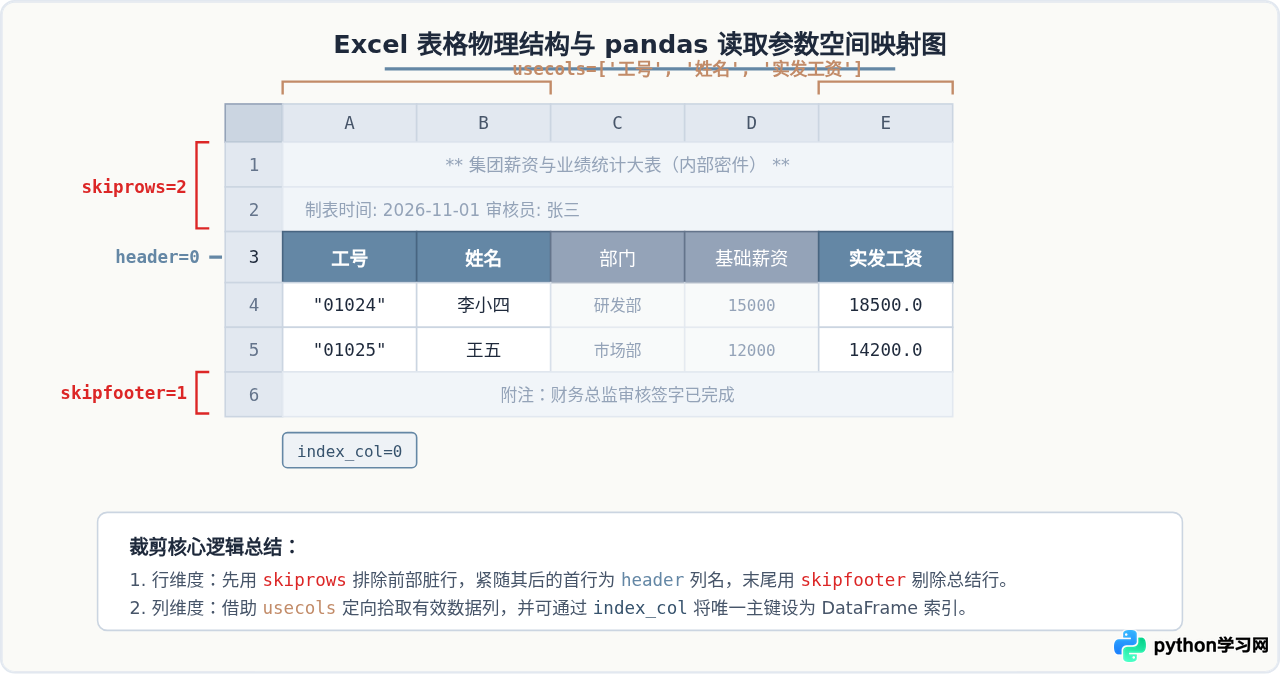
四、数据准确性:强制类型转换与缺失值处理
Excel 会自动推断单元格格式,这种“聪明”的行为常常在数据分析中引发灾难性后果:
- 前导零丢失:如工号
"00123"、手机号或身份证号,Excel 读取后常自动转为整数123,丢失开头的0。 - 日期格式混杂:日期字段若未显式指定,可能被识别为普通文本或浮点时间戳,无法直接进行时间序列运算。
- 业务占位符未识别为 NaN:业务人员习惯在表格中填入
"-"、"暂无"、"N/A",pandas 默认会将其当成普通文本,导致整列数值降级为object类型。
1. 控制类型与空值的必背代码
import pandas as pd

# 生产级必背参数组合:指定列类型、解析日期与自定义缺失值
df = pd.read_excel(
    'customer_data.xlsx',
    # 1. 强制类型转换:防止前导 0 丢失
    dtype={
        '客户编号': str,
        '手机号码': str,
        '身份证号': str
    },
    # 2. 自动解析为 datetime64 类型
    parse_dates=['注册时间', '最后下单日期'],
    # 3. 将常见业务占位符统一转为 np.nan 缺失值
    na_values=['-', '--', '暂无', '待补', 'N/A', 'none']
)

# 验证数据类型
print(df.dtypes)
五、常见报错原因与排查方案
使用 pandas.read_excel 过程中,最常遭遇的几类异常及其直接排查方式如下:
| 报错信息 | 根本原因 | 一行解决办法 |
|---|---|---|
ImportError: Missing optional dependency 'openpyxl' |
环境缺少解析 .xlsx 的底层引擎 |
终端执行 pip install openpyxl |
FileNotFoundError: [Errno 2] No such file |
当前运行路径与文件实际路径不一致,或路径转义错误 | 使用绝对路径并加 r'' 前缀,或用 os.getcwd() 确认路径 |
ValueError: Worksheet named '...' not found |
指定的工作表名称拼写错误或存在前后不可见空格 | 使用 pd.ExcelFile(path).sheet_names 打印真实表名列表核对 |
XLRDError: Excel xlsx file; not supported |
使用老版本 xlrd 尝试读取现代 .xlsx 文件 |
显式传入参数 engine='openpyxl' |
当无法确定 Excel 文件内到底有哪些工作表时,推荐使用 pd.ExcelFile 先进行探查,避免反复载入大文件浪费时间:
import pandas as pd

# 探查工作表元信息(不耗费大内存加载整表数据)
with pd.ExcelFile('large_database.xlsx') as xls:
    print("该 Excel 包含的所有工作表名称:", xls.sheet_names)
    # 按需选择特定表解析
    df_first = pd.read_excel(xls, sheet_name=xls.sheet_names[0])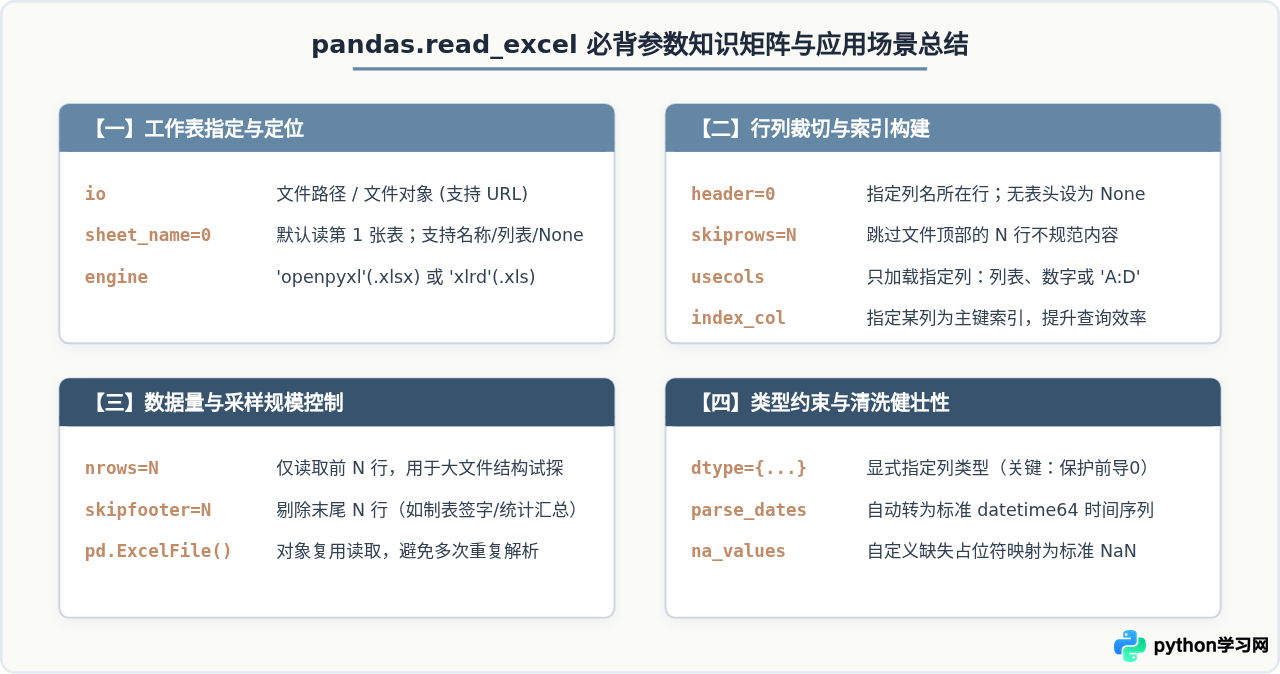
六、全文精要总结
掌握 pandas 读取 Excel 并不需要死记全部参数,而是要建立“依赖安装 → 路径定位 → 范围裁剪 → 类型保护”的完整思考链条:
- 不可忽略的底层引擎:现代 Excel 必备
pip install openpyxl,若缺失引擎,代码连第一行都无法运行。 - 按需获取工作表:多表场景优先利用
sheet_name=None批量加载为字典,或指定表名避免加载无关数据。 - 防御性类型控制:涉及工号、订单号、电话号码、身份证号的列,养成始终配置
dtype={'字段名': str}的习惯,防止前导 0 被自动抹除。 - 前置清洗降本增效:善用
skiprows与usecols,在数据进入内存的瞬间完成脏行剥离与无用列过滤,大幅提升后续处理性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









