

Python列表vs元组、集合vs字典:易混淆数据类型的区别与选型
深入对比Python中列表与元组、集合与字典两组易混淆数据类型的底层机制、可变性、性能差异与实际选型策略,帮助开发者在工程场景中准确选择最合适的数据结构。
在 Python 编程中,列表(list)、元组(tuple)、集合(set)与字典(dict)构成了最基础且高频使用的数据容器。它们的本质差异源自底层的内存分配方式与查找算法设计:列表与元组属于有序线性序列,核心分歧在于“是否允许就地修改”以及由此带来的内存扩容成本;集合与字典均构建于哈希表(Hash Table)之上,拥有近乎常数级的检索效率,核心分歧在于存储目标是“唯一键的集合”还是“键值配对的映射”。准确掌握这两组类型的结构差异,是避免性能陷阱、设计出严谨健壮程序的前提。
一、列表 vs 元组:线性序列的可变与不可变之争
列表和元组都属于序列(Sequence)类型,支持通过正负整数索引、切片访问元素,并严格保留插入时的先后顺序。然而在数据模型层面,二者承担着截然不同的工程语义。
1. 核心属性与行为差异
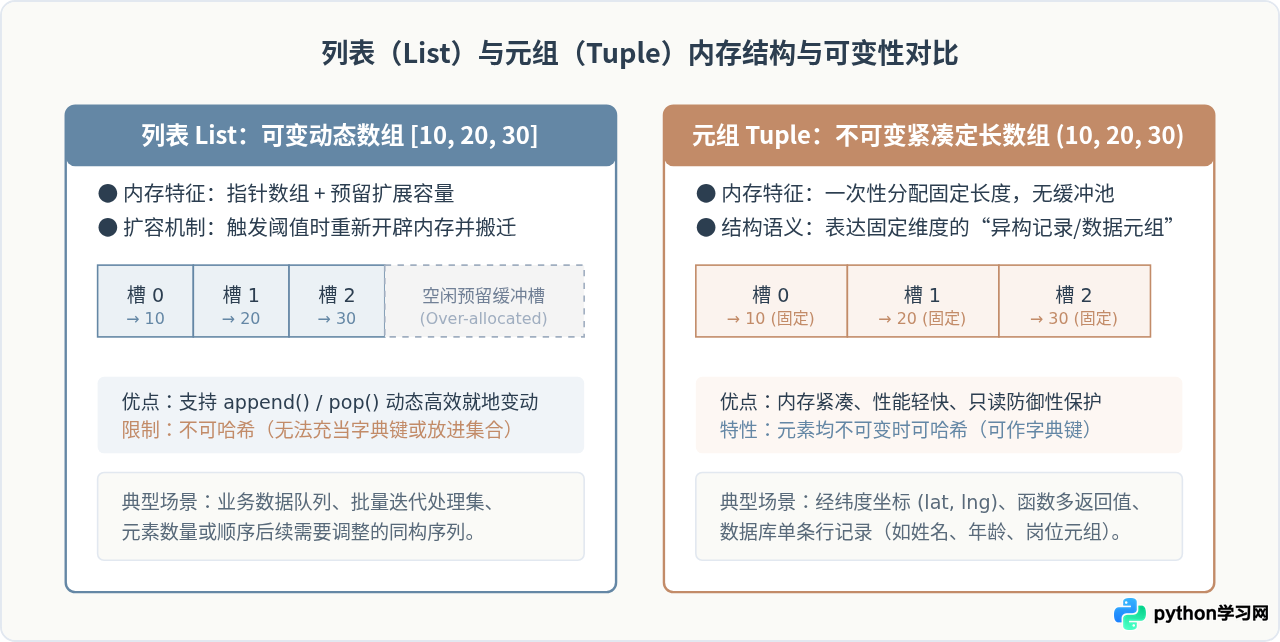
- 可变性(Mutability):列表是可变对象(Mutable),可以在创建后动态添加、删除、替换元素或对自身排序(如
append()、pop()、sort());元组是不可变对象(Immutable),一旦初始化完成,其长度和指向的元素指针均不可改变。 - 可哈希性(Hashability):由于列表内容随时可能变更,它属于不可哈希类型(Unhashable),不能作为字典的键或集合的元素;而仅包含不可变元素的元组是可哈希的,可以安全地用作复合主键或映射键名。
- 内存机制与开销:元组在创建时根据元素数量精确分配一段紧凑内存;列表为了支持频繁的高效追加,采用了过度分配(Over-allocation)策略,内部维系着容量缓冲池。因此,在存储相同元素时,元组的内存开销更小,创建与遍历速度也略胜一筹。
2. 操作对比与代码实例
以下示例清晰展现了列表与元组在就地操作、哈希支持上的关键差别:
# 1. 列表的可变操作
user_tags = ["python", "backend"]
user_tags.append("database")  # 就地添加元素
user_tags[1] = "web"          # 就地替换元素
print("修改后的列表:", user_tags)  # 输出: ['python', 'web', 'database']

# 2. 元组的不可变保护
coordinate = (120.15, 30.28)
# coordinate[0] = 120.16     # 触发 TypeError: 'tuple' object does not support item assignment

# 3. 作为字典键(Hashable 检验)
valid_cache = {
    ("192.168.1.1", 8080): "Server_A"  # 元组作为复合键合法
}
print("元组键查取成功:", valid_cache[("192.168.1.1", 8080)])

# invalid_cache = { ["192.168.1.1", 8080]: "Server_A" }
# 上述写法会直接报错: TypeError: unhashable type: 'list'如果元组内部嵌套了列表等可变对象,如 t = (1, [2, 3]),元组保存的是该列表的内存引用地址。虽然不能将该位置重新指向其他对象,但可以直接修改该内部列表 t[1].append(4)。此时,由于其内部包含可变结构,该元组也将失去可哈希性,无法再作为字典的键。
二、集合 vs 字典:哈希表驱动下的单值与键值对
集合与字典在语法上都使用大括号 {} 定义,且核心底层机制完全相同——它们都是基于哈希表(Hash Table)实现的稀疏键值结构。由于依赖哈希计算精确定位内存槽,它们能够在不遍历全部数据的前提下,实现平均时间复杂度为 O(1) 的超高速检索。
1. 核心属性与结构差异
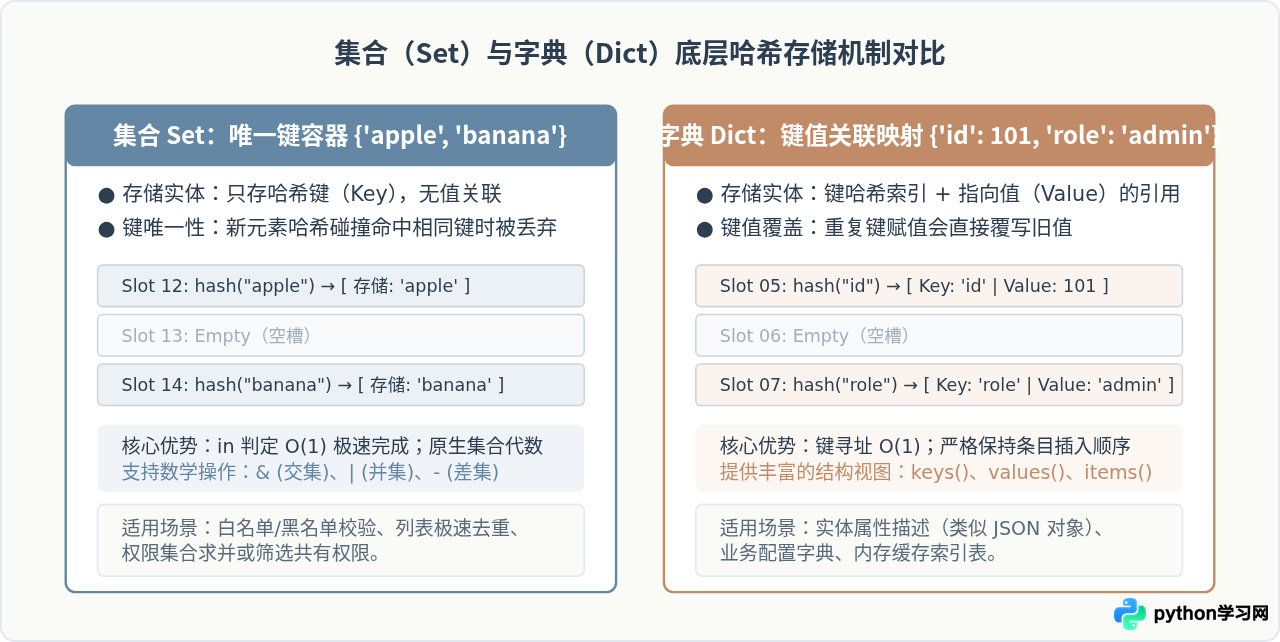
- 存储内容:集合(
set)仅存储独立的元素(即“键”本身),元素必须唯一且不可变;字典(dict)存储的是由键与值构成的映射对(Key-Value Pair),键必须唯一且不可变,而值可以是任意 Python 对象。 - 数学集合运算:集合针对数学集合理论进行了深度封装,原生支持交集(
&)、并集(|)、差集(-)、对称差集(^)等向量级操作;字典则专注于通过键快速索引、更新对应的属性与载荷。 - 顺序保证:在 Python 3.7+ 中,字典严格保留键值对的插入顺序(Insertion Order);而集合虽然使用紧凑表结构,但属于无序集合,不保证任何稳定的遍历顺序,更不支持索引访问。
2. 初始化陷阱与代码对比
新手最容易踩的一个基础语法坑是空容器的字面量表示:因为历史沿革,单独的大括号 {} 默认是空字典,而非空集合。
# 1. 空容器的声明规则
empty_dict = {}          # 这是一个 dict
empty_set = set()        # 声明空集合必须显式调用 set()
print("empty_dict 类型:", type(empty_dict))  # <class 'dict'>
print("empty_set 类型:", type(empty_set))    # <class 'set'>

# 2. 集合运算示例:高效权限判定与交集计算
allowed_roles = {"admin", "editor", "moderator"}
user_roles = {"guest", "editor"}

# 极速求共有角色(交集)
common_roles = allowed_roles & user_roles
print("共有角色:", common_roles)  # 输出: {'editor'}

# 极速判定是否具备管理权限(常数级判断)
is_allowed = "admin" in user_roles
print("是否是管理员:", is_allowed)  # 输出: False

# 3. 字典的键值存储与默认值保护
user_profile = {"uid": 1001, "status": "active"}
# 使用 get 方法提供安全缺省值
nickname = user_profile.get("nickname", "未知访客")
print("读取用户昵称:", nickname)  # 输出: 未知访客
三、系统化选型:数据结构推导决策树
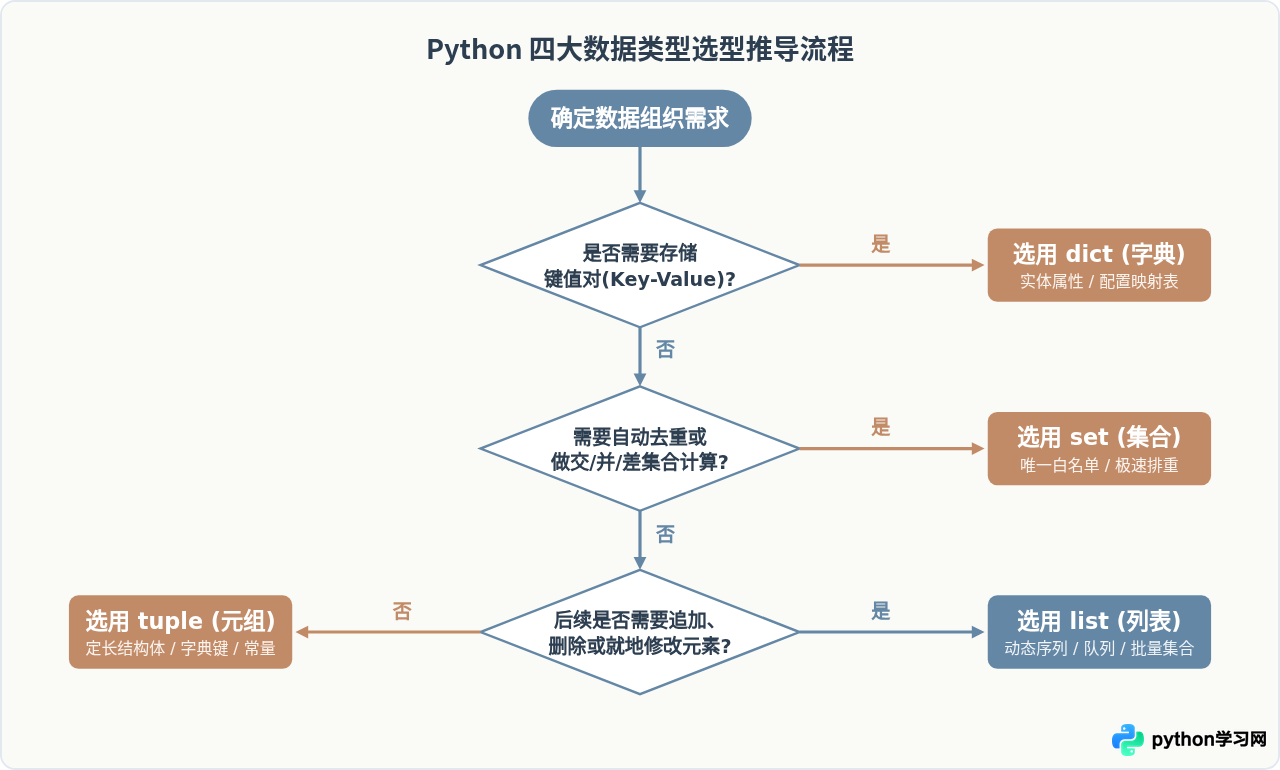
在面对具体的业务需求时,不必凭经验随意敲定类型。可以通过逐层回答以下四个关键问题,推导出唯一适合该场景的容器类型:
- 问题一:数据是否由“属性名/键”与“对应数据/值”配对组成?如果必须建立键值关联,直接选择
dict。 - 问题二:数据是否要求强制去重,或者需要频繁做集合求交、求并、排除运算?如果核心是单值去重与集合判定,选择
set。 - 问题三:数据序列在生成后,是否需要被就地修改、追加、删除或重排?如果需要动态变动,选择
list。 - 问题四:数据是否是一旦生成就不应改动的只读常量记录,或者需要充当哈希键?如果是不可篡改的元信息,选择
tuple。
四、操作复杂度对比与工程避坑指南
1. 时间复杂度与性能对照表
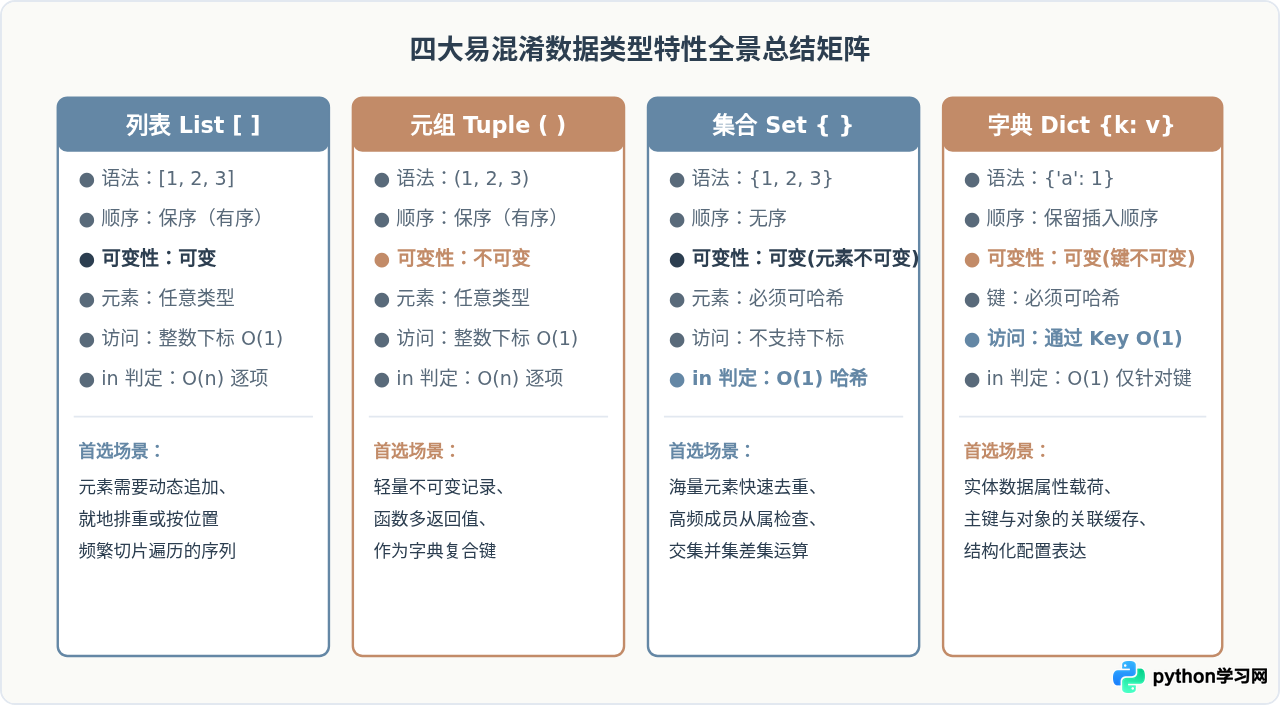
很多工程性能瓶颈源于在错误的数据类型上执行了高频操作,例如在数百万元素的列表中反复使用 in 关键字进行查找。以下是各类型在典型操作下的平均时间复杂度:
| 数据类型 | 索引访问 (obj[i]) |
末尾追加 (append) |
成员判定 (item in obj) |
内存紧凑度 | 可哈希性 (Hashable) |
|---|---|---|---|---|---|
| 列表 (list) | O(1) | O(1) 均摊 | O(n) 线性扫描 | 中等(含预留缓冲池) | 不可哈希 |
| 元组 (tuple) | O(1) | 不支持修改 | O(n) 线性扫描 | 极高(定长单块分配) | 可哈希(元素均不可变时) |
| 集合 (set) | 不支持索引 | O(1)(add) |
O(1) 哈希直达 | 较低(稀疏哈希表开销) | 不可哈希 |
| 字典 (dict) | O(1)(通过键) | O(1)(赋值添加) | O(1) 仅针对键 (Key) | 较低(哈希索引 + 条目表) | 不可哈希 |
2. 常见反模式与规避建议
- 反模式一:在长列表中使用
if item in big_list:进行循环判定。每次判断都会从头扫描整个列表,整体复杂度迅速劣化为 $O(n^2)$。若需要高频查重,应提前执行big_set = set(big_list)将其转为集合,将检索耗时从线性降低至常数级 $O(1)$。 - 反模式二:将列表作为元组或字典键的组成部分。执行类似
hash(([1, 2], "tag"))将直接引发TypeError。若确有不可变序列需求,应将嵌套列表转化为元组,如((1, 2), "tag")。 - 反模式三:在遍历字典或集合时直接删除元素。在迭代过程中直接通过
del my_dict[key]改变容器大小,会引发RuntimeError: dictionary changed size during iteration。安全做法是对需要剔除的键进行列表化切片(如for k in list(my_dict.keys()):),或者使用字典推导式生成全新过滤后的字典。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









