

Python数据分析岗面试最常考的版本兼容问题有哪些?

深入解析Python数据分析岗面试中高频考查的版本兼容问题,包含Pandas 2.0的Copy-on-Write与API废弃、NumPy 2.0的C-API/ABI断裂、Python 3.12模块移除以及生产环境依赖冲突的标准化排查策略与面试回答要点。
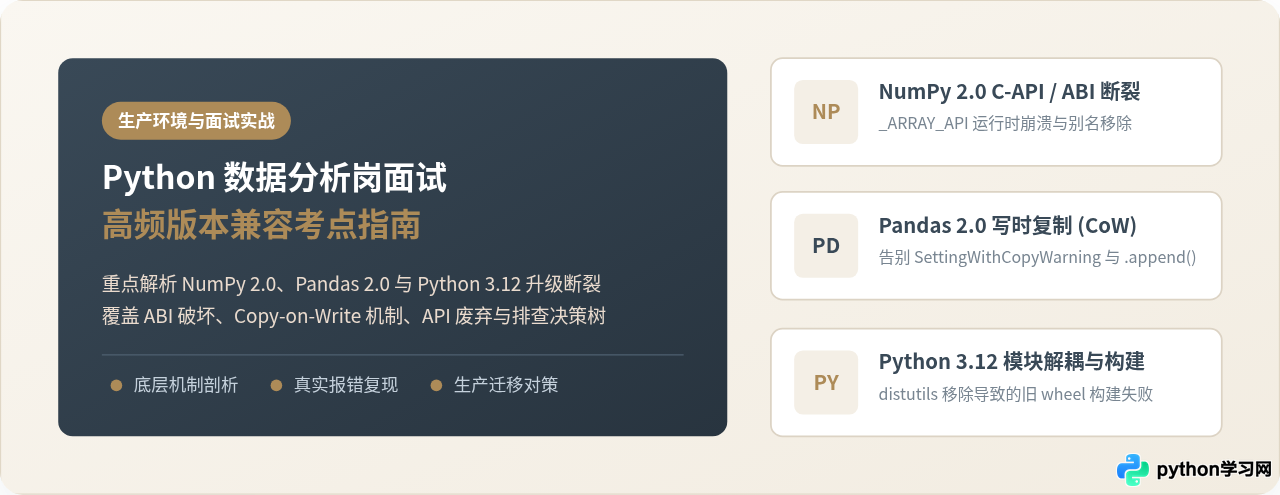
一、Pandas 2.0 升级带来的三大破坏性破坏(Breaking Changes)
Pandas 在 2.0.0 及后续次版本中完成了近年来最大力度的底层重构。面试中涉及 Pandas 兼容性的问题,几乎 90% 都集中在“内存引用机制”与“高频废弃接口”上。
1. Copy-on-Write(CoW,写时复制)机制与赋值陷阱
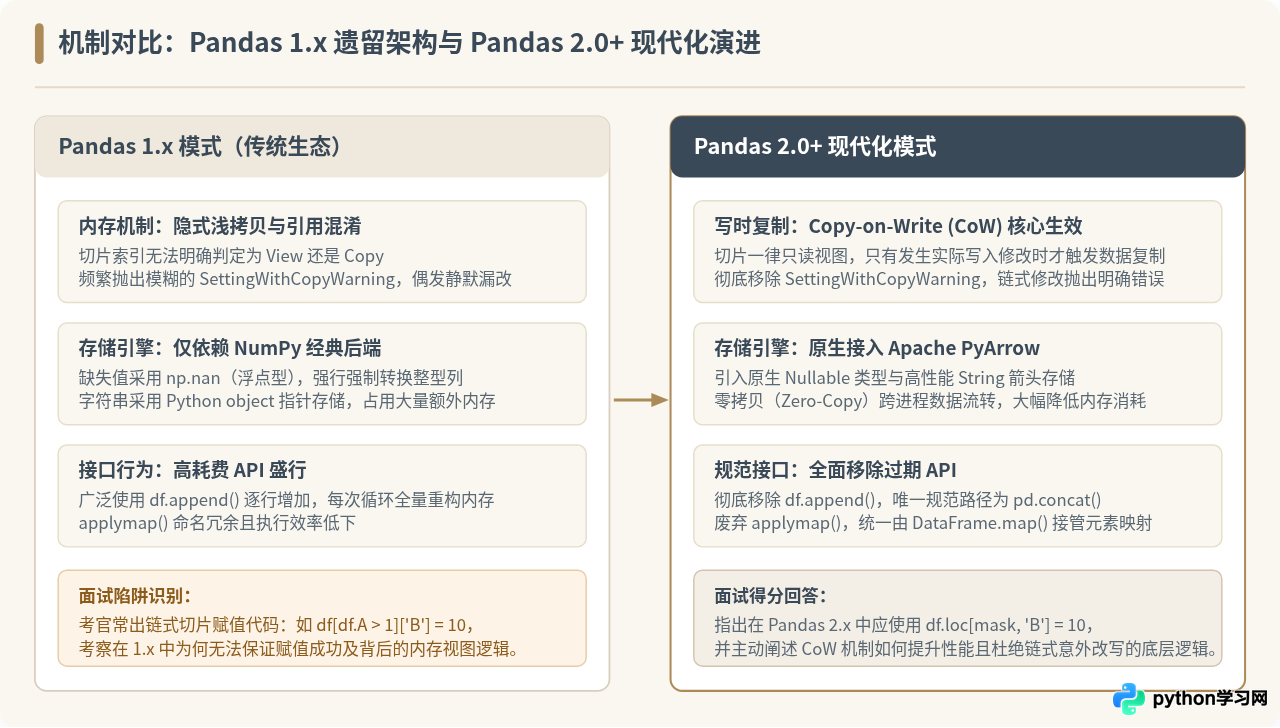
在 Pandas 1.x 中,切片操作返回的是原对象的“视图”(View)还是“独立副本”(Copy)存在诸多隐式规则。这直接导致了著名的 SettingWithCopyWarning 警告。开发者经常遇到诸如 df[df['A'] > 0]['B'] = 100 产生警告,且有时数据能写回原 DataFrame,有时却静默丢失的诡异现象。
自 Pandas 2.0 起引入并在 3.0 中默认启用的 Copy-on-Write 机制彻底终结了这一模糊状态。在 CoW 机制下:所有切片创建的新对象默认与原对象共享底层数据缓冲(只读视图),只有当某个对象执行实际的写操作(修改数据)时,才会主动触发内存数据的物理复制。这意味着在 CoW 开启后,上述链式赋值代码将不再修改原 DataFrame,甚至会直接引发 ChainedAssignmentError 异常。
标准作答:链式赋值依赖连续两次取值(第一步先进行行过滤生成临时对象,第二步修改临时对象中的列),在 Pandas 1.x 中极易因为临时对象是指向副本而导致修改静默失效;在 Pandas 2.0+ CoW 机制下,该操作已被严格限制为非法。标准解法必须使用 df.loc[mask, 'B'] = 100,确保单次调用内部由 C/Cython 层直接定位并修改目标内存地址。
2. 彻底移除 .append() 接口与链式拼接演进
在早期数据分析教学中,许多初学者习惯在循环中使用 df.append(new_row) 逐行拼接数据。从 Pandas 1.4 开始该方法被标记废弃,在 Pandas 2.0 中已被彻底物理移除。调用时会直接报错 AttributeError: 'DataFrame' object has no attribute 'append'。
底层原因与标准替代:由于 DataFrame 采用块式内存连续存储,每次调用 .append() 都需要重新分配整块内存并将已有数据全量拷贝一次,产生 \(O(N^2)\) 的时间复杂度与大量内存碎片。正确的替代方案是:在循环中将各条记录存储为原生 Python 字典列表,循环结束后单次调用 pd.DataFrame(data_list),或将多个局部 DataFrame 收集为列表后单次调用 pd.concat(df_list, ignore_index=True)。
3. 字符串与缺失值后端的 PyArrow 变革
Pandas 1.x 时代字符串只能存储为 Python object 类型的引用指针数组,100 万行文本通常消耗数倍的额外指针内存与垃圾回收开销;且数值列一旦混入缺失值,整型(int)就会被强制向上降级为浮点型(float,因为仅 np.nan 支持浮点缺失)。
Pandas 2.0+ 原生引入了 Apache PyArrow 后端。通过 dtype_backend="pyarrow",可以实现原生的 Nullable 整型、布尔型以及连续内存布局的箭头字符串。面试官若问及“升级 Pandas 2.0 后旧脚本运行结果中数据类型推断不一致”,核心原因就是新版本在指定引擎时会将传统 object 推断为 string[pyarrow],部分基于隐式类型转换的代码需要显式适配。
二、NumPy 2.0 的 C-API / ABI 断裂与生态兼容海啸
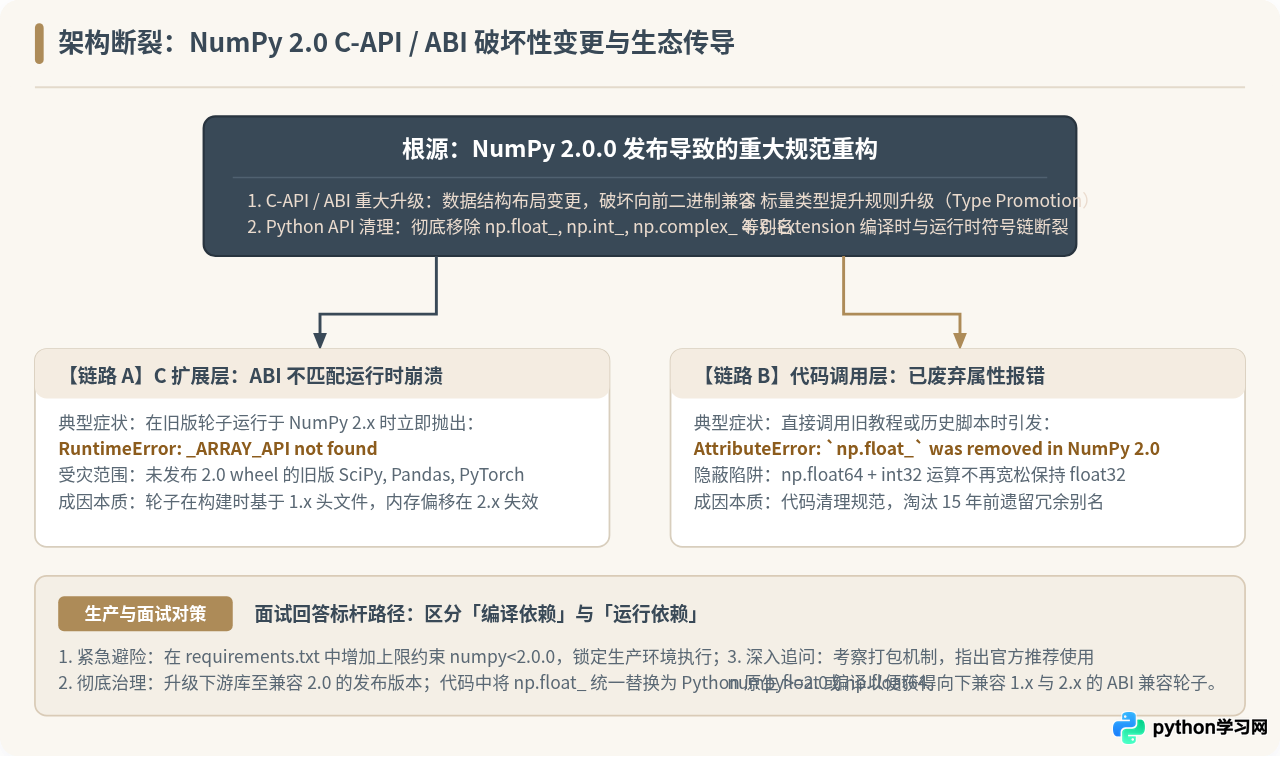
2024 年 6 月 NumPy 2.0.0 的正式发布,是该科学计算核心库时隔十余年最关键的主版本升级。它不仅清理了 Python 层的过时 API,更重构了底层 C-API 和二进制 ABI 规范,在整个数据科学与算法生态中引发了广泛的依赖断裂。
1. ABI 不兼容与 RuntimeError: _ARRAY_API not found
这是当前一线企业生产环境与面试排查中最常见的事故级报错。当一个数据分析工程升级至 numpy >= 2.0.0,而环境里安装的旧版 SciPy(<1.13.0)、Pandas(<2.2.2)或旧版 PyTorch 依然是在 NumPy 1.x 环境下编译的二进制轮子(Wheel)时,程序导入时便会触发 C 扩展初始化崩溃:
# 典型报错示例
ImportError: numpy.core.multiarray failed to import
RuntimeError: _ARRAY_API not found, C-API version mismatch!
原理解析:C 扩展库在构建时会绑定编译期 NumPy 的头文件与函数指针偏移表。NumPy 2.0 对底层内部结构体进行了大面积重构,导致用 1.x 编译出来的 C/Cython 二进制动态库在 2.0 运行时无法解析符号表。解决该问题的关键是理解“构建依赖”与“运行依赖”的解耦:或者升级下游库到针对 NumPy 2.0 编译的新 Wheel,或者在临时维护线上稳定性时将 NumPy 锁定为 numpy < 2.0.0。
2. 标量类型别名移除(np.float_, np.int_)与代码修复
NumPy 2.0 清理了大量在 1.20 之前就已提示过时的别名。如果历史代码中存在如下用法,在 NumPy 2.0 环境中将直接抛出 AttributeError:
# 错误写法(在 NumPy 2.0 中崩溃)
import numpy as np
x = np.float_(3.14)   # AttributeError: module 'numpy' has no attribute 'float_'
y = np.int_(10)       # AttributeError: module 'numpy' has no attribute 'int_'
z = np.complex_(1+2j) # AttributeError: module 'numpy' has no attribute 'complex_'

# 正确标准写法
x = float(3.14)       # 或使用具体位宽:np.float64(3.14)
y = int(10)           # 或使用具体位宽:np.int64(10)
z = complex(1+2j)     # 或 np.complex128(1+2j)
3. 标量类型提升规则(Type Promotion Rules)的规范化
在 NumPy 1.x 中,标量与多维数组参与运算时存在复杂的弱类型提升机制(例如一个 float32 数组与 Python 原生 float(双精度)相加,有时为了节省内存依然保留为 float32)。NumPy 2.0 制定了更严格的类型提升矩阵(NEP 50):Python 标量与数组混合运算时,其类型提升逻辑与同类型的 NumPy 标量完全一致。这会导致部分模型前向传播中的精度类型由单精度静默上升为双精度,进而引发 GPU 显存增长或参数校验不一致问题。
三、Python 解释器版本升级中的典型陷阱(3.8 至 3.12)
数据团队从传统的 Python 3.8 / 3.9 环境向 3.10 / 3.12 迁移时,解释器层面的变动常导致底层依赖安装失败或旧脚本报错。
1. Python 3.12 彻底移除 distutils 模块
Python 3.12 根据 PEP 632 彻底移除了内置的 distutils。在老旧数据分析包或使用旧版本 pip/setuptools 构建源码包(sdist)时,经常触发:
ModuleNotFoundError: No module named 'distutils'
应对措施:确保虚拟环境中的 pip 和 setuptools 升级到最新版本(现代 setuptools 内部自带了独立的 distutils 副本),并在 pyproject.toml 中声明现代构建后端(如 hatchling、flit 或 setuptools>=65.0)。
2. 容器抽象基类导入位置变更(Python 3.10+)
在早期 Python 版本中,开发者可以直接从 collections 中导入抽象容器类。从 Python 3.3 起给出废弃警告,并在 Python 3.10 中彻底移除:
# 废弃且在 Python 3.10+ 报错的写法
from collections import Mapping, Iterable  # AttributeError: module 'collections' has no attribute 'Mapping'

# 兼容 3.10 及以上规范写法
from collections.abc import Mapping, Iterable
3. Python 3.8 EOL(生命周期终结)与依赖包最低版本门槛
Python 3.8 已于 2023 年底到达官方 EOL 节点。目前包括 Pandas(>=2.1)、NumPy(>=1.25)、Scipy(>=1.11)等主流数据科学库均已停止发布针对 Python 3.8 的预编译轮子。面试回答时应点出生产集群基础镜像平滑升级到 3.10 或 3.11 的必要性。
四、Scikit-Learn 与 SciPy 接口演进规范
在涉及特征工程与建模的面试机试或代码审查环节,机器学习库的接口变动同样是高频踩坑点。
- 波士顿房价数据集(
load_boston)被彻底移除:由于该数据集包含涉及伦理和歧视问题的变量,Scikit-Learn 1.2+ 已彻底将其物理删除。代码若调用from sklearn.datasets import load_boston会直接抛出ImportError。机试代码应改用fetch_california_housing。 - 特征提取接口标准化:
OneHotEncoder等预处理器早期使用get_feature_names(),在 Scikit-Learn 1.0 废弃并于后续版本强制统一为get_feature_names_out()。 - SciPy 稀疏矩阵从
spmatrix向sparray的演化:传统的scipy.sparse.csr_matrix遵从类似二维 matrix 的乘法运算规则;SciPy 新版本全面推行遵从标准 NumPy 广播与逐元素运算的csr_array,旧代码中滥用.A或.asmatrix()会在升级后受到警告或废弃影响。
五、生产环境依赖冲突的标准化排查与面试应答框架
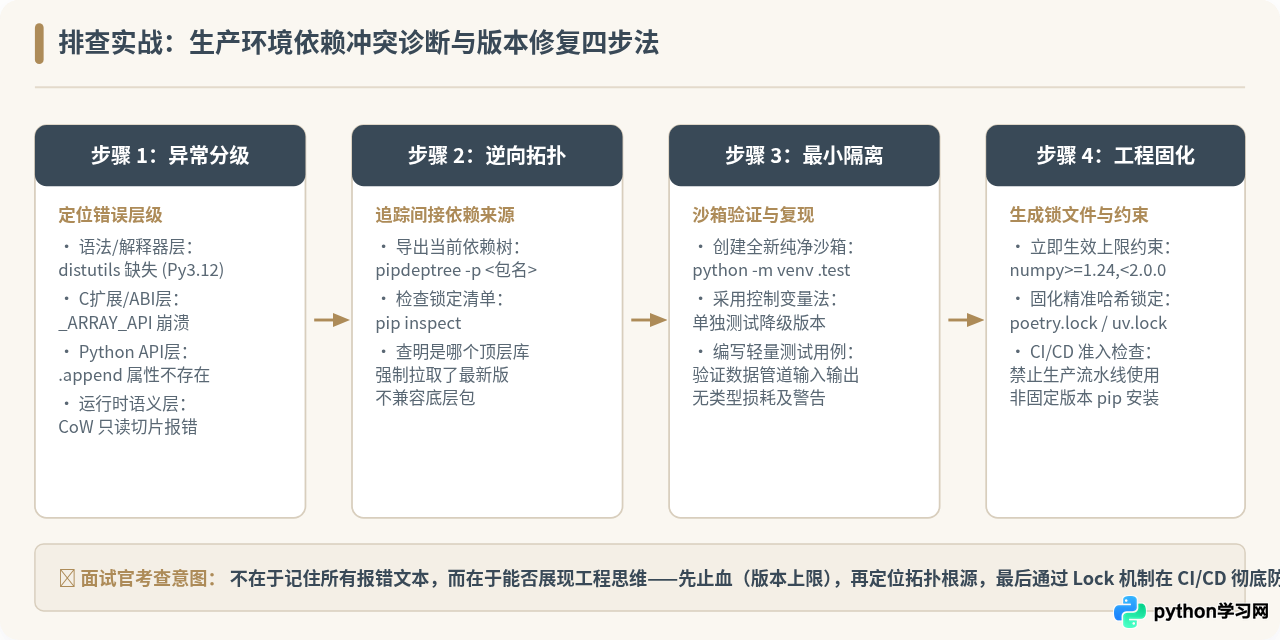
当面试官提问:“如果在生产部署或离线定时任务调度中,遇到由于第三方库升级导致的未知版本冲突崩溃,你的标准排查步骤是什么?”候选人应展现成体系的工程排查素养。
- 第一步:错误特征分类与层级界定
通过调用栈(Traceback)顶端与底端快速定位错误层级。如果属于动态库加载崩溃(如_ARRAY_API、DLL load failed),判定为 C/Cython 二进制 ABI 不兼容;如果属于AttributeError或ImportError,判定为 Python API 废弃或模块重构;如果属于结果异常(如数据写入失败或数值溢出),判定为底层语义变更(如 CoW 或类型提升)。 - 第二步:依赖拓扑图逆向追踪
绝大部分生产版本灾难都是由于依赖声明不严谨(如仅写了pandas而未锁上限),由下游包的间接依赖强制拉取了最新不兼容版本所致。在终端中使用pipdeptree -p <问题包>或pip inspect逆向解析完整的依赖树,查明到底是谁拉入了触发破坏性更新的包。 - 第三步:独立沙箱重放验证
坚决不在生产节点直接尝试pip install --upgrade。在本地或测试容器内构建最小验证虚拟环境(python -m venv .sandbox),采用单变量控制法,逐步验证锁定版本组合的有效性与数据一致性。 - 第四步:工程化约束与长期固化
排查解决后,必须建立防御机制:短期内在requirements.txt中设置版本上限约束(例如numpy>=1.24.0,<2.0.0);长期通过现代依赖锁定工具(如poetry.lock或uv.lock)生成包含精确哈希校验的锁定文件;在 CI/CD 流程中加入pip audit与构建静态检测,杜绝无限制通配符安装。
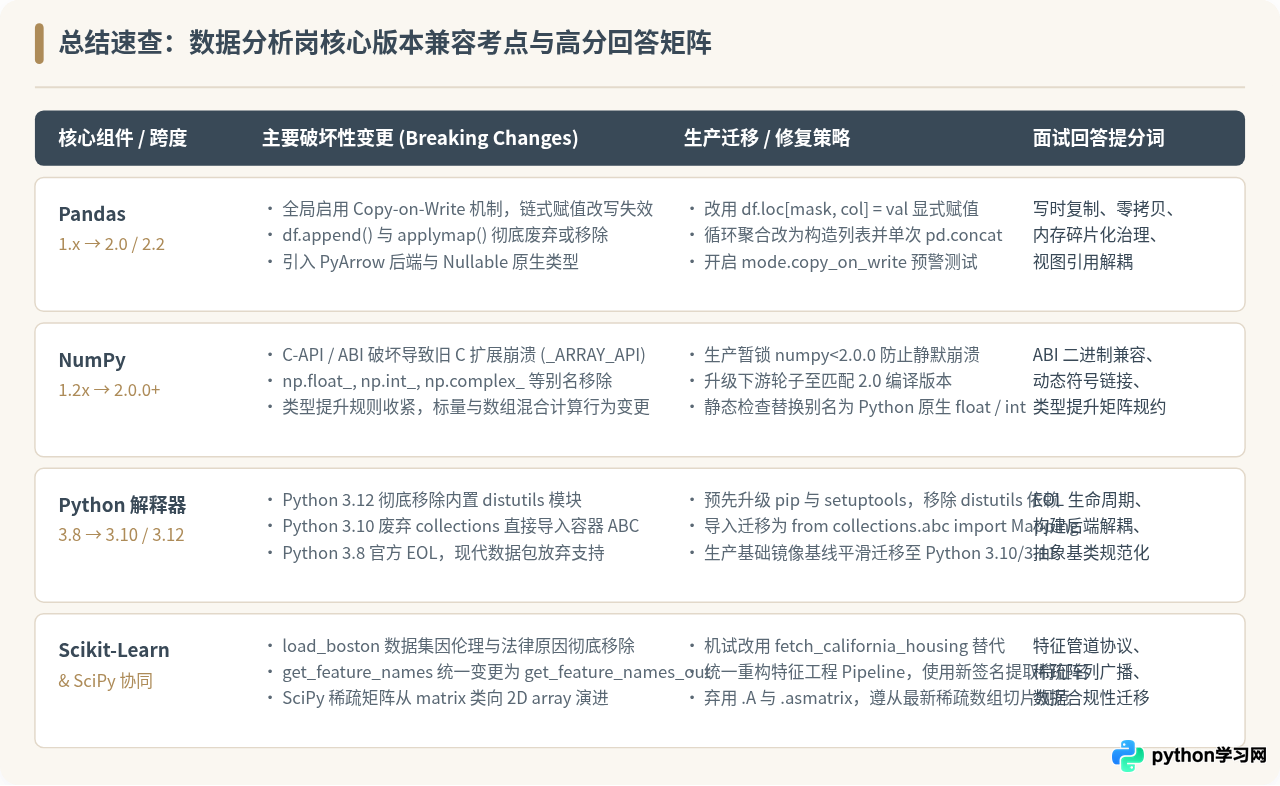
六、面试常考版本兼容全景速查矩阵
为便于系统复习与面试临场快速提取关键词,下表将本文涵盖的四大关键组件、典型破坏性特征、生产解决策略以及高分作答关键词整理成完整速查矩阵。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









