

Python 3在线编辑器运行超时怎么办?
详细解析Python 3在线编辑器出现运行超时(Time Limit Exceeded)的核心原因,提供从input阻塞排查、死循环修复、算法复杂度优化到运行环境选型的系统解决指南。
在网页端使用 Python 3 在线编辑器运行代码时,最常遇到的报错提示往往是“Time Limit Exceeded”(超过最大运行时间)或“Execution Timed Out”(执行超时)。许多初学者在本地写好的代码,一复制到在线平台就直接卡死并报错。遇到这个问题时,无需慌张,通常只需要按部就班排查四大核心点:是否存在阻塞式 input() 输入、是否存在未终止的死循环、算法时间复杂度是否过高,以及测试数据量是否超出了在线沙箱的承载极限。本文将为您详细拆解在线编辑器的运行机制,并提供针对性的排查步骤与优化示例。
一、理解根源:在线编辑器为什么会限制运行时间?
在个人计算机上运行 Python 脚本时,只要不手动关闭窗口,程序可以运行几分钟甚至几天。但在线编辑器部署在云端服务器上,由成千上万名用户共享公共算力。如果不对每个代码进程施加时间与资源配额,一旦某位用户写出死循环,服务器的 CPU 与内存很快就会被消耗殆尽,导致整个平台瘫痪。
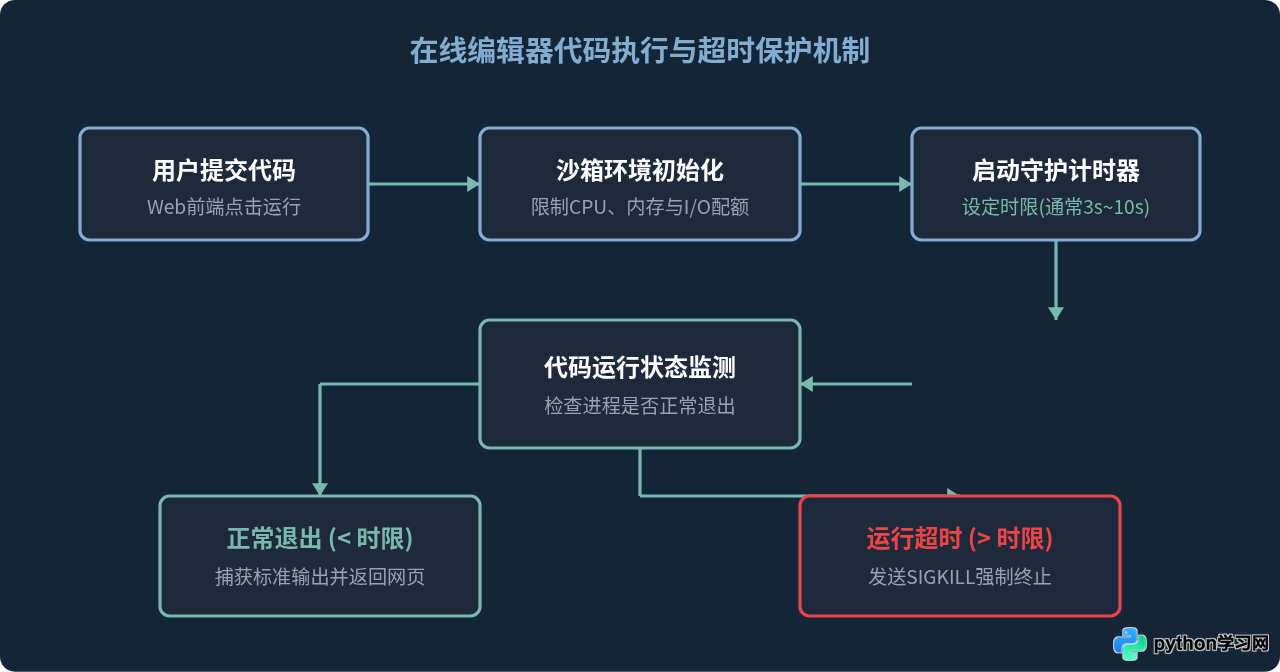
因此,在线编辑器通常会建立隔离的微型沙箱容器,并在后台配置看门狗守护进程(Watchdog Timer)。当用户点击“运行”按钮后,后台计时器立即启动。多数在线平台的单次执行时限设置在 3 秒到 10 秒 之间。一旦代码未能在预定时限内主动退出,沙箱就会强制向 Python 解释器发送终止信号(如 SIGKILL),并在网页端返回超时提示。
二、排查第一步:检查是否存在阻塞式输入函数 input()
这是造成在线运行超时最普遍、也是最容易被忽视的原因。很多在线编辑器采用的是单向批处理运行模式,而非全功能的交互式终端。当代码中调用 input("请输入数字:") 时,程序会挂起并等待标准输入流(stdin)。
由于前端页面并没有实时发送用户输入的通道,Python 进程就一直在等待键盘敲击,直到服务器的 5 秒或 10 秒倒计时结束,最终被系统强行当成死循环杀死。
input()。
解决办法:在调试代码逻辑时,把交互式输入替换为写死的变量值、列表或模拟数据。如下所示:
# 容易引起在线超时的写法(无交互终端时无限挂起等待)
# user_val = input("请输入测试数值:")
# result = int(user_val) * 2

# 推荐的在线调试写法(使用静态测试数据直接验证逻辑)
test_inputs = [10, 25, 40]
for val in test_inputs:
    result = val * 2
    print(f"输入: {val}, 计算结果: {result}")
三、排查第二步:审查死循环与递归基准条件
排除了输入挂起后,第二常见的原因是逻辑层面的死循环(Infinite Loop)。在 while 循环中,若没有在每轮迭代中正确递增步进变量,或者循环跳出条件永远为假,代码就会瞬间卡死并吃满单核 CPU。
1. 常见死循环陷阱:计数器未更新
# 错误示例:i 永远等于 0,循环永不终止导致超时
i = 0
total = 0
while i < 1000:
    total += i
    # 疏漏:忘记写 i += 1

# 正确示例:确保计数器更新且边界明确
i = 0
total = 0
while i < 1000:
    total += i
    i += 1
print("累加结果:", total)
2. 递归缺少基线条件(Base Case)
在编写递归函数(如斐波那契数列、二叉树遍历或深度优先搜索)时,若缺少基准终止条件,递归就会无限深陷,最终不仅可能触发递归深度超限,还会因极耗时而导致在线编辑器超时熔断。
# 错误示例:当 n 小于 1 时未能有效截断,形成无限递归
def countdown(n):
    if n == 0:  # 如果传入负数,此条件永远不满足
        return
    print(n)
    countdown(n - 1)

# 防御性写法:使用范围判断
def safe_countdown(n):
    if n <= 0:
        return
    print(n)
    safe_countdown(n - 1)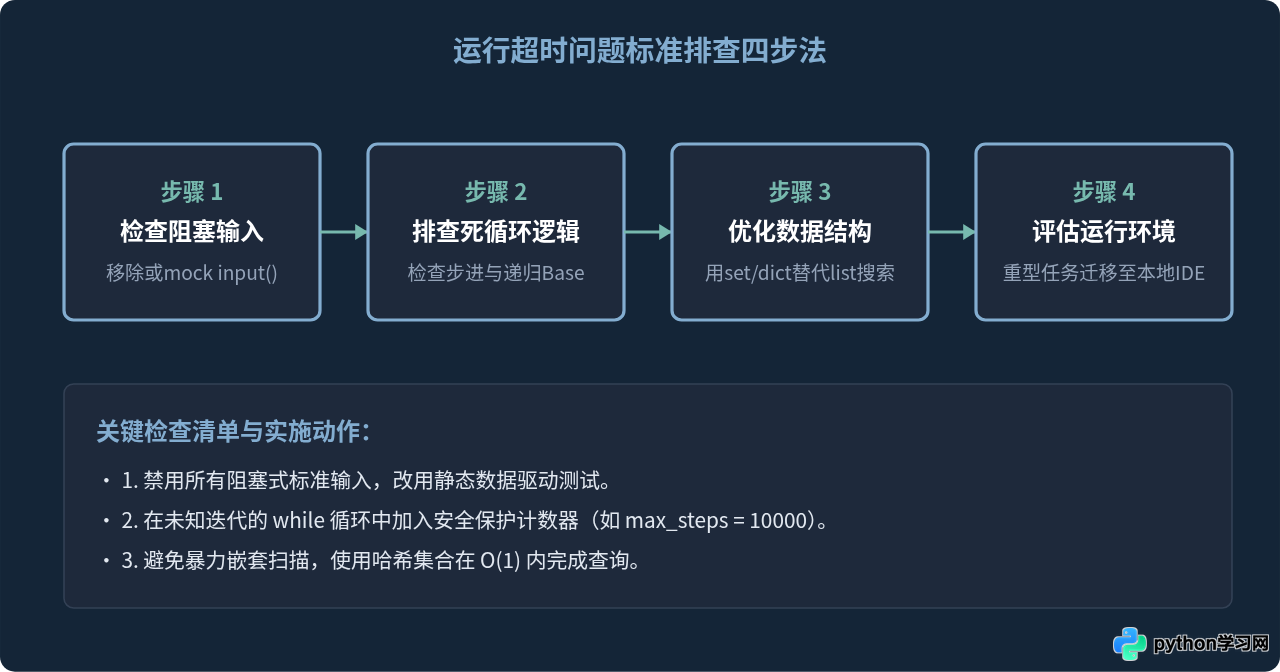
四、排查第三步:优化算法时间复杂度与数据结构
在编写刷题题解或批量处理数据时,代码逻辑完全正确,也没有死循环,但仍然报出超时。这种情况通常是因为代码的时间复杂度过高,随着数据量增大,所需计算步骤成倍甚至指数级爆炸。
1. 慎用列表的线性查找 in
在 Python 中,在 list 列表中使用 x in my_list 需要进行全列表线性遍历,平均时间复杂度为 O(N)。如果在循环体内重复执行列表查找,整个算法的时间复杂度就会恶化为 O(N²)。当 N 达到 5 万或 10 万时,在受限的在线服务器上耗时将长达十几秒,必然超时。
优化手段:将列表转换为基于哈希表实现的 set(集合)或 dict(字典),查找操作的平均时间复杂度将瞬间降低为 O(1)。
# 低效写法:双层循环,在列表中反复查找,复杂度为 O(N^2)
def find_common_slow(list_a, list_b):
    common = []
    for item in list_a:
        if item in list_b:  # 每次都在 list 中进行 O(N) 线性遍历
            common.append(item)
    return common

# 优化写法:将 list_b 转为集合,单次查找降为 O(1),总复杂度 O(N)
def find_common_fast(list_a, list_b):
    set_b = set(list_b)
    return [item for item in list_a if item in set_b]
2. 递归优化:利用记忆化避免重复计算
以朴素递归计算斐波那契数列为例,每多一层递归都会分裂成两个子分支,时间复杂度高达 O(2ⁿ)。计算 fib(35) 需要数十亿次调用,在任何在线平台上都会超时。使用标准库自带的 functools.lru_cache 即可缓存中间结果,将复杂度降为 O(N)。
from functools import lru_cache

# 开启记忆化缓存,避免重复计算相同子问题
@lru_cache(maxsize=None)
def fib(n):
    if n <= 1:
        return n
    return fib(n - 1) + fib(n - 2)

print(fib(50))  # 毫秒级即可瞬间得出正确结果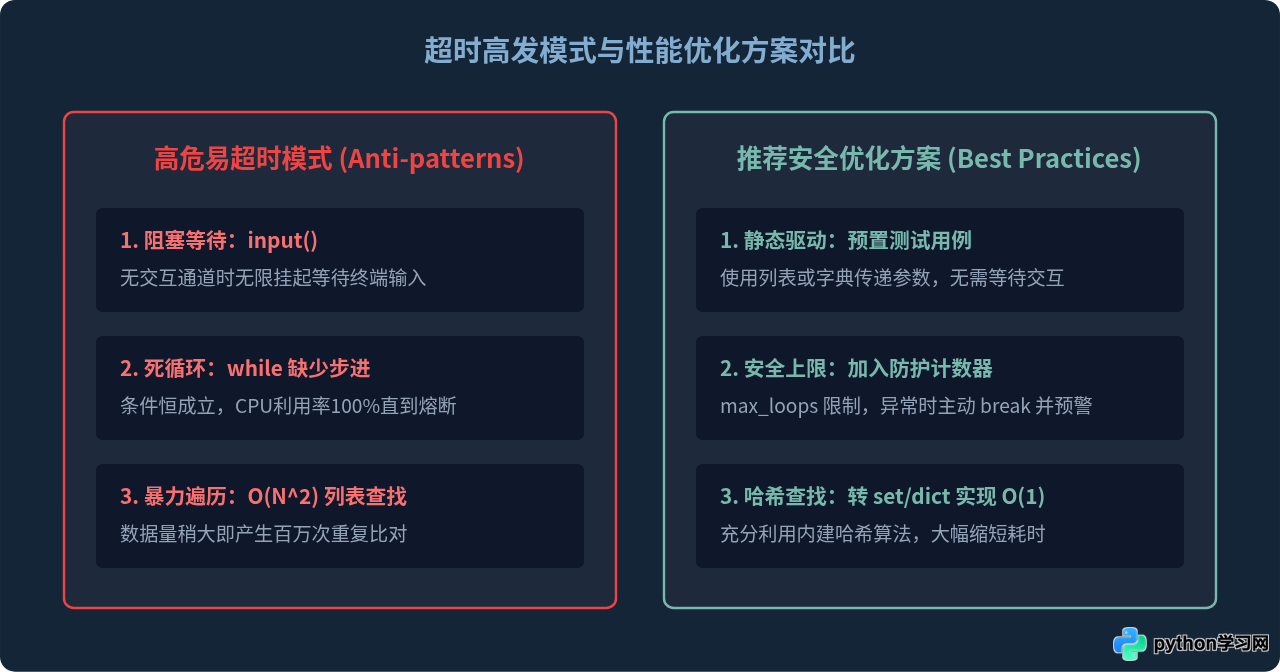
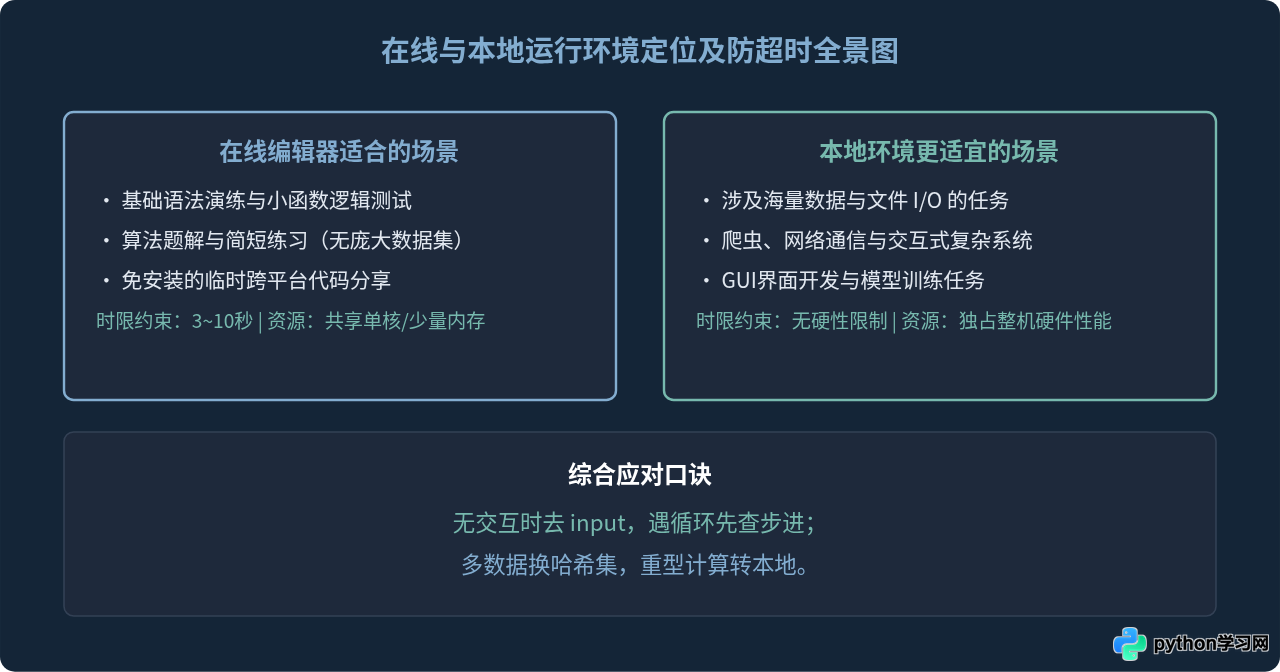
五、评估任务边界:什么时候应该切换到本地环境?
必须认识到,在线 Python 3 编辑器是用于碎片化验证、快速语法演示或基础算法练习的轻量化工具,绝非为生产环境或重型任务而设计。如果经过上述三步优化后代码依然超时,通常意味着该任务已经超出了在线沙箱的承载上限。
不适宜在在线编辑器中运行的任务场景:
- 大规模数据集处理:读取几百兆甚至数吉字节的 CSV、JSON 文件并做全局聚合。
- 网络爬虫与频繁网络请求:在线编辑器多半禁止外网访问,或对外网请求设置极短的 Socket 超时。
- 图形界面或游戏引擎:如
tkinter、pygame等需要本地图形桌面上下文的库。 - 密集机器学习或深度学习训练:缺乏 GPU 硬件加速,单核 CPU 往往无法在数秒内完成矩阵训练。
当面对上述需求时,最稳妥的解决方案是安装本地的 Python 3 解释器(搭配 VS Code、PyCharm 或 Jupyter Notebook),利用本地电脑的全部多核 CPU 与内存不受限制地完成长时间运行。
六、总结与实战自查清单
遇到 Python 3 在线编辑器运行超时时,请直接按照以下顺序进行快速自查:
- 全局搜索
input:检查代码中是否留有阻塞式标准输入语句。如果是,请换用硬编码列表或静态测试数据进行驱动。 - 核对每个
while与递归函数:确认计数器步进是否发生,递归是否包含有效退出分支;可在循环中加入安全保护计数器(如if loop_count > 10000: break)以判断是否深陷死循环。 - 审查耗时操作的数据结构:将循环内的
item in my_list改写为item in my_set,将高频字串拼接改为''.join(),使用@lru_cache避免重叠子问题递归。 - 缩减测试样本或迁移环境:将输入的数据量从 10000 缩减至 10 先验证逻辑正确性;如果是真正耗费算力的复杂项目,及时迁移至本地 Python 运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









