

Python字符串切片语法详解:[start:stop:step]参数含义与默认值
全面解析Python字符串切片核心语法[start:stop:step],详细阐述起始位置、终止位置与步长的参数含义、缺省默认值计算规则、正负索引双向机制与典型实战避坑技巧。
在 Python 中截取字符串子串最常用且优雅的手段是切片(Slicing)。其完整语法格式为 s[start:stop:step],核心运算机制可概括为两个基本准则:“左闭右开区间”与“步长决定扫描方向”。通过指定起点、终点和步进跨度,开发者能够以常数级的简洁语法完成子串提取、等距采样和字符串逆序。理解切片不仅需要掌握三个参数的具体含义,更要理清当参数被省略时解释器的隐式补齐法则,从而避免边界偏移与方向冲突。
一、基础定位机制:双向索引与半开区间
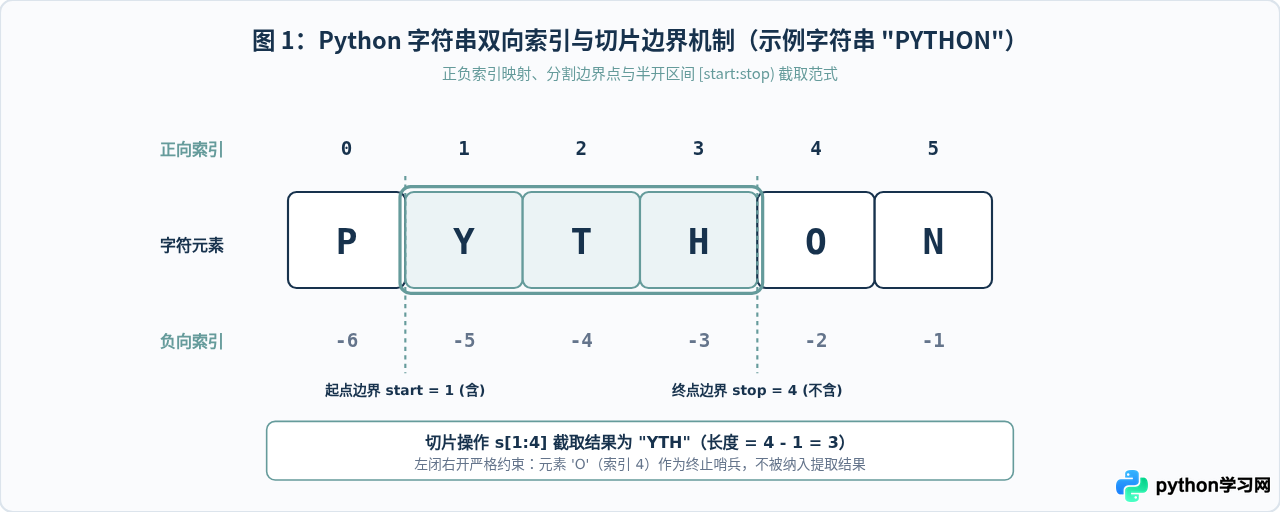
在深入三个参数前,首先需要理解 Python 字符串的双向索引系统与切片边界模型。Python 的字符串是不可变序列,其每个字符同时拥有两种坐标:从左至右由 0 递增的正向索引,以及从右至左由 -1 递减的负向索引。
更为关键的是切片的截取边界。切片区间始终遵循数学上的半开区间 [start, stop),即截取结果包含索引为 start 的字符,但严格排除索引为 stop 的字符。这一设计带来的直接便利是:截取子串的长度恰好等于两边界之差 stop - start(当步长为 1 时),并且连续相邻切片 s[:k] 和 s[k:] 可以无缝拼接还原原字符串。
二、三个核心参数 [start:stop:step] 语义详解
切片表达式方括号内以冒号分隔的三个参数,分别控制着切片的位置范围与采样节奏:
start(起始索引):切片截取的起点。若该位置在有效范围内,对应字符将被包含在切片结果中。stop(终止索引):切片截取的终点哨兵。截取过程在到达该索引位置之前停止,该位置对应的字符绝不包含在结果中。step(步长与步进方向):每次采样的位置增量,决定了索引推进的跨度与方向。- 步长的绝对值
|step|:表示索引跳跃的幅度。例如step=2表示隔一个字符取一个。 - 步长的符号:正号(
+)表示从左向右正向推进;负号(-)表示从右向左反向推进。 - 重要约束:
step必须是非零整数。若将step设置为0,Python 将直接抛出ValueError: slice step cannot be zero。
- 步长的绝对值
三、默认值计算法则:正负步长分流机制
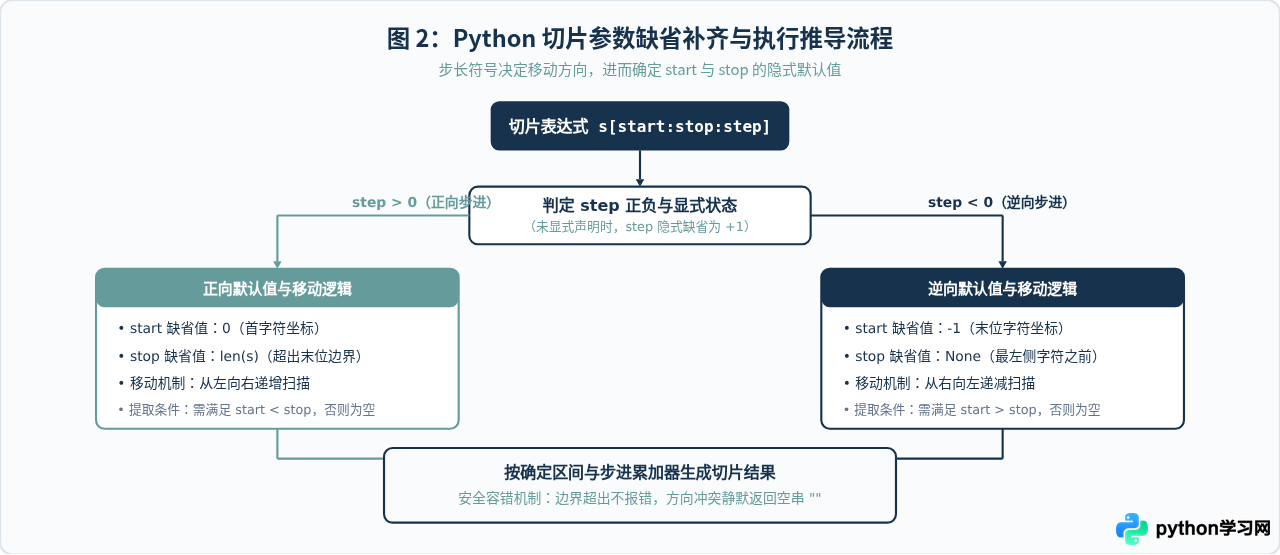
在日常开发中,三个参数往往并非全部填写。当某个参数被省略时,Python 解释器并非使用固定常量填补,而是依据步长 step 的正负号采取分流补齐机制:
1. 当 step > 0 或未指定(默认为 +1)时:搜索方向从左向右。start 缺省为 0(字符串开头),stop 缺省为 len(s)(字符串末尾之后)。
2. 当 step < 0 时:搜索方向从右向左。start 缺省为 -1(最后一个字符),stop 缺省为字符串最左端之前的哨兵位置(覆盖到首字符 index 0)。
四、常见切片模式与代码示例
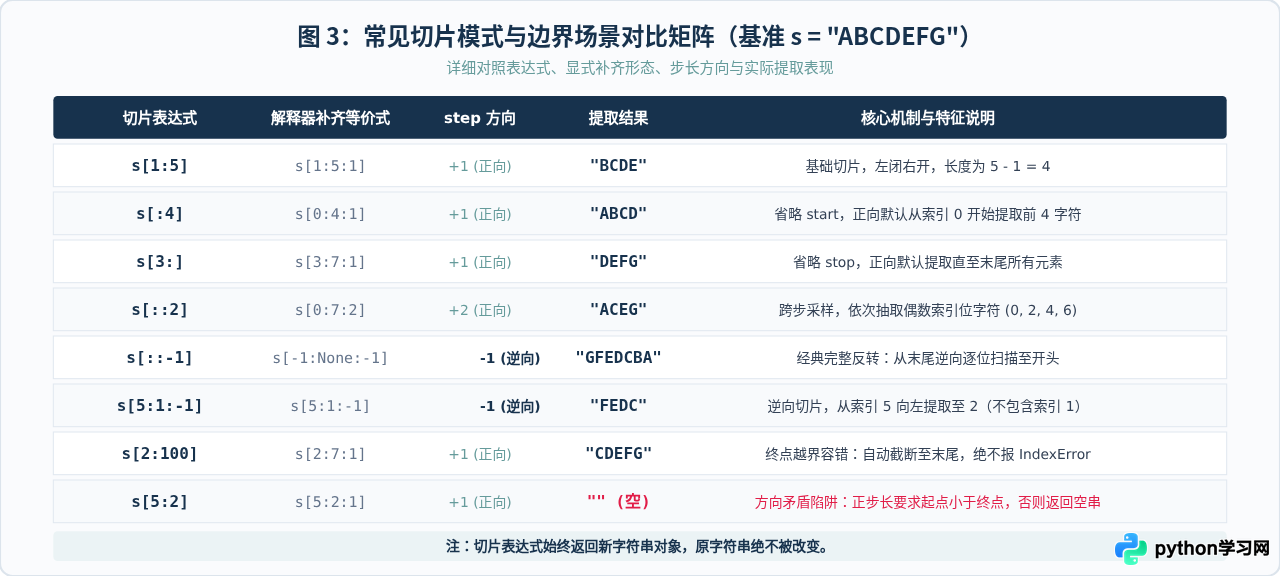
为了让上述规则更加直观,我们以字符串 s = "ABCDEFG"(长度为 7,有效正向索引 0~6)为例,对照常见切片语法的求值过程。
1. 省略单侧边界的常规提取
当只需要截取前缀或后缀时,可省略其中一个边界:
s = "ABCDEFG"

# 截取前 4 个字符(等价于 s[0:4:1])
print(s[:4])   # 输出: ABCD

# 从索引 3 截取到末尾(等价于 s[3:7:1])
print(s[3:])   # 输出: DEFG

# 省略全部三个参数,生成完整浅拷贝
print(s[:])    # 输出: ABCDEFG
2. 指定步长的跳跃提取
当步长大于 1 时,解释器按照固定间隔跳过元素:
s = "ABCDEFG"

# 提取偶数索引位字符:索引 0, 2, 4, 6
print(s[::2])    # 输出: ACEG

# 提取奇数索引位字符:索引 1, 3, 5
print(s[1::2])   # 输出: BDF
3. 经典逆序切片:s[::-1] 的运作原理
s[::-1] 是 Python 中反转字符串的惯用写法。很多初学者只记住了写法,却不清楚其内在推导逻辑:
- 首先检查步长:
step = -1 < 0,因此触发逆向分流规则。 - 补齐默认值:
start省略,自动补齐为-1(指向末尾字符"G");stop省略,自动补齐为最左端字符之前。 - 执行循环:从
-1开始每次递减 1,依次采集"G", "F", "E", "D", "C", "B", "A",从而得到完全反转的字符串。
五、避坑指南:切片安全容错与高频易错点
虽然切片语法直观,但在实际应用中仍有几个极易产生逻辑混淆的场景:
1. 切片越界容错 vs 索引访问越界
在 Python 中直接通过索引访问单个字符(如 s[100])时,如果索引超出范围,解释器会立即抛出 IndexError: string index out of range。但切片操作具有内置的容错截断机制:无论传入多么离谱的 start 或 stop,Python 都会自动将其约束在有效边界 [0, len(s)] 之内,安全截断而不抛出任何异常。
s = "Python"

# 单索引越界:直接抛出异常
# print(s[10])  # IndexError: string index out of range

# 切片越界:自动截断至末尾,安全返回
print(s[2:100])  # 输出: thon

# 起点与终点均超出右侧:安全返回空字符串
print(s[20:30])  # 输出: ""
2. 方向矛盾导致的“静默空串”
最隐蔽的错误是起止点与步长方向发生冲突。由于 Python 切片容错性极高,当发生方向矛盾时它不会报错,而是静默返回空字符串 ""。这往往导致后续逻辑拿到了意外的空数据却未产生报警:
s[5:2]:步长默认为+1(向右搜索),但起始点5已经位于终点2的右侧,向右前进无法到达2,因此返回""。若要逆向提取,必须显式指明负步长:s[5:2:-1]。s[1:5:-1]:步长为-1(向左搜索),但起点1位于终点5的左侧,向左前进永远无法到达5,同样返回""。
3. 负索引混合切片的边界判定
当正负索引混合出现时(例如 s[1:-1]),建议先将负索引换算为等价的正向索引(正向索引 = 负向索引 + len(s)),再依照左闭右开区间进行提取:
s = "abcdef"  # len(s) = 6

# -1 等价于 6 + (-1) = 5
# s[1:-1] 相当于 s[1:5],截取索引 1 到 4(即去除首尾字符)
print(s[1:-1])  # 输出: bcde
六、切片全景规则与速查总结
掌握 Python 字符串切片,本质上是建立“坐标定位”与“步长推进”的清晰心智模型。以下总结图将三大参数定义、缺省值分流机制与避坑要点整合为全景速查知识网:
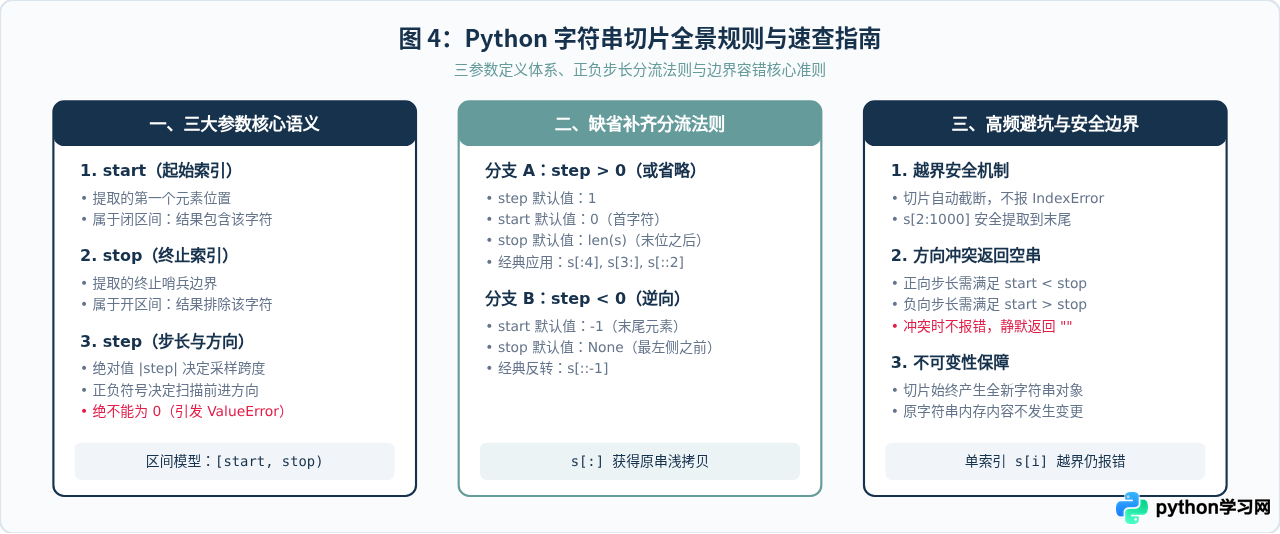
切片是 Python 序列处理中最具表现力的语法特性之一。只要牢记“左闭右开、步长定方向、负步长反转补齐”这三条基本铁律,就能从容写出精确、健壮且符合 Pythonic 风格的代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









