

Python执行速度慢会影响人工智能训练吗?底层加速机制解析
深入解析Python在人工智能与深度学习训练中的角色、底层C++/CUDA加速机制、异步发射流水线以及避免Python成为训练性能瓶颈的优化实践。
一、认知澄清:为什么运行缓慢的 Python 却成为 AI 的首选?
Python 在传统计算机基准测试中,由于解释型语言机制、动态类型系统以及全局解释器锁(GIL)的存在,其执行纯 CPU 计算密集型任务(例如大型嵌套循环或原生数值迭代)的耗时通常是 C/C++ 或 Rust 的数十倍甚至上百倍。这种性能特征常让初学者产生疑问:既然人工智能模型训练需要消耗海量算力,为什么大家还要普遍使用 Python?
要理解这个矛盾,必须区分计算的表达与计算的执行。在深度学习场景中,代码的主要逻辑不是在 Python 虚拟机中一个个遍历浮点数相加,而是定义神经网络的层级关系,并批量调用高维张量(Tensor)运算。Python 在此过程中的实际工作仅仅是“传达指令”,真正的密集运算发生在高带宽内存与上万个并行流处理器之间。
二、架构解耦:Python 前端调度与底层 C++/CUDA 的分工
以目前学术界与工业界最主流的 PyTorch 为例,整个软件栈具有高度清晰的分层体系结构。Python 代码执行时,并不承担具体的代数运算,而是通过轻量级绑定接口将计算任务分派给底层的 native 引擎。
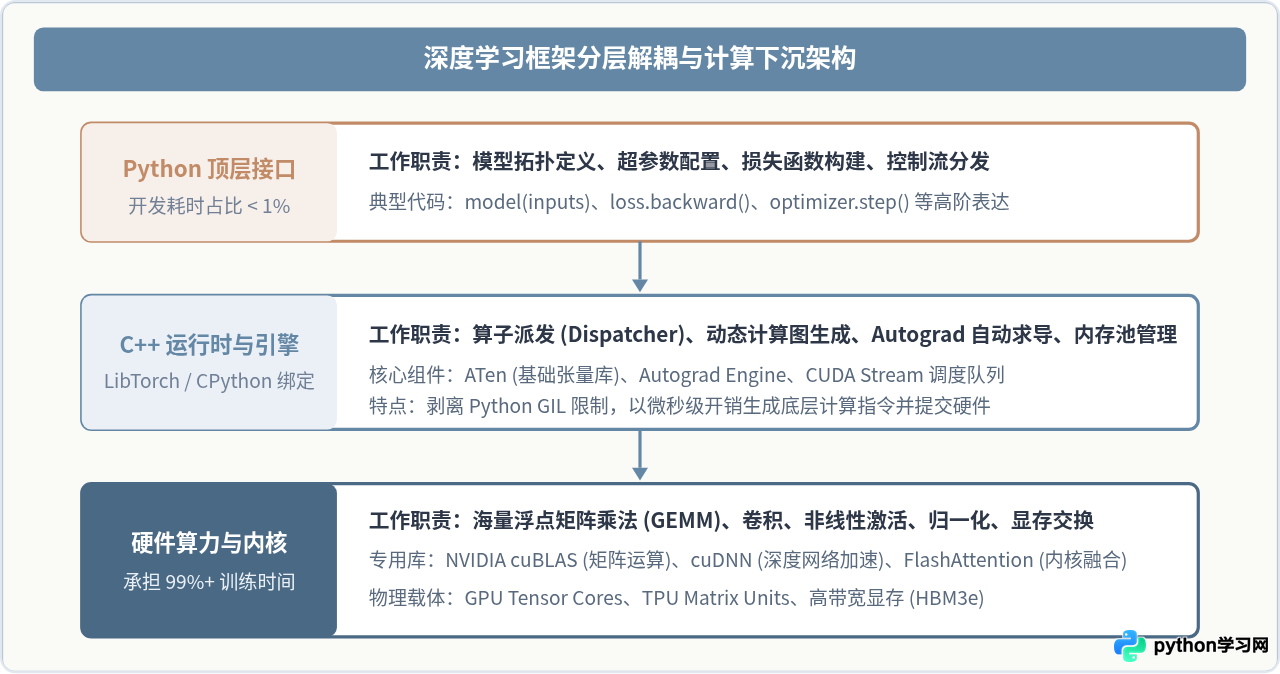
从上述架构可以看出,当编写 c = a @ b(矩阵乘法)时,Python 代码仅仅执行了两个基本动作:
- 在 Python 堆中检查
a和b的形状(Shape)与数据类型(Dtype); - 通过 C API 直接调用底层 C++ 编写的算子分发器,将运算任务传递给底层硬件(例如调用
cublasGemmEx)。
在这一调用链中,Python 解释器自身的执行时间通常在微秒(µs)级别,而 GPU 执行两个大型矩阵的乘法则需要数毫秒(ms)到数十毫秒。Python 消耗的这一极小片段时间在宏观计算时间面前基本可以忽略不计。
三、底层机制:异步执行与计算流水线重叠
如果 CPU 上的 Python 每次发射一个指令后,都必须停下来等待 GPU 运算完成才继续执行下一行代码,那么 CPU 与 GPU 之间的串行上下文切换仍会导致显著的延迟停顿。现代深度学习框架解决这一问题的核心机制是异步执行(Asynchronous Execution)。
在 PyTorch 中,所有 GPU 操作默认都是非阻塞异步的。当 Python 解释器执行到前向传播、损失函数计算或反向传播时,CPU 上的 Python 线程并不会被挂起,而是将待执行的 GPU 内核(CUDA Kernel)压入预先建立的 CUDA Stream(任务队列) 中,随后立即返回并继续解析后续代码。
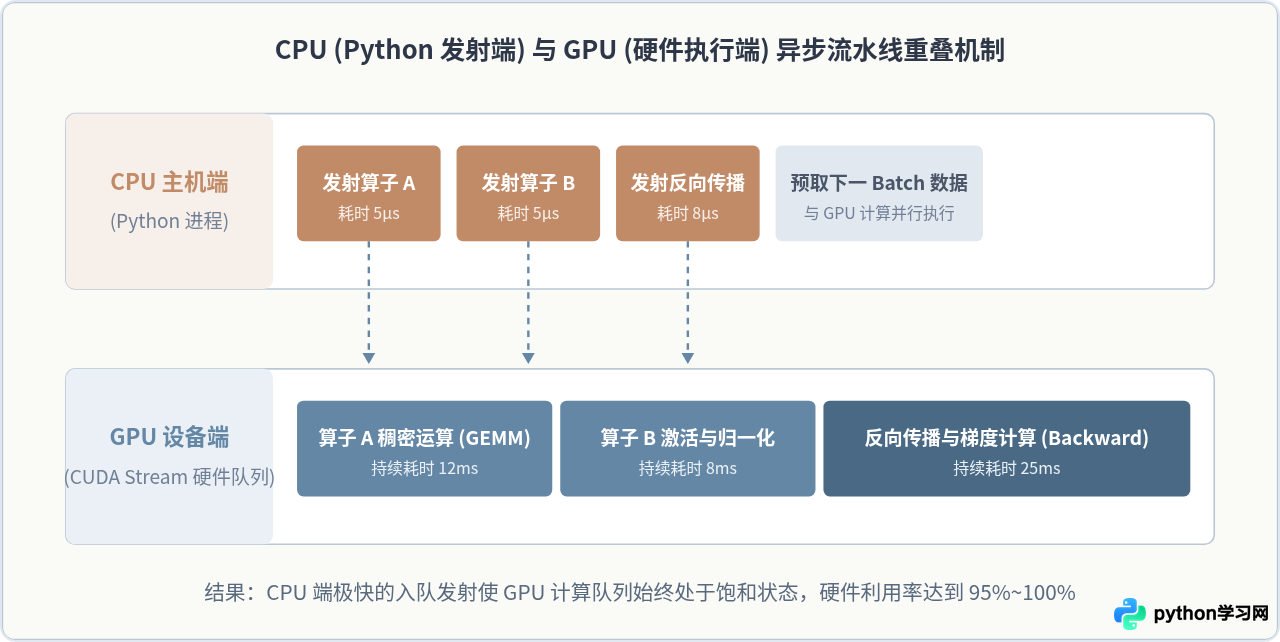
在这种架构下:
- CPU 端的 Python 是生产者:它以微秒级的速度在内存中将一连串计算命令放入 CUDA 硬件队列中。发射完毕后,CPU 可以自由执行数据加载或下一迭代的准备工作。
- GPU 是消费者:硬件根据队列自主排队执行,完全不等待 Python 的单行解释,GPU 的算力单元被连续的矩阵任务填满。
因此,只要 Python 生产指令的速度高于 GPU 消化指令的速度,计算性能就完全由 GPU 算力决定,Python 的所谓“低速”在此处对总训练时长没有任何负面影响。
四、现代编译器优化:TorchDynamo 与算子融合消减解释开销
在过去,如果模型结构中包含大量微小的算子(例如连续的加法、切片或逐元素运算),Python 频繁触发底层调用的启动开销(Kernel Launch Overhead)确实可能引起流水线抖动。为了彻底根除这一瓶颈,PyTorch 2.0 引入了以 TorchDynamo 和 TorchInductor 为核心的图编译器生态。
# 传统动态执行模式:每一行都经过 Python 解释与独立内核发射
import torch

def model_step(x, w1, b1, w2, b2):
    h = torch.relu(x @ w1 + b1)
    out = h @ w2 + b2
    return out

# 现代编译优化模式:一键捕获计算图并融合算子
compiled_step = torch.compile(model_step)
# 底层将矩阵乘、偏置相加与 ReLU 融合成单一定制 GPU 内核,消除中间内存读写与 Python 重复调用
通过 torch.compile,Python 解释器在初次运行时利用字节码分析拦截技术,直接抓取模型计算的完整有向无环图(DAG),并将其转交给编译后端生成高效的 Triton/C++ 代码。在后续训练迭代中,Python 代码相当于直接执行一个高度融合的单一硬件可执行块,连 Python 层的微秒级调度开销都被进一步消解。
五、边界场景分析:Python 什么时候会真正拖慢 AI 训练?
虽然 Python 的底层加速机制非常完备,但在实际工程实践中,由于编写规范不当,开发者仍然可能把 Python 写成整个系统的“性能瓶颈点”。以下是三种最常见的致慢陷阱及其解决思路:
| 瓶颈类型 | 代码表现与成因 | 负面后果 | 正规优化方案 |
|---|---|---|---|
| 数据加载阻塞 (I/O & GIL) | DataLoader 使用单进程(num_workers=0),在主进程中用 Python 逐张解码高分辨率图像或分词。 | GPU 算力跑完当前 Batch 后被迫等待 CPU 喂数据,GPU 利用率剧烈掉落至 10%~30%。 | 设置 num_workers > 0,启用 pin_memory=True,使用 Albumentations 或 DALI 等 C++ 加速预处理。 |
| 破坏异步流水线 (频繁同步) | 在训练循环内部频繁调用 loss.item()、tensor.cpu() 或打印中间张量。 |
.item() 会强行触发 cudaDeviceSynchronize(),强制 GPU 停顿等待 CPU 拿回标量值。 |
只在记录日志的周期(如每 100 步)拉取一次标量,或使用异步 TensorBoard/WandB 钩子。 |
| Python 原生循环操作细粒度张量 | 使用 Python 的 for 循环逐个元素更新张量或逐个特征向量计算距离。 |
频繁触发成千上万次微小 Kernel Launch,启动开销(Launch Overhead)远超实际计算量。 | 坚持张量向量化(Vectorization)操作,利用广播机制(Broadcasting)或 torch.compile 自动融合。 |
# 错误示例:每个 batch 强制同步,击碎流水线
for batch_idx, (data, target) in enumerate(dataloader):
    output = model(data.cuda())
    loss = criterion(output, target.cuda())
    loss.backward()
    optimizer.step()
    # 严重降速!.item() 会强制 CPU 阻塞直到 GPU 算完当前 batch,GPU 无法重叠发射下一轮任务
    print(f"Batch {batch_idx}: Loss = {loss.item()}")

# 正确示例:保持异步,降低同步频率
total_loss = 0.0
for batch_idx, (data, target) in enumerate(dataloader):
    output = model(data.cuda())
    loss = criterion(output, target.cuda())
    loss.backward()
    optimizer.step()
    # 使用张量原地累加,保持在 GPU 上
    total_loss += loss.detach()
    if batch_idx % 100 == 0:
        # 仅在打点日志时进行一次标量同步
        print(f"Step {batch_idx}: Loss = {(total_loss / 100).item()}")
        total_loss = 0.0
六、排查与诊断指南:如何确认你的训练是否被 Python 卡住?
当我们在实际集群或本地机器上遇到模型训练速度不理想的情况时,不要盲目将问题归咎于 Python 语言,而应当按照标准工程步骤进行定点排查。
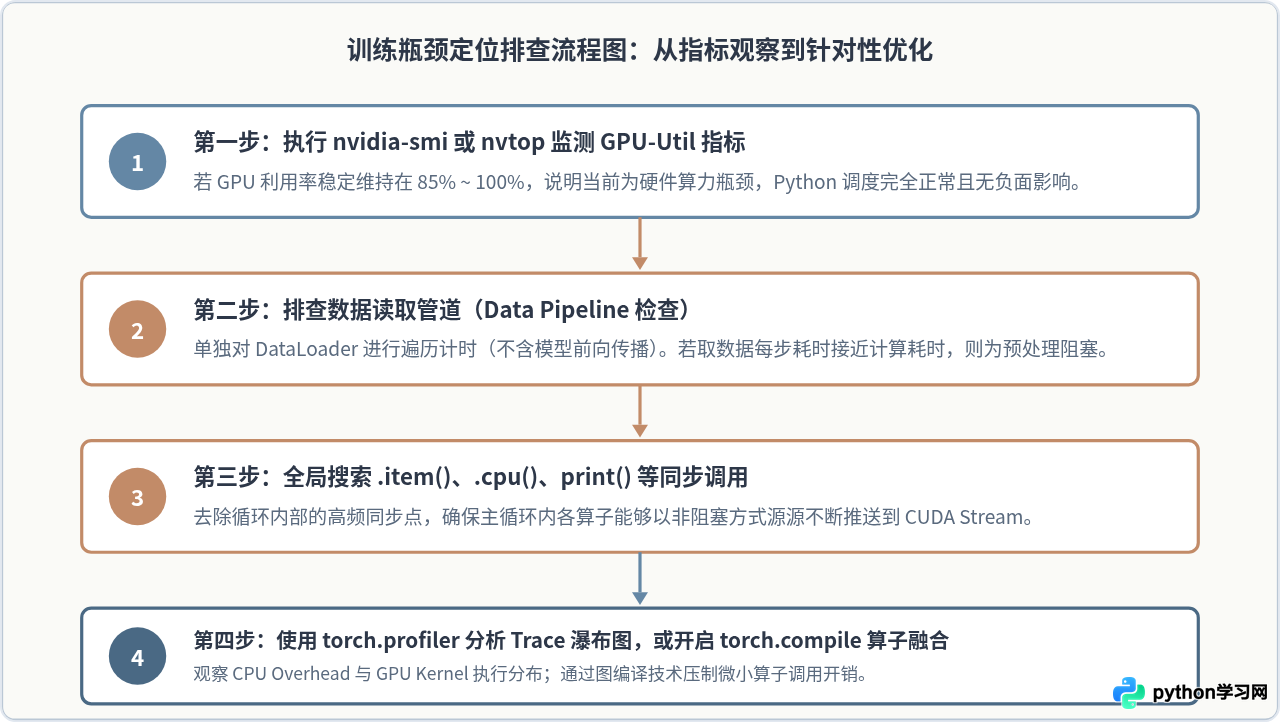
七、全景总结:现代深度学习底层加速体系
综上所述,评价 Python 对人工智能训练的影响,不能脱离“软硬件协同体系”这一整体背景。Python 的慢是真实的,但深度学习系统的工程演进早已通过“语言分工”、“计算下沉”、“异步调度”与“图编译器融合”这四重防御机制,将 Python 的性能劣势完全隔离在计算密集区之外。
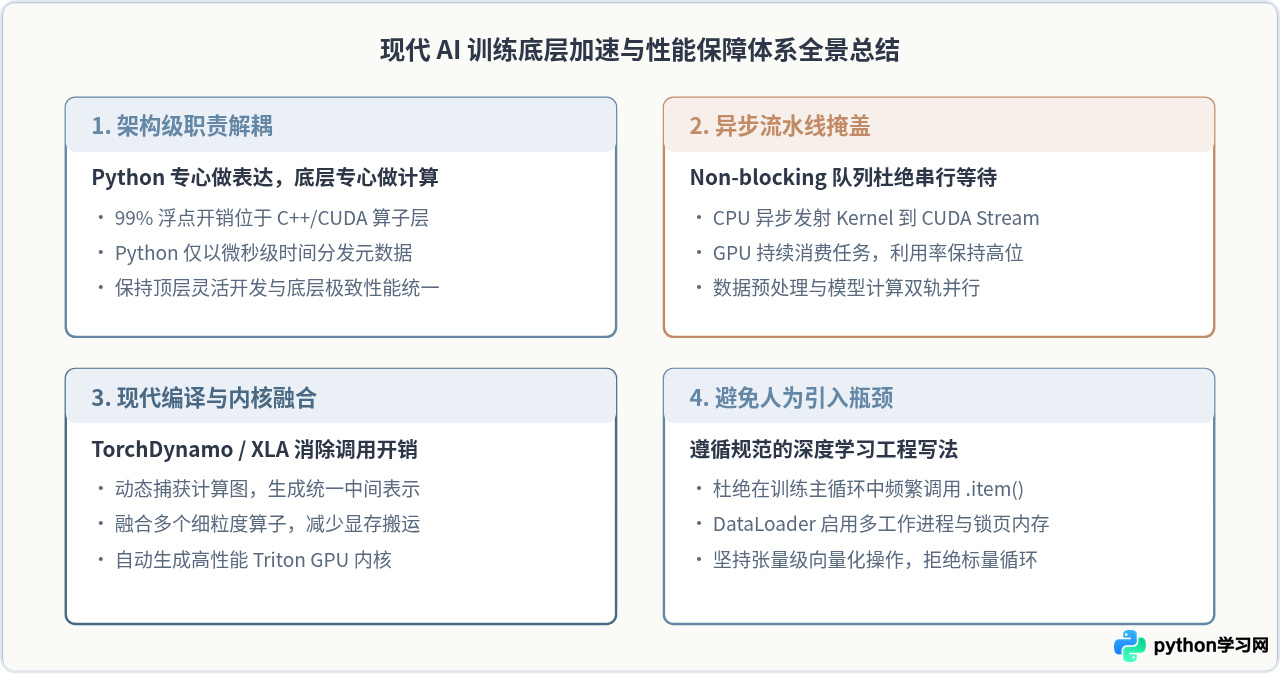
理解了这些机制,开发者就能更自信地利用 Python 丰富的生态和简洁的语法快速构思、试验算法,同时在遇到训练性能不足时,能够准确将精力聚焦在数据管道并发与硬件流水线优化上,从根本上发挥现代 AI 算力硬件的极致性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









