

基于Python的电商销售数据分析案例实战
本案例通过Python对电商订单销售数据进行全流程实战分析,从原始数据加载、清洗排查、核心业务指标(GMV、客单价、转化率)统计,到RFM用户分群建模,提供完整的代码实现与业务解读。
面对业务系统导出的十万级电商订单明细,最直接的诉求是将离散的流水转化为经营结论。本文以一份标准电商零售交易数据为核心,从数据清洗、指标体系搭建到RFM用户分群建模,提供完整、可落地的Python实战方案,帮助读者掌握从数据输入到业务洞察的完整实现路径。
一、分析场景与业务目标界定
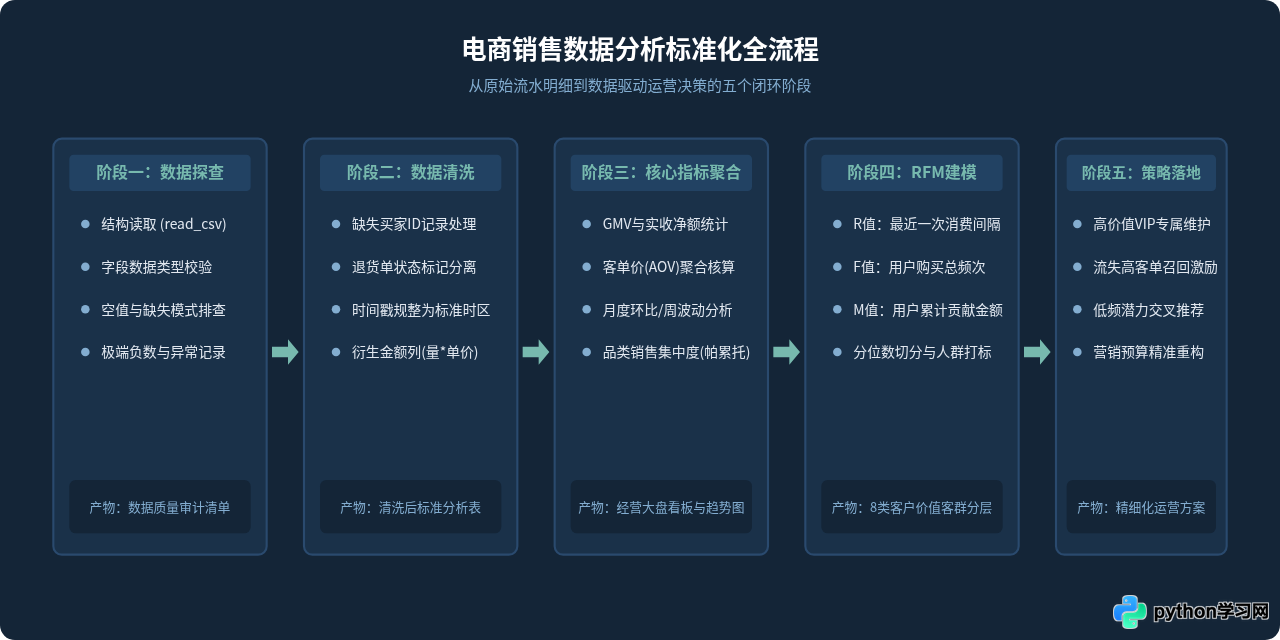
假设运营部门从数据库中导出了过去一整年的电商订单数据表 online_retail.csv。该数据集包含了每笔订单的购买时间、买家ID、商品货号、单价、购买数量以及订单履约状态。面对这些未加工的数据,我们需要回答四个核心经营问题:
- 销售大盘走势:全年的总成交额(GMV)、实际有效销售额与订单量在月份、周度上呈现怎样的波动周期?
- 品类与商品贡献:哪些商品贡献了80%的营收?是否存在退货率极高的异常爆款?
- 用户复购特征:用户的回购间隔是多长?一次性购买用户与高频忠诚用户的比例是多少?
- 用户价值细分:如何基于RFM模型划分高价值客户与流失风险客户,并针对性输出运营策略?
二、环境准备与原始数据探查
本项目依赖 Python 的核心数据分析与可视化库。推荐在 Python 3.9+ 环境中执行,首先确认环境依赖满足要求:
# 依赖环境确认
pip install pandas numpy matplotlib seaborn
在编写分析脚本前,我们先通过 Pandas 将原始文件载入内存,并查看数据的物理行数、字段类型以及非空计数:
import pandas as pd
import numpy as np

# 1. 加载数据
df = pd.read_csv('online_retail.csv', encoding='utf-8')

# 2. 检查字段信息与基础形状
print("数据基础维度 (行数, 列数):", df.shape)
print("\n字段信息总览:")
print(df.info())

# 3. 探查前5行样本
print("\n数据预览:")
print(df.head())
执行后通常会发现典型的数据质量问题:
CustomerID存在大量缺失,部分匿名下单用户缺少主键;InvoiceDate为字符串类型,需要解析为时间戳对象;Quantity和UnitPrice包含负值或为零,负值通常代表退货交易或手工冲账;InvoiceNo中以字符 "C" 开头的单据属于作废或退单标记。
三、数据清洗与规整实战
数据清洗的目标是将“业务系统的日志数据”提炼为“可进行商业统计的干净事实数据”。清洗逻辑必须保持业务口径的一致性,不能粗暴地剔除数据。
# 1. 过滤买家标识缺失的记录(若专门分析用户行为,需要剔除匿名客)
clean_df = df.dropna(subset=['CustomerID']).copy()
clean_df['CustomerID'] = clean_df['CustomerID'].astype(int).astype(str)

# 2. 区分正常销售单与取消/退货单
# 发票号以'C'开头为退单,Quantity为负数
clean_df['IsCancelled'] = clean_df['InvoiceNo'].str.startswith('C', na=False)

# 提取正向有效交易进行常规大盘与品类分析
sales_df = clean_df[(~clean_df['IsCancelled']) & (clean_df['Quantity'] > 0) & (clean_df['UnitPrice'] > 0)].copy()

# 3. 时间字段转换与衍生计算
sales_df['InvoiceDate'] = pd.to_datetime(sales_df['InvoiceDate'])
sales_df['TotalAmount'] = sales_df['Quantity'] * sales_df['UnitPrice']

# 衍生年月、周、小时维度
sales_df['YearMonth'] = sales_df['InvoiceDate'].dt.to_period('M')
sales_df['DayOfWeek'] = sales_df['InvoiceDate'].dt.day_name()
sales_df['Hour'] = sales_df['InvoiceDate'].dt.hour

print(f"清洗完成: 原始数据 {len(df)} 行,有效销售交易 {len(sales_df)} 行。")IsCancelled == True 的子集抽离做逆向流动分析。
四、核心销售指标统计与时序分析
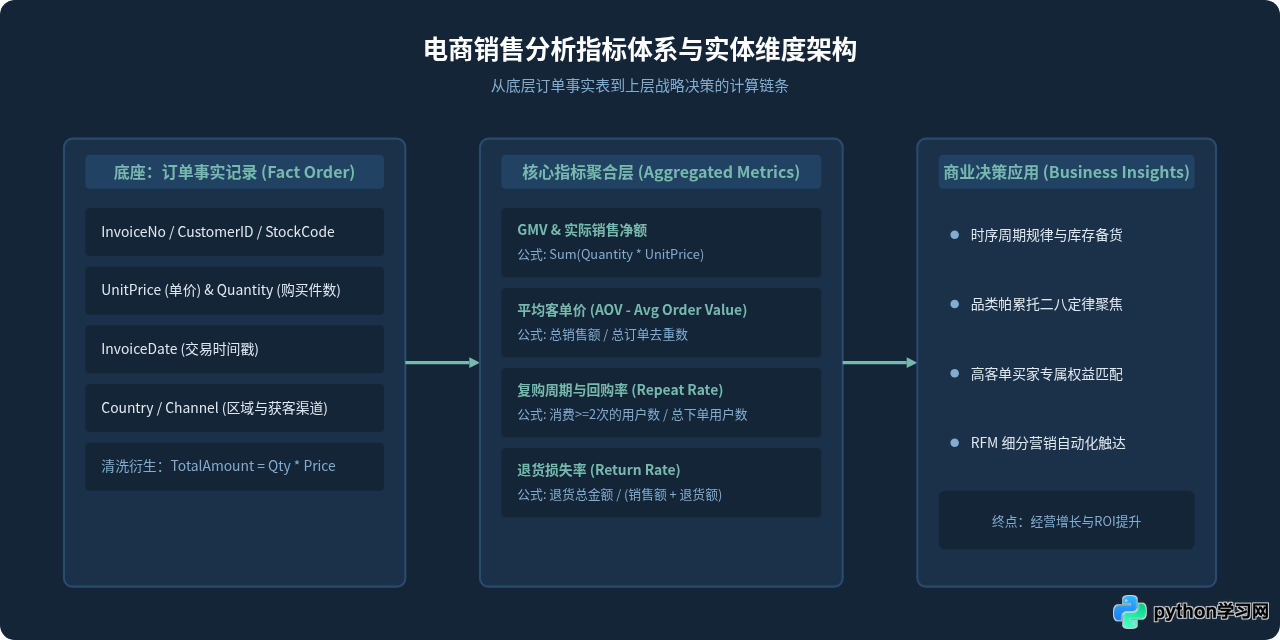
在数据规整后,我们首先计算电商业务中最核心的大盘指标:总营业额、订单量、独立买家数以及平均客单价(AOV)。
# 核心大盘指标汇总
total_sales = sales_df['TotalAmount'].sum()
total_orders = sales_df['InvoiceNo'].nunique()
total_customers = sales_df['CustomerID'].nunique()
aov = total_sales / total_orders

print("==== 电商销售大盘汇总 ====")
print(f"总销售额 (GMV): ¥{total_sales:,.2f}")
print(f"有效订单总量: {total_orders:,} 笔")
print(f"独立购买用户数: {total_customers:,} 人")
print(f"平均订单金额 (AOV): ¥{aov:.2f}")
1. 销售时序趋势分析
掌握销售额随月份与星期的波动规律,有助于合理规划营销节点与仓储库存:
# 月度销售额聚合
monthly_trend = sales_df.groupby('YearMonth')['TotalAmount'].agg(['sum', 'count']).reset_index()
monthly_trend.rename(columns={'sum': 'MonthlySales', 'count': 'OrderCount'}, inplace=True)

# 星期分布聚合(观察用户集中在工作日还是周末下单)
weekday_order = ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday', 'Saturday', 'Sunday']
weekday_trend = sales_df.groupby('DayOfWeek')['TotalAmount'].sum().reindex(weekday_order)

print("\n月度销售趋势前6个月:")
print(monthly_trend.head(6))
2. 商品品类集中度与头部贡献(帕累托分析)
在电商销售中,往往是20%的爆款商品贡献了80%的营业额。通过 Pandas 的累计占比计算可以验证这一集中度:
# 按商品货号聚合销售额
product_sales = sales_df.groupby(['StockCode', 'Description'])['TotalAmount'].sum().reset_index()
product_sales = product_sales.sort_values(by='TotalAmount', ascending=False)

# 计算累计销售额占比
product_sales['CumulativeSales'] = product_sales['TotalAmount'].cumsum()
product_sales['CumulativeRatio'] = product_sales['CumulativeSales'] / total_sales

# 统计贡献80%销售额的SKU数量
top_80_skus = product_sales[product_sales['CumulativeRatio'] <= 0.80]
print(f"总在售SKU数: {len(product_sales)},贡献80%业绩的核心SKU数: {len(top_80_skus)}")
print(f"核心商品占比: {len(top_80_skus) / len(product_sales) * 100:.2f}%")
五、RFM用户价值细分建模实战
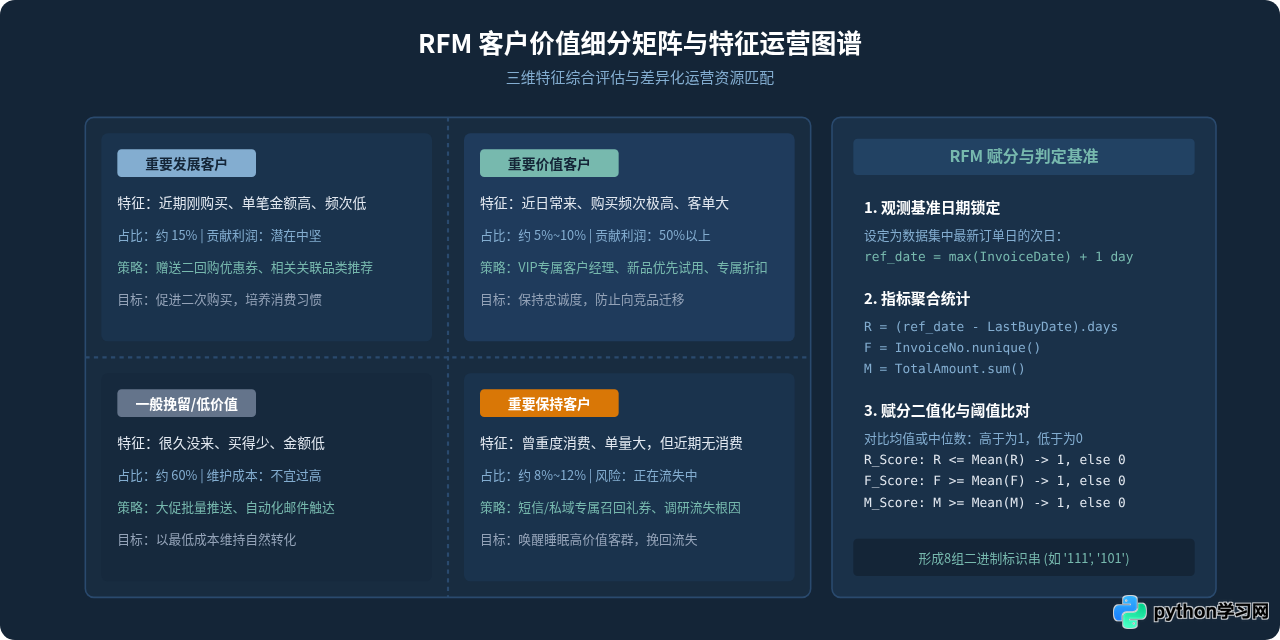
单纯观察大盘销售额只能看到过去的经营结果,若要实现未来的精细化运营,必须下钻到买家维度。RFM模型是电商用户价值分群最成熟的分析框架:
- Recency (R):最近一次消费距今天数。R越小,用户越活跃,召回成本越低;
- Frequency (F):统计周期内的消费频次。F越高,用户粘性与信任度越强;
- Monetary (M):统计周期内的累计消费金额。M越高,用户对营收的实质贡献越大。
1. RFM 特征提取代码实现
在 Python 中,以数据集中最后一次交易时间的次日作为基准观察日,聚合出每个买家的三大特征:
# 设定分析基准时间(以数据集中最新交易日的次日为基准)
reference_date = sales_df['InvoiceDate'].max() + pd.Timedelta(days=1)

# 按 CustomerID 聚合计算 R、F、M
rfm = sales_df.groupby('CustomerID').agg({
    'InvoiceDate': lambda x: (reference_date - x.max()).days, # R值: 最近一次距今天数
    'InvoiceNo': 'nunique',                                  # F值: 订单总频次
    'TotalAmount': 'sum'                                     # M值: 消费总金额
}).reset_index()

rfm.columns = ['CustomerID', 'Recency', 'Frequency', 'Monetary']
print("RFM 原始聚合数据样例:")
print(rfm.head())
2. 阈值比对与客户画像分层
针对各特征分布偏态的特点,通常采用中位数或行业业务经验值进行高低切分(赋分1表示优于基准,0表示劣于基准):
# 以均值作为划分阈值(实际业务中也可选用中位数或四分位数)
r_mean = rfm['Recency'].mean()
f_mean = rfm['Frequency'].mean()
m_mean = rfm['Monetary'].mean()

# R越小越好;F、M越大越好
rfm['R_Score'] = np.where(rfm['Recency'] <= r_mean, 1, 0)
rfm['F_Score'] = np.where(rfm['Frequency'] >= f_mean, 1, 0)
rfm['M_Score'] = np.where(rfm['Monetary'] >= m_mean, 1, 0)

# 组合三位评分代码
rfm['RFM_Code'] = (rfm['R_Score'].astype(str) +
                   rfm['F_Score'].astype(str) +
                   rfm['M_Score'].astype(str))

# 定义标签映射字典
segment_map = {
    '111': '重要价值客户',
    '011': '重要保持客户',
    '101': '重要发展客户',
    '001': '重要挽留客户',
    '110': '一般价值客户',
    '010': '一般保持客户',
    '100': '一般发展客户',
    '000': '潜在低价值客户'
}

rfm['CustomerSegment'] = rfm['RFM_Code'].map(segment_map)

# 汇总各类客户的人数与金额贡献
segment_summary = rfm.groupby('CustomerSegment').agg(
    CustomerCount=('CustomerID', 'count'),
    TotalRevenue=('Monetary', 'sum'),
    AvgRecency=('Recency', 'mean'),
    AvgFrequency=('Frequency', 'mean')
).reset_index()

segment_summary['RevenueShare'] = segment_summary['TotalRevenue'] / segment_summary['TotalRevenue'].sum()
print("\n==== RFM 客户分层经营统计 ====")
print(segment_summary.sort_values(by='TotalRevenue', ascending=False))
六、实战避坑与口径对齐规范
在电商销售分析的实际工程中,代码报错往往最容易解决,而口径不一致引发的逻辑偏差才最具破坏力。以下是高频出现的关键陷阱及规避方式:
| 问题维度 | 常见错误现象 | 标准排查与修复方法 |
|---|---|---|
| 时间戳时区 | 跨国电商数据未统一时区,导致月度切分重叠或大促当日数据归入次日。 | 在数据读取阶段统一使用 pd.to_datetime(..., utc=True) 转换为目标营业站点本地时区。 |
| 客单价计算 | 将“总销售额 / 购买总人数”误当成客单价,实际上那是“人均消费额(ARPU)”。 | 严格区分 AOV = 销售额 / 订单去重数 与 ARPU = 销售额 / 用户去重数。 |
| 退款对冲逻辑 | 将退款直接从各天明细中抹去,导致历史对账与银行流水对不上。 | 保留正向订单计算“销售毛额”,在当月以负向明细冲减产生“销售净额”,双指标并列呈现。 |
| RFM极值干扰 | 存在少数企业批发或刷单账户,极大拉高了均值,导致90%的真实买家被划为低价值。 | 在建模前排查 Monetary 的 99.5% 分位点,将批发大单账号单独归入“企业大客户”名单专项维护。 |
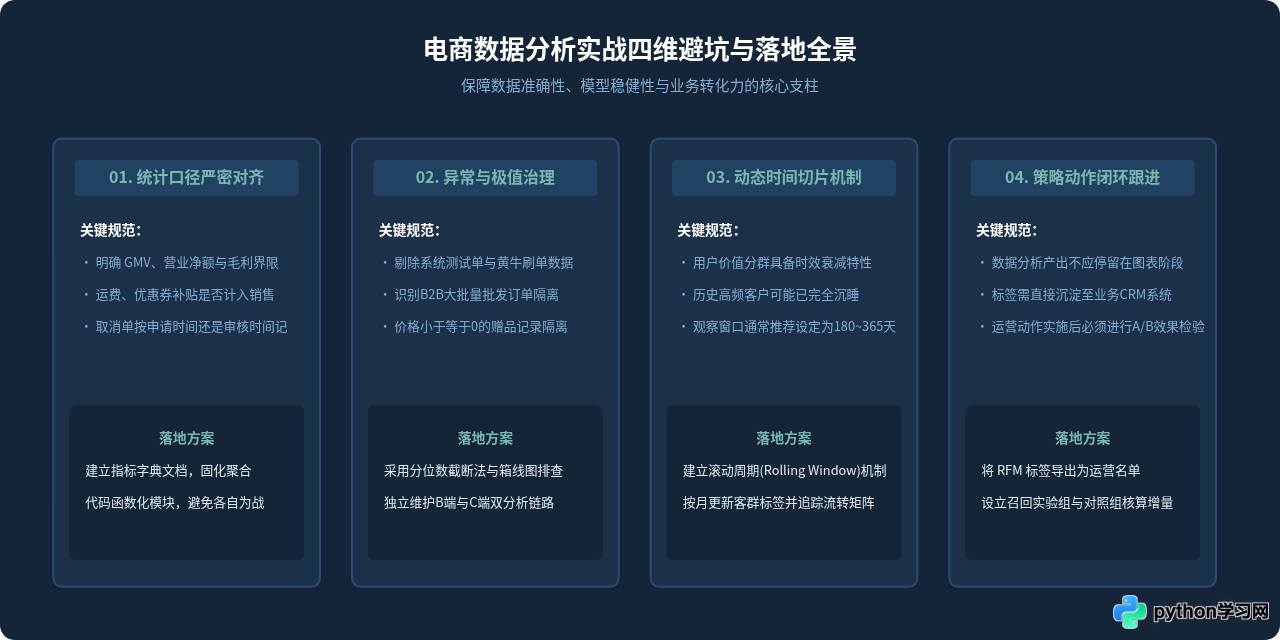
七、全流程总结
通过 Python 完成电商销售数据分析,本质上是把业务经营事实用代码转化为数字化决策抓手。一个完整的落地工程包含以下闭环步骤:
- 数据探查与清洗:使用 Pandas 校验字段类型,剔除无效退款、极端刷单记录与匿名噪音,构建严密的事实基础;
- 宏观大盘透视:计算 GMV、客单价与退货率,利用帕累托法则抓住贡献 80% 利润的头部爆款品类;
- 微观客群画像:构建 RFM 三维模型,将庞大的用户群切分为“重要价值”、“重要保持”等不同象限;
- 驱动精细运营:针对不同客群制定定制化营销方案,推动数据分析成果真正转化为商业收益。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









